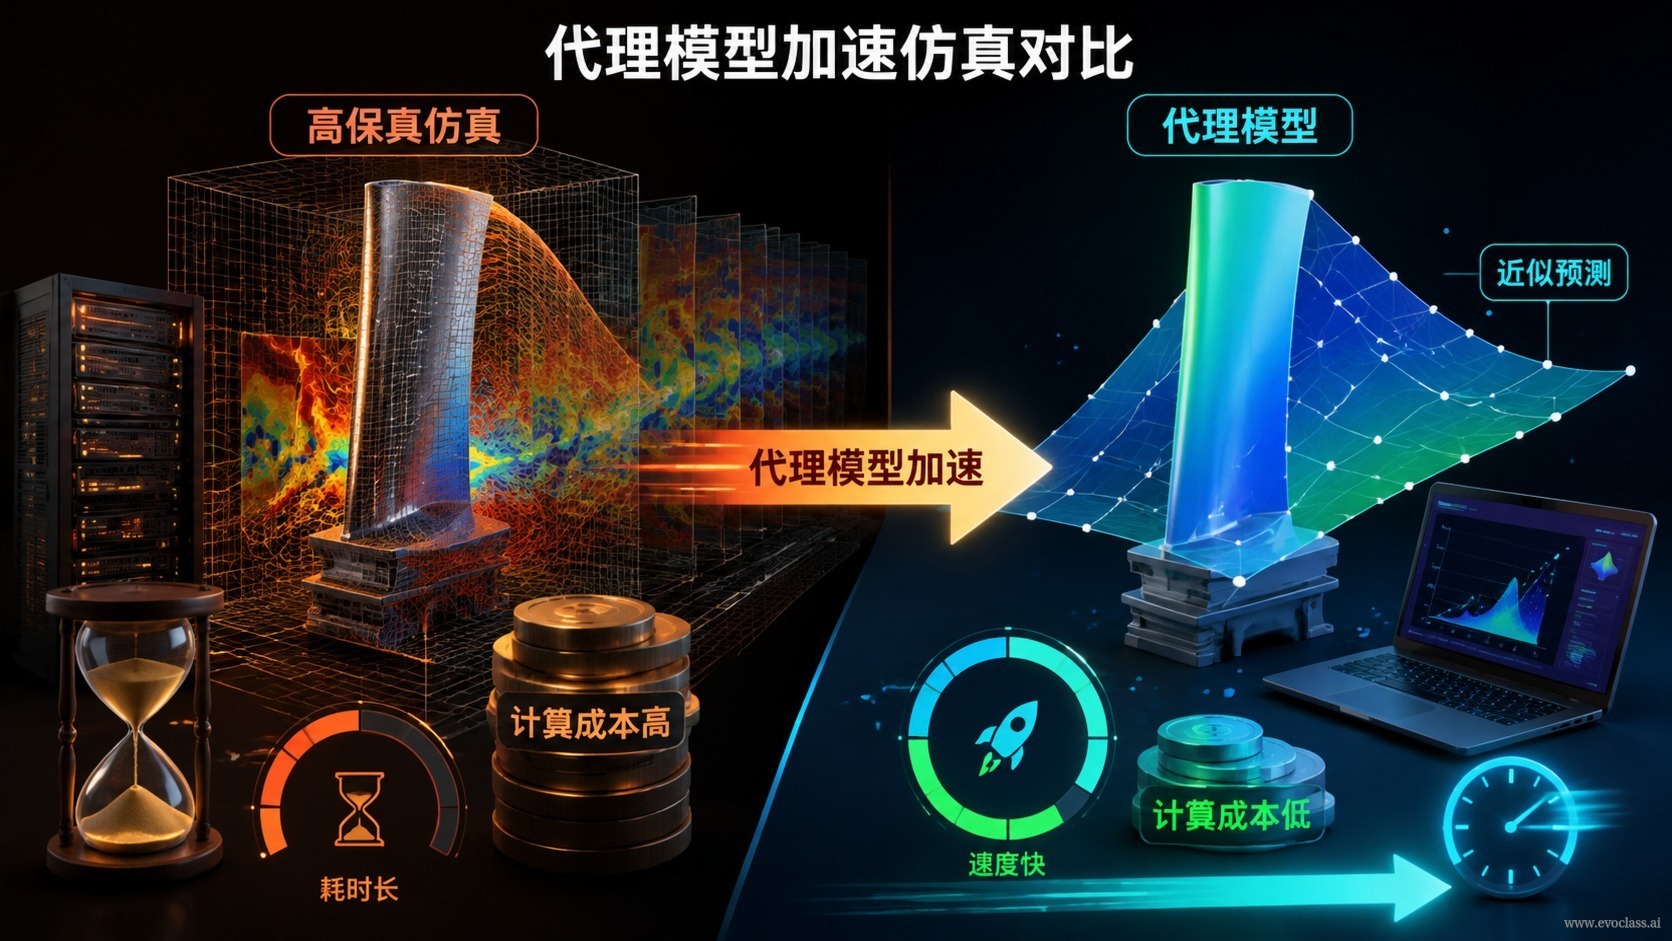
超臨界翼型などの複雑なエンジニアリング設計では、高忠実度シミュレーション(CFD、有限要素解析)の1回の評価には数十分から数時間かかることが少なくありません。このシミュレーションをそのまま進化ループに組み込むと、世代ごとに集団全体を1つずつ評価する必要があり、計算予算は数十世代のうちに急速に枯渇し、探索できる空間も圧迫されます。
代理モデル(surrogate model、近似モデル、メタモデルとも呼ばれる)は、低コストの近似計算で高忠実度シミュレーションを全面的または部分的に代替します。既存のシミュレーションサンプルから入力—出力のマッピングを学習し、多目的進化最適化において候補解の性能を高速に予測することで、高精度シミュレーションのコストというボトルネックを突破します。
なぜ高忠実度シミュレーションをそのまま進化ループに組み込めないのか
- ボトルネックの原因:超臨界翼型や構造強度などの問題では1回の CFD / 有限要素シミュレーションに時間がかかる一方、進化アルゴリズムは世代ごとに集団全体を評価するため、評価回数と計算予算はほぼ線形に消費されます。
- 直接的な影響:予算がわずか数世代で使い果たされ、集団サイズと反復世代数を圧縮せざるを得なくなり、多目的フロントを十分に探索できず、本来の設計空間が「評価コストが高すぎる」という理由で閉ざされてしまいます。
代理モデルの基本原理
基本翼型や摂動サンプルなどの既存データを用いて「候補案 → 目的関数値と制約性能」というマッピングを学習させることで、それは安価な近似評価器となります。進化ループでは、まず候補解を代理モデルでバッチ評価し、スコアが上位のもの、または不確実性が大きい少数の候補だけを高忠実度シミュレーションで検証します。
高速化の4つのステップ
- オフライン学習:初期サンプリングデータで代理モデルを学習し、初步的な入力—出力マッピングを構築します。
- オンラインバッチ予測:世代ごとに全候補の複数の目的関数値を同時に予測し、1点ずつの高忠実度シミュレーションを代替します。
- 代理支援による点選択:予測値と不確実性を組み合わせ、潜在性が高い、または情報量が多い候補を選択します。
- フィードバック校正:少数の高忠実度結果をサンプルライブラリに書き戻し、代理モデルを逐次更新することで、以降の予測を真の応答面に近づけ続けます。
精度とコストのトレードオフ
代理モデルが複雑になるほど(単純な回帰からガウス過程、深層ネットワークまで)、通常はより正確になりますが、学習と推論のコストも増大します。重要な制約は、代理モデルは高忠実度シミュレーションより格段に高速でなければならないという点です。そうでなければ新たなボトルネックになってしまいます。同時に、選択圧を支えるのに十分な精度も必要で、そうでなければ進化は誤った方向に導かれてしまいます。
限界とリスク
代理モデルは学習分布の近傍でのみ信頼できます。探索が候補を分布外の領域へ押し出すと、予測はもっともらしく見えても大きく外れた値を示し、探索方向を誤らせる可能性があります。有効な対策は、不確実性推定を出力すること、信頼閾値を設けてスクリーニングすること、範囲外の候補には高忠実度検証を必須とすること、そして実際の誤差統計で定期的に代理モデルの品質をチェックすることです。
代理モデルによるシミュレーション高速化の比較図は、進化最適化における高忠実度シミュレーションと代理モデルの評価フローを比較したものです。前者は1点ごとに時間がかかり、大規模な集団での多世代探索を支えるのが困難です。後者は既存サンプルから候補案と目的関数値のマッピングを学習し、バッチで高速に予測します。上位または不確実性の大きい候補のみを高忠実度で検証し、その結果をフィードバックして代理モデルを更新することで、希少なシミュレーション予算を重要な候補に集中させます。