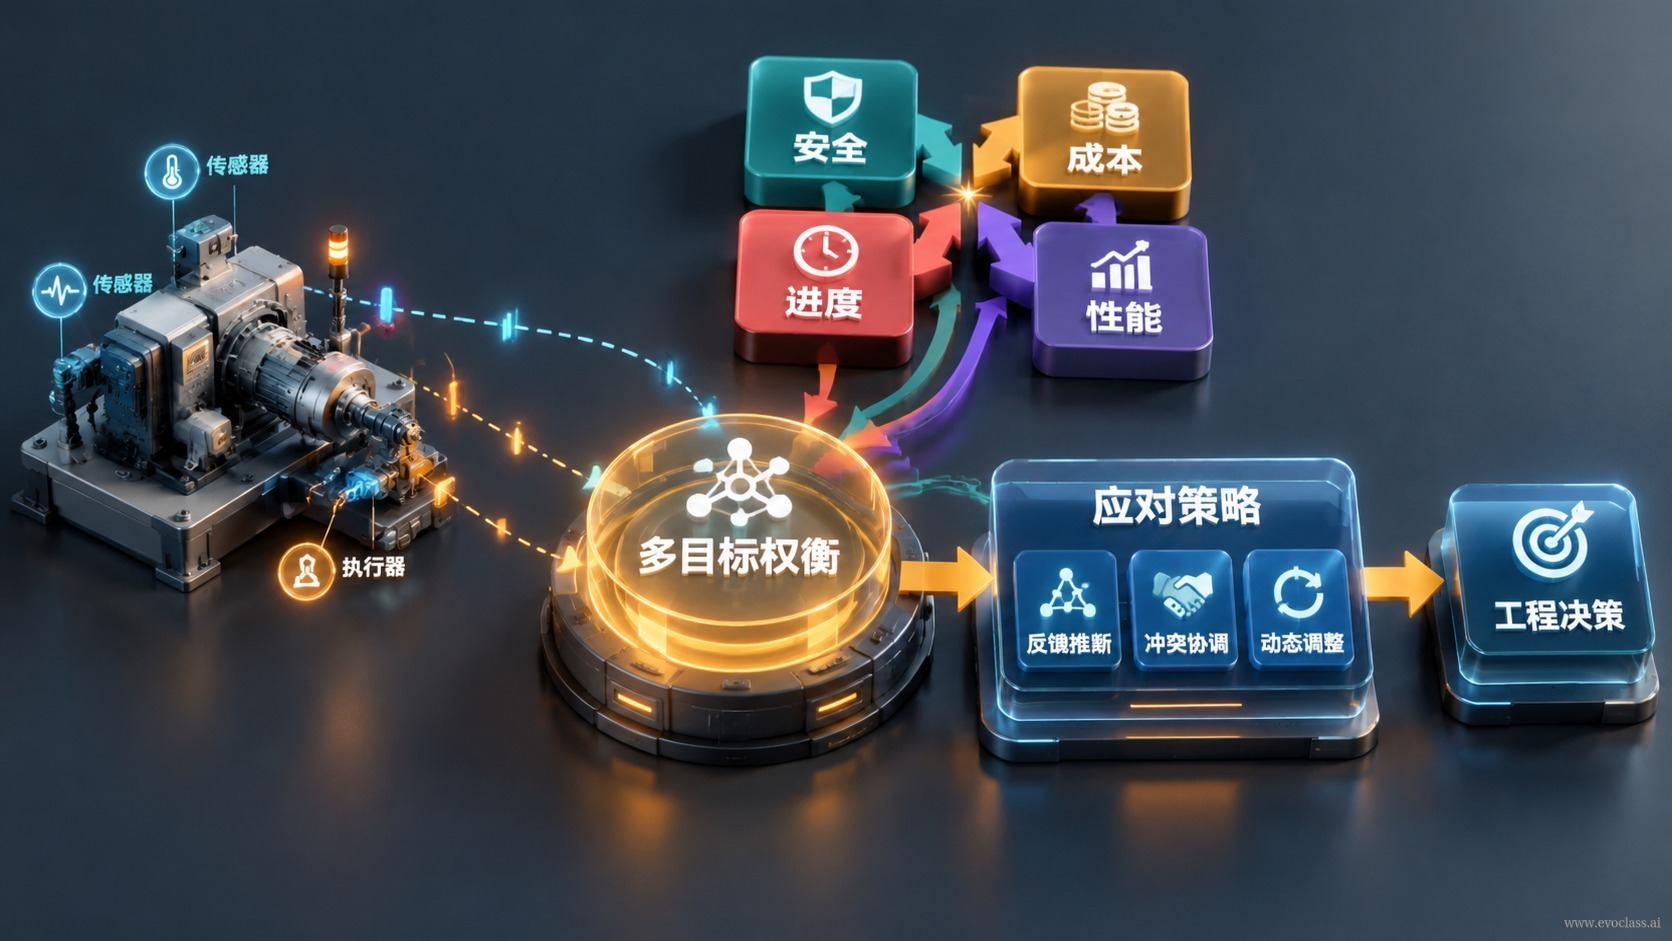
複雑なエンジニアリング最適化において、目的の衝突と疎なフィードバックはほぼ常態です。このページで確立したい判断は、これら2つの課題は「解消」されるのを待つ欠陥ではなく、明示的にモデル化すべき対象であるという点です。作業の重心も、「単一目的の最適解を求めること」から、少なく、高コストでノイズを含むフィードバックのもとで、複数目的間のトレードオフを動的に管理することへと移ります。
コースの文脈に置いてみると、進化計算がこの種の問題に対処する重要なアプローチである理由は、自然界の変異と選択のように唯一の答えをあらかじめ指定せず、変化の生成と環境による評価を通じてバランスを見出す点にあります。記号主義、コネクショニズム、サイバネティクス、進化計算といった複数のアプローチがここで再び合流します。進化計算は本質的に並列処理に適しており、集団の候補を同時に生成・評価できるため、互いに衝突する複数の目的を同時に追跡するためのメカニズム基盤を提供します。
学習目標:エンジニアリングの現場における目的の衝突と疎なフィードバックの課題を識別する。中核概念:疎なフィードバック。
一、目的の衝突:複数指標のトレードオフ
実際のエンジニアリングでは、性能、コスト、信頼性、エネルギー消費、製造制約を同時に追求することがよくあります。これらの指標は互いに制約し合います。ある目的を高めると、しばしば別の目的を犠牲にするからです。たとえば超臨界翼型の設計では、揚抗比を高めると抗力発散が悪化する可能性があり、構造を強化すると重量と製造難度が増します。したがって本当の問いは「どの指標が最も重要か」ではなく、「どのような条件下で、どのようなトレードオフを受け入れるか」です。
二、疎なフィードバック:少ない・高い・遅い・ノイズを含む
高忠実度シミュレーション、物理実験、現場検証は、コストが高く、サイクルが長く、ノイズが大きく、さらに失敗サンプルを頻繁に返します。これは、設計の評価に使える有効な信号が少なく、到達が遅れ、不連続であることを意味します——これが疎なフィードバックです。それは単に「データが足りない」ということではなく、評価予算そのものが設計プロセスの厳しい制約となることを意味します。実際の評価を一度呼び出すたびに、多大な時間とリソースを費やす必要があるからです。
三、疎なフィードバックがもたらす体系的課題
- 代理モデルの偏差が増幅:実際の評価回数が非常に少ないとき、近似誤差は速やかに発見されにくく、真の法則としてそのまま使われやすい。
- 過学習と早期収束:限られたサンプル下での「最適」はサンプリングノイズの産物にすぎない可能性があり、探索は早期に局所領域へ収束してしまう。
- 探索と活用の不均衡:フィードバックが高コストであるため「活用」がより割の良い選択に見えますが、探索が不十分だと集団全体が同じ領域にとどまってしまいます。
- 固定された選好の硬直化:固定された重みや固定された選好は段階的な発見に適応できません——初期には二次的と考えられていた制約が、その後の評価で支配的なボトルネックになる可能性があります。
四、動的調整:単発の最適化を継続的なトレードオフへ
- 代理モデルとマルチフィデリティ評価:低コストの近似で大部分のスクリーニングを担い、重要な候補にのみ高コストの予算を投じることで、1回あたりのフィードバックコストを下げる。
- 能動的サンプリングとバッチ実験:情報利得が高い候補やトレードオフフロント上にある候補を優先的に評価し、高コストなフィードバック1回あたりのサンプル効率を高める。
- 多目的進化:集団方式で複数の非支配候補を同時に維持し、パレートフロント上の多様性を保ち、単一点の答えではなく候補案の集合を出力する。
- 選好と制約の更新:評価結果、不確実性の変化、ドメイン知識の補充に応じて、重み、制約、参照点、探索範囲を段階的に調整する。
この一連の手法はまさに「単一の最適をあらかじめ定めるのではなく、複数の経路を取る」ことの具現化です。活用するのは群知能的な候補群の維持による多様性であり、高コストな評価を低コストの近似に委ね、選好を証拠に応じて逐次更新します。エンジニアリング実装においては、GPU と大規模モデルがもたらす大規模並列探索・生成能力が、この並列・分散型の探索を支える基盤となります。
五、衝突とトレードオフの明示化
対応の目的は衝突をなくすことではなく、衝突、リスク、トレードオフの関係を説明可能にすることです。どの指標が競合しているのか、現在トレードオフ曲線のどの区間に位置するのか、候補解が選好の変化にどれほど敏感か。単一の最適経路をあらかじめ定める場合と比べ、この手法の利点は、唯一の正解を事前に知ることに依存せず、システムが複数の候補を同時に保持し、実際の評価の中で異なる目的間のトレードオフ関係を均衡させられる点にあります。こうして得られた候補集合こそ、3か月前の固定された重みに縛られることなく、専門家が効果的に評価し意思決定できるものになります。
疎なフィードバックと目的の衝突の処理フレーム図图示把目标冲突与稀疏反馈作为需要显式建模的对象:多个工程指标此消彼长,而高保真评价少、贵、慢且带噪。应对机制是用代理模型与多保真评估降低调用成本,以主动采样和多目标演化维护折中候选,并随证据更新偏好与约束。