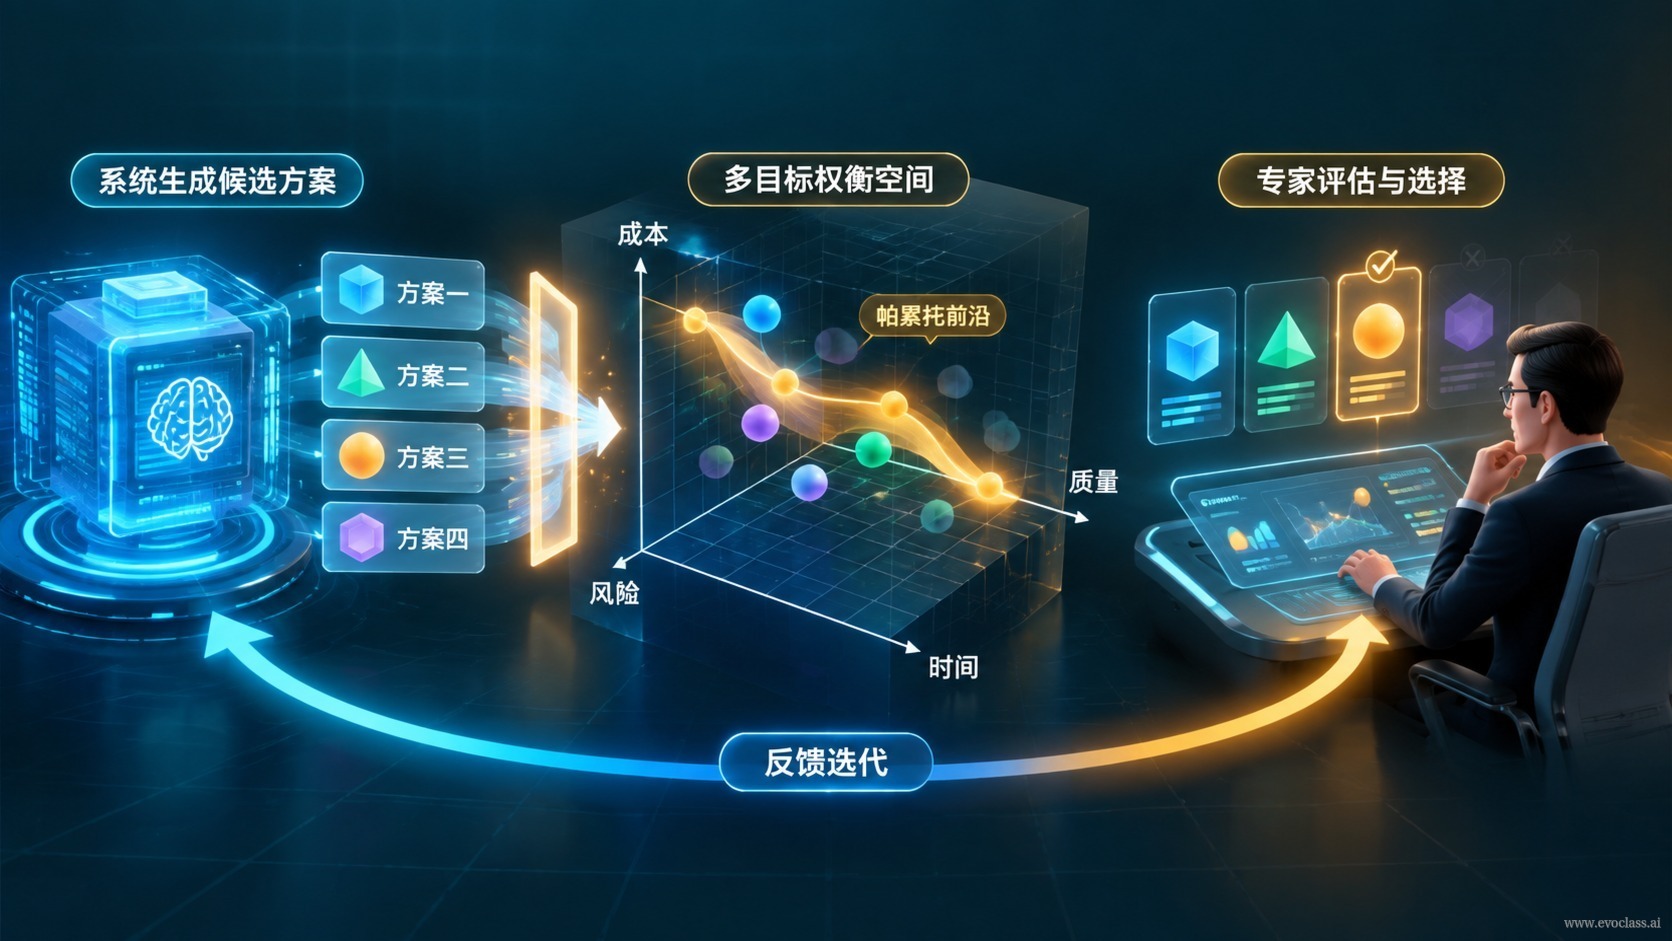
EvoX の多目的探索プロセスにおいて、自動化システムと領域専門家は互いを代替する存在ではなく、分業して協働する二つのエンジンです。システムは「生成と絞り込み」を、専門家は「判断と意思決定」を担います。システムが可能性を広げ、専門家がその可能性を納品可能な一つの選択に収束させます。
この分業は第2課の技術的源流を引き継いでいます。EvoX の来歴は記号主義、コネクショニズム、サイバネティクスと進化計算が再び合流した地点にあり、その中でも進化計算が最も直接的な技術的源流です。進化計算はあらかじめ唯一の答えを指定せず、変異と選択を通じて、実際の評価の中で互いに衝突する複数の目的をバランスさせます。だからこそ、システム側は本質的に並列処理に適しています。种群内の候補は同時に生成・評価できます。従来のエンジニアリングは長らく「多様性の維持コストが高く、逐次スケジューリングが煩雑」という制約に縛られてきましたが、GPU と大規模モデルがもたらす大規模並列探索と知的生成こそが、この矛盾を緩和するエンジニアリング基盤です。
役割分担:誰が生成を担い、誰が最終決定を下すか
- システム側:大規模な候補生成、代理モデルによる予測、Pareto フロンティアの描出と多様性の維持を担い、「どのような可能性があるか」に答えます。
- 専門家側:目的の優先順位、ハード制約、リスク許容度、実シナリオへの適合性を決定し、「どれを選ぶべきか、なぜか」に答えます。
評価次元:単一目的の最適は納品可能な案に等しくない
案の評価では、性能上の便益とエンジニアリング上のコストを、説明可能で監査可能な意思決定の根拠へと変換します。性能上の便益に加えて、少なくとも計算コストと製造コスト、ロバスト性、保守性、不確実性、そして疎なフィードバック下での結論の信頼性も同時に検討する必要があります。単一目的の最適だけを見ると、エンジニアリング上実現不可能な案や、外乱に極めて脆弱な案を選んでしまいがちです。一方、目的が衝突し制約が複雑な問題では、まさに多次元の評価によってこそ、進化探索が保持した複数の候補がそれぞれの適用場面を現すのです。
意思決定手法:領域の経験を検証可能なロジックに変える
明示的な選好、階層的評価、意思決定マトリクス、閾値の否決項目、感度分析を通じて、領域の経験は検証可能で再現可能な選択ルールとして表現できます。よく用いられる順序は、まずハード制約で最低限の要件に反する候補を「一票否決」し、次に残った候補について便益—コストのトレードオフを行い、最後に感度分析で結論が重みの変動に対して稳健かどうかを確認する、というものです。
疎なフィードバックと責任の閉ループ
高忠実度の評価が高コストで、フィードバックが疎な場合、専門家は代理モデルの信頼度、候補の多様性、そして観察済みの失敗パターンに基づいて、再確認するか、再サンプリングするか、あるいは探索を終了するかを決定する必要があり、代理モデルが出した「最適解」を盲目的に信頼してはなりません。最終案の選択とリスクの負担は領域専門家に属します。選択理由は選好、制約、評価シグナルとしてフィードバックされ、次の進化探索を導き、責任の閉ループを形成すべきです。
専門家の意思決定とシステム生成の協働図図はシステム側と専門家側の分業を区別して示しています。システムは大規模な候補生成、代理予測、パレートフロンティアの描出を担い、専門家は目的の優先順位、ハード制約、リスク許容と最終決定を担います。評価では便益、コスト、ロバスト性、信頼性を同時に見る必要があり、選択理由は選好と制約として再びフィードバックされ、責任の閉ループを形成します。