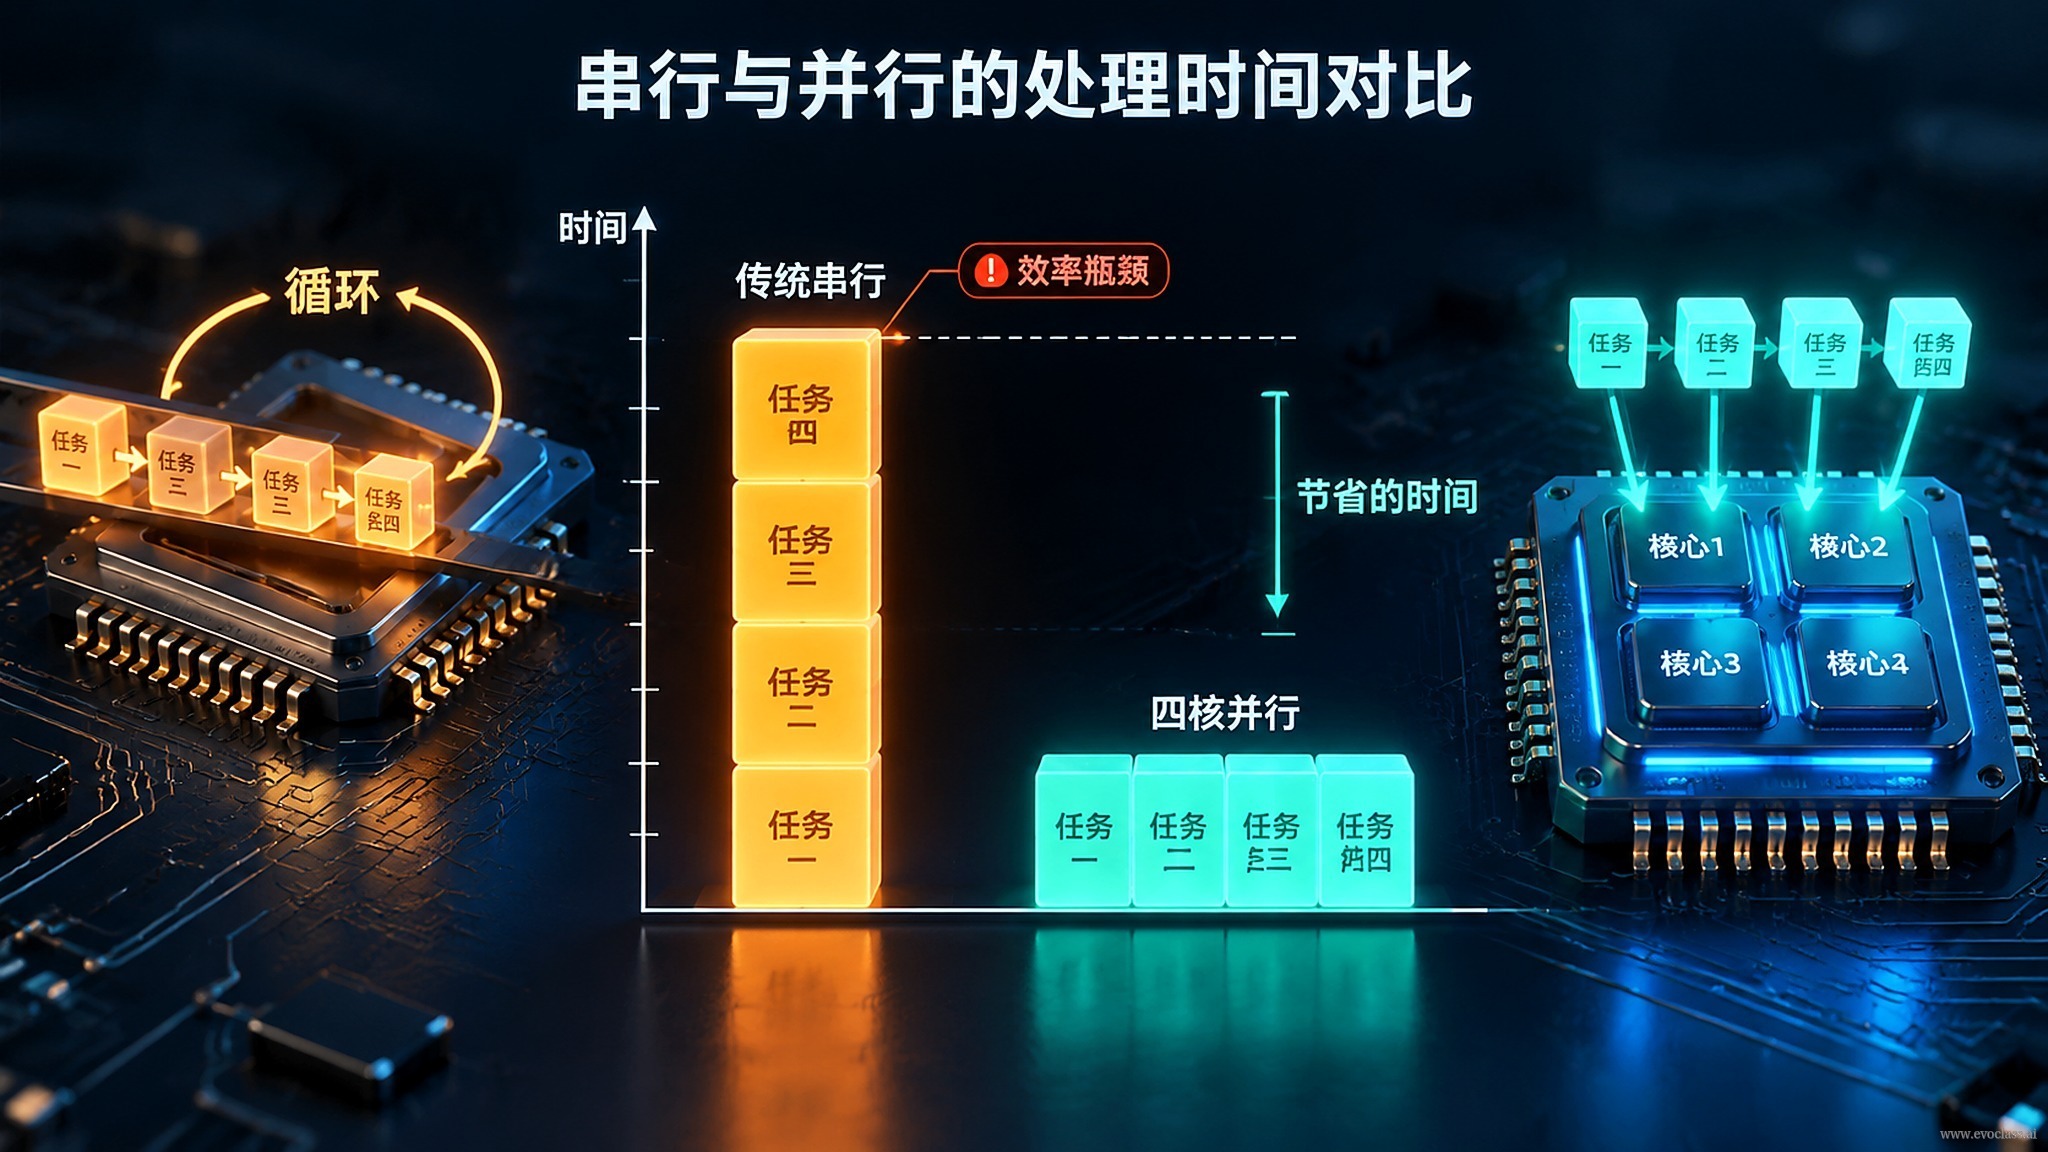
進化の過程は集団の多様性に依存し、多様性は集団規模と評価回数の倍増を意味します。候補の評価が数万回のオーダーに達すると、従来の逐次CPUループがパイプライン全体で最も細い区間となります。一度に1個体しか処理しないため、ハードウェアの並列処理能力はほとんど遊休状態になります。
一度に1つ:逐次ループの実行モデル
最も素朴な実装は、集団全体を1つのリストとして扱い、ループで個体を1つずつ取り出すものです。個体取得 → 具体的なパラメータへデコード → 評価関数の呼び出し → 適応度の書き戻し。隣接する反復はほとんど重ねられません。評価結果が返ってこなければ書き戻しは進まず、書き戻しが完了しなければ次の個体に結果を置く場所がありません。その結果、マルチコア、SIMD、GPU といった並列ユニットは大半の時間アイドル状態となり、1つの個体がパイプラインを走り終えるのを眺めるしかありません。
オーバーヘッドはどこから生じるのか
- 線形に膨らむ評価回数:総評価回数はおよそ集団規模 × 反復世代数となり、10⁵ のオーダーに達すると逐次の実時間はほぼ線形に増加します。
- インタプリタ層での1件ずつ実行:個体ごとのループ、境界チェック、型ディスパッチが、固定的だが高コストな定数オーバーヘッドをもたらします。
- 非連続メモリアクセスとデータ転送:1つずつ取り出す個体はメモリ上で連続していないことが多く、キャッシュヒット率が低く、転送コストを繰り返し支払うことになります。
- 同期とスケジューリング:次の個体を取得するために、実行フローは繰り返し停止と再開を余儀なくされます。
規模を時間に換算する
集団1000、反復100世代を例にとると、候補評価は合計約10万回になります。1回の評価が平均1 msなら、評価段階だけで逐次では約100秒を要し、これには演算子の計算やスケジューリングのオーバーヘッドは含まれていません。多様性を維持するために再起動回数を1回から5回に増やすと、コストはほぼ線形に増加し約500秒になります。同一の作業量をバッチ単位で編成し並列ハードウェアに任せれば、実時間は個体数ではなく主にバッチ数によって決まります。
このボトルネックはいつ縮小するのか
境界条件も同様に重要です。1回の評価が極めて安価(マイクロ秒級)である場合や、集団が極小(百程度以下)である場合、スケジューリングとメモリのオーバーヘッドが計算オーバーヘッドを逆転する可能性があり、逐次と並列の差は明確に縮小し、テンソル化の限界効用は逓減し、ボトルネックはスケジューリングの粒度とメモリ帯域幅へ移ります。したがって実行モデルを改修する価値があるかどうかは、評価コストと規模を組み合わせて評価する必要があります。
逐次と並列の所要時間比較集団1000、反復100世代を例にとると、候補評価は合計約10万回です。1回の評価が1ミリ秒のとき、逐次では評価段階だけで約100秒を要し、再起動5回ではほぼ線形に増加して約500秒になります。バッチ単位で編成し並列ハードウェアに任せると、実時間は個体数ではなく主にバッチ数によって決まります。