EvoX の現代的な計算基盤では、進化オペレータの最小実行単位はもはや「個体」ではなく、集団全体の集団テンソルです。変異・交叉・選択などのオペレータは1回の呼び出しで全個体を処理でき、さらにその上で計算グラフコンパイル把算子序列组织成可优化的执行计划,在保持算法语义不变的前提下提升执行效率。
オペレータ並列化:テンソル単位のバッチ進化
- テンソル級オペレータ:変異・交叉・選択は形状 [N, D] の集団テンソル(N は集団サイズ、D は決定変数の次元)に直接作用でき、1回のオペレータ呼び出しで N 個の個体すべてをカバーします。
- 個体ごとのループを排除:もはや次のような
for ind in population: ind = mutate(ind)といった Python/CPU の直列ループを書く必要がなくなり、頻繁な関数呼び出しやフレームワーク呼び出しのオーバーヘッドを削減できます。 - バッチ次元でスループットを稼ぐ:個体次元がバッチ次元の役割を担うことで、オペレータはデバイス上で大規模並列に実行され、バッチ進化のスループットは集団サイズに応じて拡大します。
計算グラフコンパイル:オペレータ列から実行計画へ
「変異 → 交叉 → 選択」というオペレータの依存関係を1枚の計算グラフとして編成すれば、コンパイラは既存実装をオペレータ単位で呼び出すだけでなく、グラフ全体で大域的最適化を行えます:
- オペレータ融合:複数の要素単位(element-wise)演算を1つのカーネルにまとめ、中間テンソルの生成と繰り返しの読み書きを削減します。
- カーネル生成とスケジューリング:融合後のサブグラフに対して高効率なカーネルを生成し、より少ない kernel 起動回数で世代全体の進化を完了します。
- メモリ再利用:中間結果用のバッファをあらかじめ計画し、VRAM 確保やデータ転送に伴う追加オーバーヘッドを低減します。
効率は変わっても、セマンティクスは変わらない
区別が必要なのは「どう計算するか」と「何を計算するか」です。オペレータ並列化とコンパイル最適化は実行方式——カーネル数、中間テンソルの規模、メモリとスケジューリング戦略——だけを変え、変異・交叉・選択そのものの論理的な意味は変えません。アルゴリズム層は依然として進化のセマンティクスに従ってオペレータを組み合わせるため、同じ乱数シードの下では最適化前後で進化の軌跡と結果が一致するはずです。一言でまとめると、テンソル化は「バッチ計算がどれだけ速いか」を解決し、計算グラフコンパイルは「カーネルスケジューリングがどれだけ優れているか」を解決し、「何を計算するか」は変わらないということです。
よくある誤解
「テンソル化」を「別の進化アルゴリズムに置き換えること」と誤解することです。テンソル化は同じオペレータを集団テンソル全体に適用するだけで、個体間の更新規則は変わりません。コンパイル最適化もアルゴリズムを「賢くする」ものではありません。本当に注意すべきなのは、最適化後に回帰検証を行わず、実装上の差異をアルゴリズムの改善と取り違えてしまうことです。
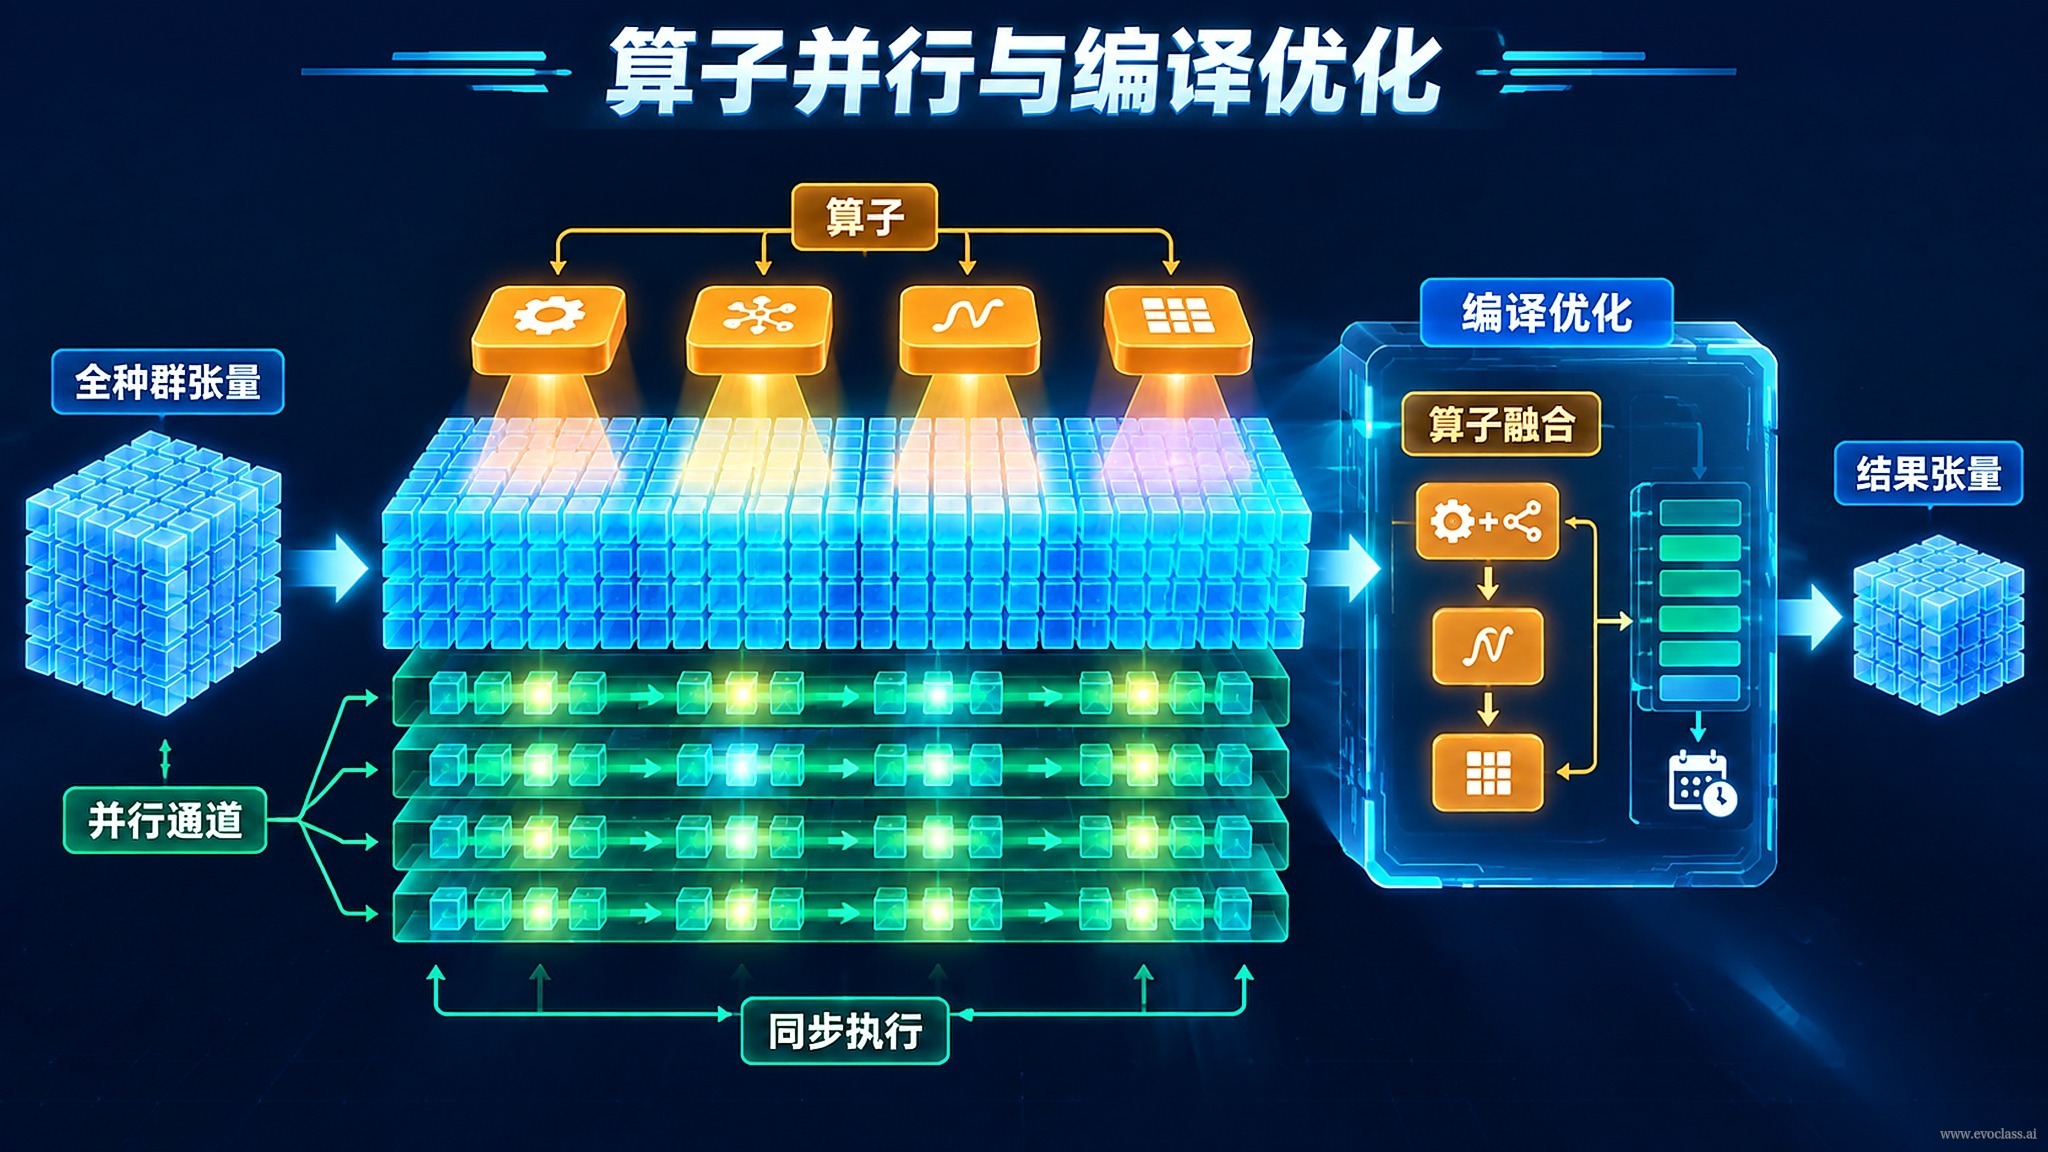
オペレータによる集団テンソル全体の並列処理フロー変異・交叉・選択は個体ごとのループをやめ、それぞれ1回の呼び出しで [N, D] の集団テンソル全体をカバーし、個体次元がバッチ次元となってスループットを拡大します。これらのオペレータが依存関係に従って計算グラフを構成すると、コンパイラはオペレータ融合・カーネル生成・メモリ再利用を行え、実行方式だけが変わり、アルゴリズムのセマンティクスと同じシードでの進化の軌跡は変わりません。
オペレータによる集団テンソル全体の並列処理フロー
変異・交叉・選択は個体ごとのループをやめ、それぞれ1回の呼び出しで [N, D] の集団テンソル全体をカバーし、個体次元がバッチ次元となってスループットを拡大します。これらのオペレータが依存関係に従って計算グラフを構成すると、コンパイラはオペレータ融合・カーネル生成・メモリ再利用を行え、実行方式だけが変わり、アルゴリズムのセマンティクスと同じシードでの進化の軌跡は変わりません。