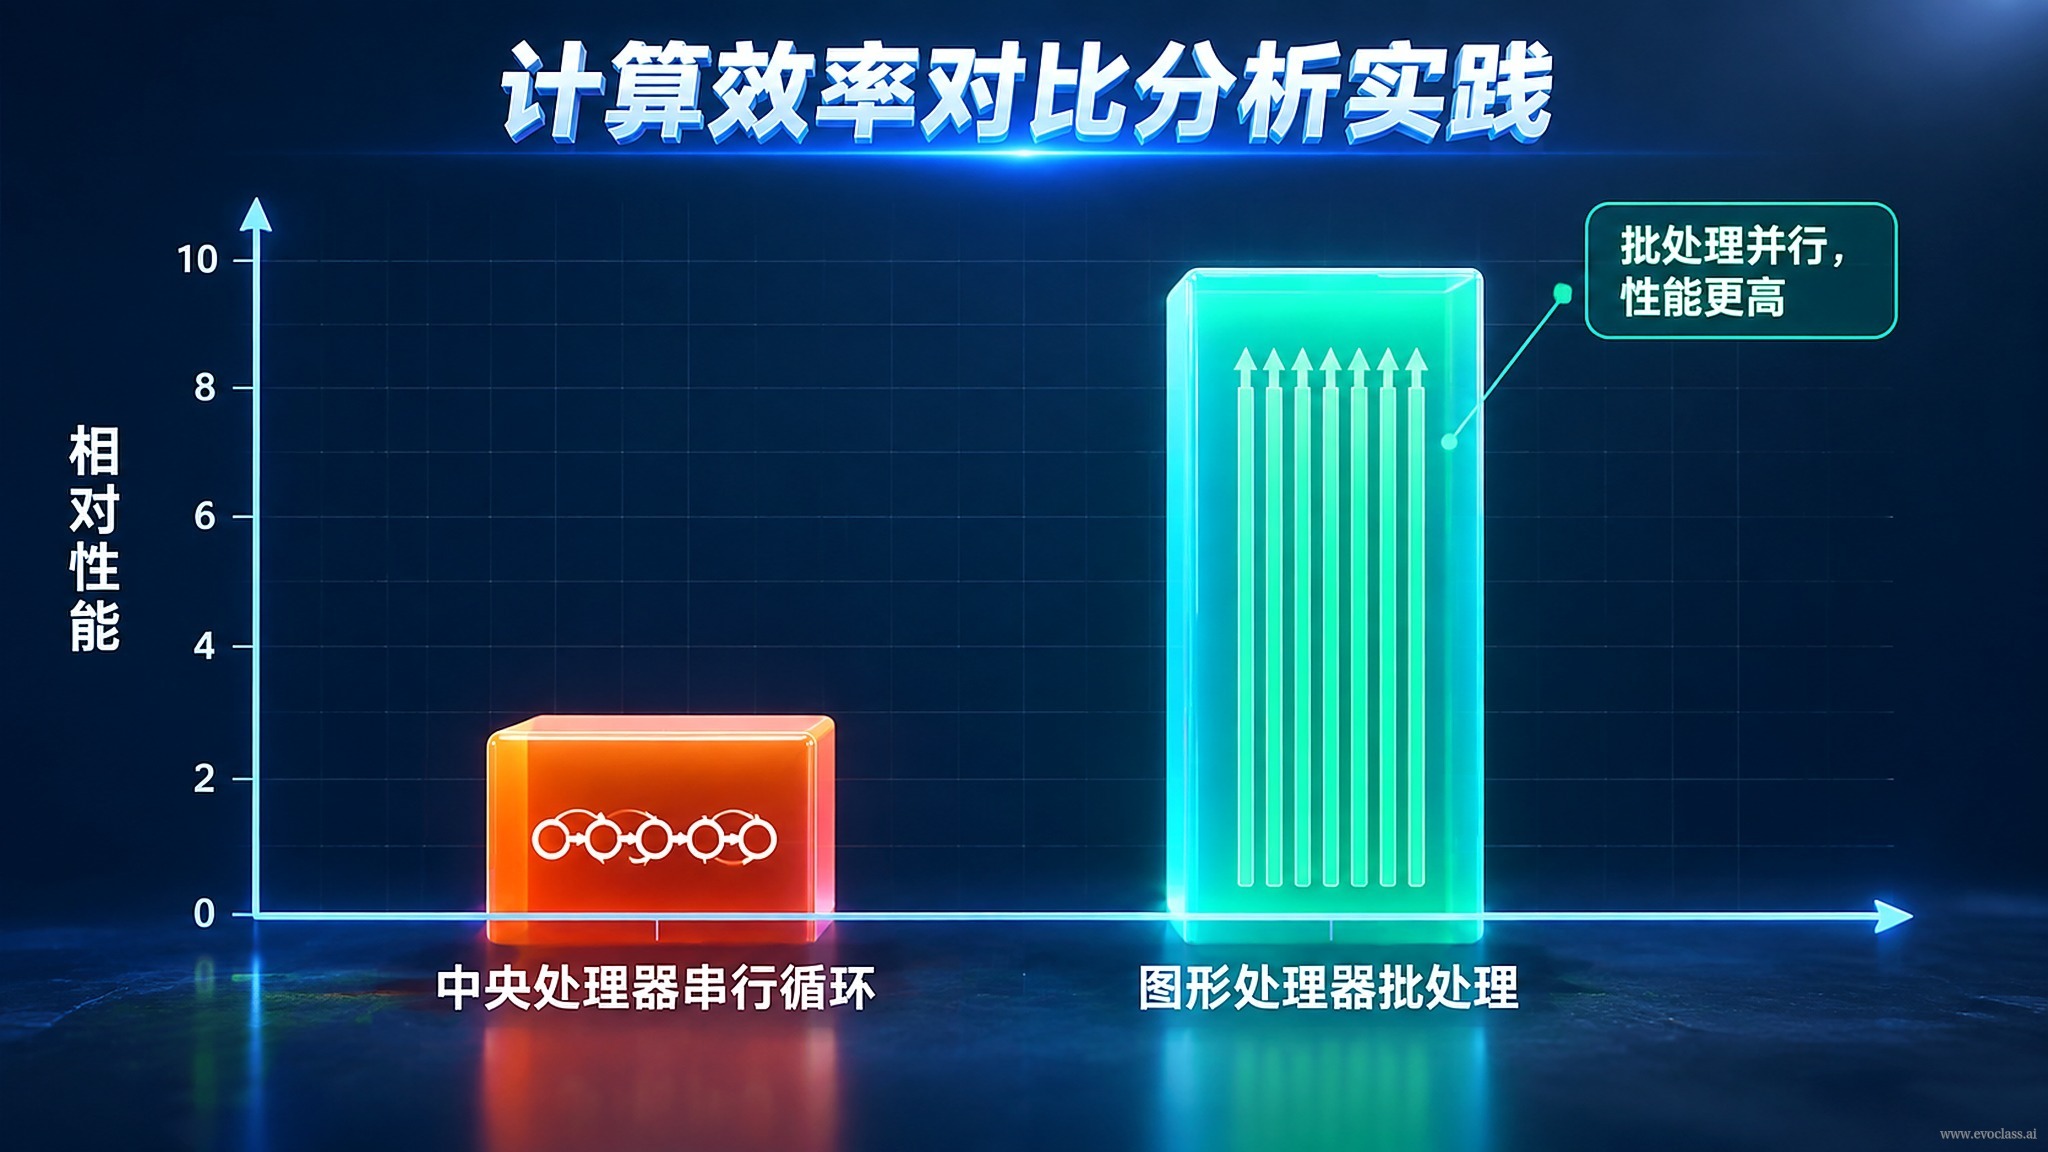
本ページでは「計算効率の比較」を、再現可能な一つの実践に落とし込みます:同一の進化タスク上で、従来型の CPU 逐次個体走査と EvoX GPU テンソルバッチ処理のエンドツーエンド効率を比較します。目標は「GPU のほうが速い」という結論を覚えることではなく、テンソル化並列がもたらす高速化がどこから来るのか、その代償は何か、境界はどこにあるのかを理解することです。
二つのベースライン、同一タスク
- CPU 逐次ベースライン:ループで個体を一つずつ評価関数に渡し、各世代で N 回の独立したスケジューリング、状態更新、結果集計が必要です。ループ制御、インタプリタのオーバーヘッド、散在するメモリアクセスが有効な計算力を薄め、個体数が増えるほどこうした「非計算」コストの割合が高まります。
- GPU テンソルによる比較実装:EvoX は集団、評価入力、実行状態をテンソルとして組織し、GPU 上で評価と演算子をバッチ実行します。1 回の呼び出しで候補集合全体をカバーするため、逐次ループとスケジューリングの回数を大幅に削減できます。
測定プロトコル:比較を再現可能にする
再現可能な比較では必ず問題・集団規模・反復世代数・乱数シードを固定し、そのうえで記録します:各世代の wall-clock、総所要時間、スループット(評価/秒)、加速比、そして GPU 使用率と VRAM 使用量。計測の前にはウォームアップを行い初回コンパイルと VRAM 割り当ての影響を排除し、計測ポイントでデバイス同期を実施し、同時に計算時間とホスト—デバイス間のデータ転送時間を分けて集計します。どれか一つでも欠けると、得られた加速比は歪む可能性があります。
差異はどこから生まれ、何に制約されるのか
- 利得の源泉:バッチ並列、テンソル化演算子、デバイス内並列により、1 回の呼び出しで候補集合全体を処理し、単位時間あたりにより多くの評価を完了できます。
- 制約条件:バッチサイズ、問題の次元数、評価関数のベクトル化可能度、ホスト—デバイス間コピーのオーバーヘッドとカーネル起動オーバーヘッドが、最終的な高速化に影響します。バッチが小さすぎると起動オーバーヘッドに利得を食われてしまいます。評価関数がベクトル化できなければ、バッチ処理はほとんど効果を発揮できません。
実践の結論
正しい順序は次のとおりです:まず評価関数がバッチ化できるかを検証してから、CPU と GPU の実装を比較する。効率上の優位性は最終的に「同じ計算予算のもとでより多くの世代またはより多くの候補案を得る」という点に帰着させるべきであり、それに基づいてデプロイ方式と実験設計を決めるのです。単に見栄えの良い加速比の数字を追い求めるべきではありません。
CPU 逐次と GPU バッチ処理の効率比較比較において、CPU 逐次ベースラインは個体を一つずつループ評価するため、各世代で N 回のスケジューリングと状態更新が必要となり、インタプリタとメモリアクセスのオーバーヘッドが有効な計算力を薄めます。GPU バッチ処理は集団と評価入力をテンソルとして組織し、1 回の呼び出しで候補集合全体をカバーします。加速比はバッチサイズ、評価関数のベクトル化可能度、ホスト—デバイス間コピーのオーバーヘッドに制約されます。
CPU 逐次と GPU バッチ処理の効率比較
比較において、CPU 逐次ベースラインは個体を一つずつループ評価するため、各世代で N 回のスケジューリングと状態更新が必要となり、インタプリタとメモリアクセスのオーバーヘッドが有効な計算力を薄めます。GPU バッチ処理は集団と評価入力をテンソルとして組織し、1 回の呼び出しで候補集合全体をカバーします。加速比はバッチサイズ、評価関数のベクトル化可能度、ホスト—デバイス間コピーのオーバーヘッドに制約されます。