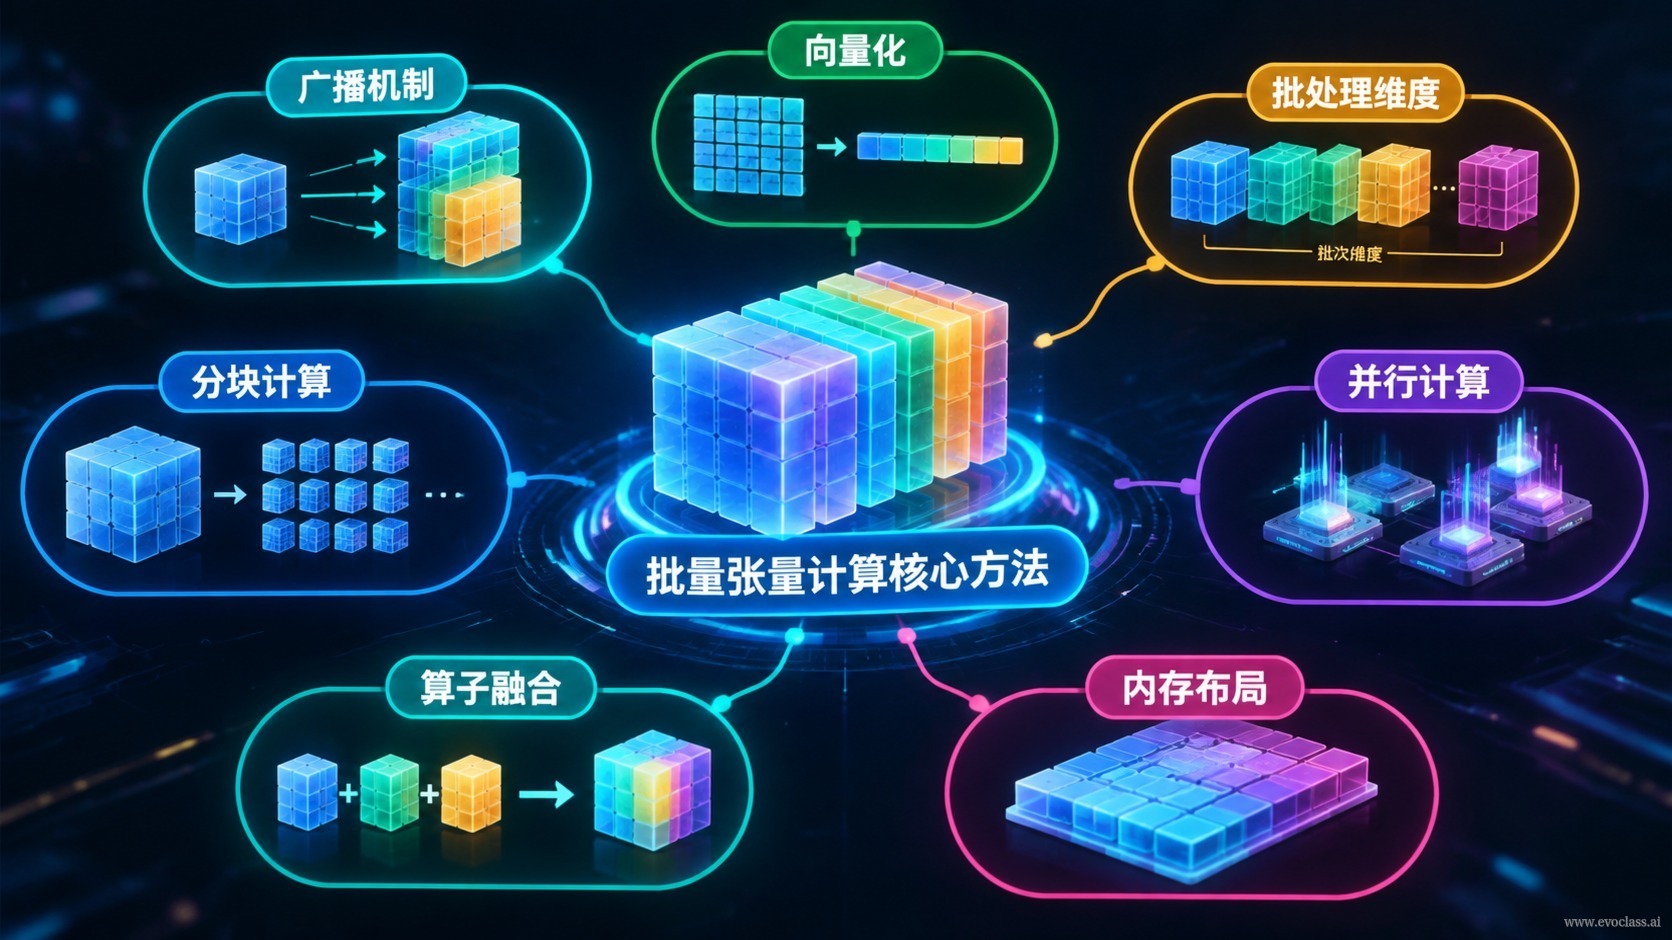
EvoX のテンソル化基盤において、バッチテンソル計算はアルゴリズム表現層に位置します。進化ループ内の候補・評価・状態を統一的にバッチ次元を持つテンソルへとマッピングし、GPU フレンドリーなバッチ演算子とコンパイル済み計算グラフに渡して実行します。目標はきわめて明確です——「個体ごとの逐次進化」を「集団全体の並列進化」へと作り変え、計算資源をスケジューリングや起動に消費するのではなく、探索そのものに真に働かせることです。
一、進化プロセスをテンソルとして表現する
バッチ次元 N が候補(個体)数を表すと定めれば、進化における三要素はそのままテンソルに落とし込めます:
- 候補テンソル:集団 X は [N × D] として構成され、D は単一候補の決定変数の個数です。
- 目的テンソル:目的と制約 F は [N × M] として構成され、M は目的/制約項の数です。多目的の場合、各目的は F の異なる列に対応します。
- 状態量:世代数、現在の最適値、ステップ幅などは、Python オブジェクトで個体ごとに記録するのではなく、スカラーまたは小テンソルバッファで保持します。
こうすることで、交叉・変異・選択・評価はすべて N 次元方向にバッチ処理され、進化ループ内に個体ごとの分岐や制御フローは現れなくなります。
二、バッチ演算子:N 回の単一候補呼び出しから 1 回のバッチ演算へ
最小限の比較可能な 3 つの式が、バッチ演算子の基本形を描き出します:
- 変異:X′ = X + σ·randn(X)。候補群全体が 1 回のバッチ演算でそれぞれランダム摂動を得て、σ が摂動の強度を制御します。
- 選択:idx = topk(F, k)。N 個の候補の適合度から上位 k 個の候補のインデックスを一度に選び出します。
- 評価:Y = fθ(X)。1 回のバッチ順伝播またはバッチシミュレーションで N 回の単一候補呼び出しを置き換えます。
重要なのは個々の演算子ではなく、すべての候補が同一のテンソル演算グラフを共有することです。1 回のバッチ呼び出しでインタプリタのオーバーヘッドとカーネル起動のオーバーヘッドを削減し、GPU/マルチコアの計算資源を進化探索に真に働かせることができます。制約や範囲外の処理もマスクテンソルを用いて同じバッチ演算内で完結でき、個別の候補のために別途分岐を通す必要はありません。
三、計算グラフの最適化とスループット指標
複数世代の進化をコンパイル可能なデータフローグラフとして記述すれば、さらなる性能を引き出せます:演算子融合はカーネル起動回数を削減し、バッチ内並列は全候補を同時に実行させ、非同期実行は計算とデータ転送を互いにオーバーラップさせ、メモリ再利用は中間テンソルの割り当てを削減します。それに応じて、性能指標も「単ステップ遅延」から候補/秒または世代/秒のスループットへと移行すべきです——バッチ実行では 1 回の呼び出しで候補群全体を処理するため、全体スループットこそが探索効率を真に反映します。
バッチテンソル計算の核心手法マップこのマップは進化プロセスをバッチ次元を持つテンソルとして表現します:集団 X は N×D、目的と制約 F は N×M で、交叉・変異・選択・評価はすべて N 次元方向にバッチ処理されます。変異、topk 選択、バッチ順伝播評価はいずれも 1 回のバッチ呼び出しで済み、性能指標も単ステップ遅延から候補/秒のスループットへと移行します。