EvoX が高強度並列進化探索を支えられる理由は、次の一言に集約できます:候補リストからテンソル化計算グラフへ。従来の進化実験では、各個体を独立した Python オブジェクトとして扱い、一つずつモデル化し、一つずつ評価していました。候補規模が数千・数万に拡大すると、真のボトルネックはアルゴリズムそのものではなく、候補ごとのスケジューリング、同期、I/O のオーバーヘッドに移ります。EvoX のアプローチは、集団・評価・ランタイム状態を一括計算可能なテンソルとして再構成し、統一 Runtime によって GPU や異種演算リソースへバッチ実行をスケジューリングすることです。これにより、大規模・多目的・多解並列の進化探索を支えます。
三つのテンソル化対象
テンソル化は一箇所の局所最適化ではなく、進化ループを貫く三つの層に及びます。いずれかの層がオブジェクトごとのループに戻れば、その層で並列度が頭打ちになります。
- 集団のテンソル化:個体のパラメータ、遺伝子、戦略は Python オブジェクトごとのループではなく、バッチ次元でテンソルとして組織化され、個体間の差異はテンソルの一次元によって表現されます。
- 評価のテンソル化:適応度、制約、多目的指標、およびシミュレーションやモデルによる評価結果をバッチ計算でき、同一バッチ内の候補が一度のデバイス呼び出しを共有することで、候補ごとのスケジューリングと I/O オーバーヘッドを大幅に削減します。
- 状態のテンソル化:進化世代、乱数シード、キャッシュ、モニタリング指標などのランタイム状態が統一的に管理され、並列高速化後の実験でも再現可能かつ追跡可能です。
計算グラフ化と統一アーキテクチャ
候補リストをテンソル化計算グラフへと引き上げて初めて、演算子並列とコンパイル最適化が活きてきます。集団規模と評価の並列度は、インタプリタループに縛られることなく、演算リソースに応じて拡張できます。これに対応するのが統一アーキテクチャです。アルゴリズム、問題、ワークフローとモニタリング、Runtime スケジューラが相互に分離され、アルゴリズムは組み合わせ可能、問題はプラグイン可能、異種演算リソースは統一的に管理されます。利用者はアルゴリズムを書く際に、低レイヤのスケジューリングを同時に気にする必要がありません。
この基盤による最も直接的なメリットは直列ボトルネックの打破です。従来の CPU 直列ループを置き換え、GPU と異種演算リソースで大規模な高速化を実現し、高強度探索に安定したスループット基盤を提供します。同じウォールクロック時間で、より多くの候補、より多くの目的の組み合わせ、より多くのランダム反復を探索できます。
例えば、1 回の進化実験で大量の候補案を評価する必要があるとします。従来の方法では CPU 上で候補ごとに評価関数を呼び出すため、スケジューリング、同期、Python ループが所要時間の大半を占めることがあります。EvoX は候補行列をまとめてデバイスに送り、Runtime が演算子と評価をスケジューリングし、状態とモニタリング指標を統一的に記録することで、同じウォールクロック時間でより多くの候補、より多くの目的の組み合わせ、より多くのランダム反復を探索できます。これはまさに、実世界の多目的問題(たとえば超臨界翼型設計において巡航揚抗比と臨界バフェット揚力係数が互いにトレードオフとなる場合)で多様な候補案を保持する必要があるときのエンジニアリング上の支えとなります。
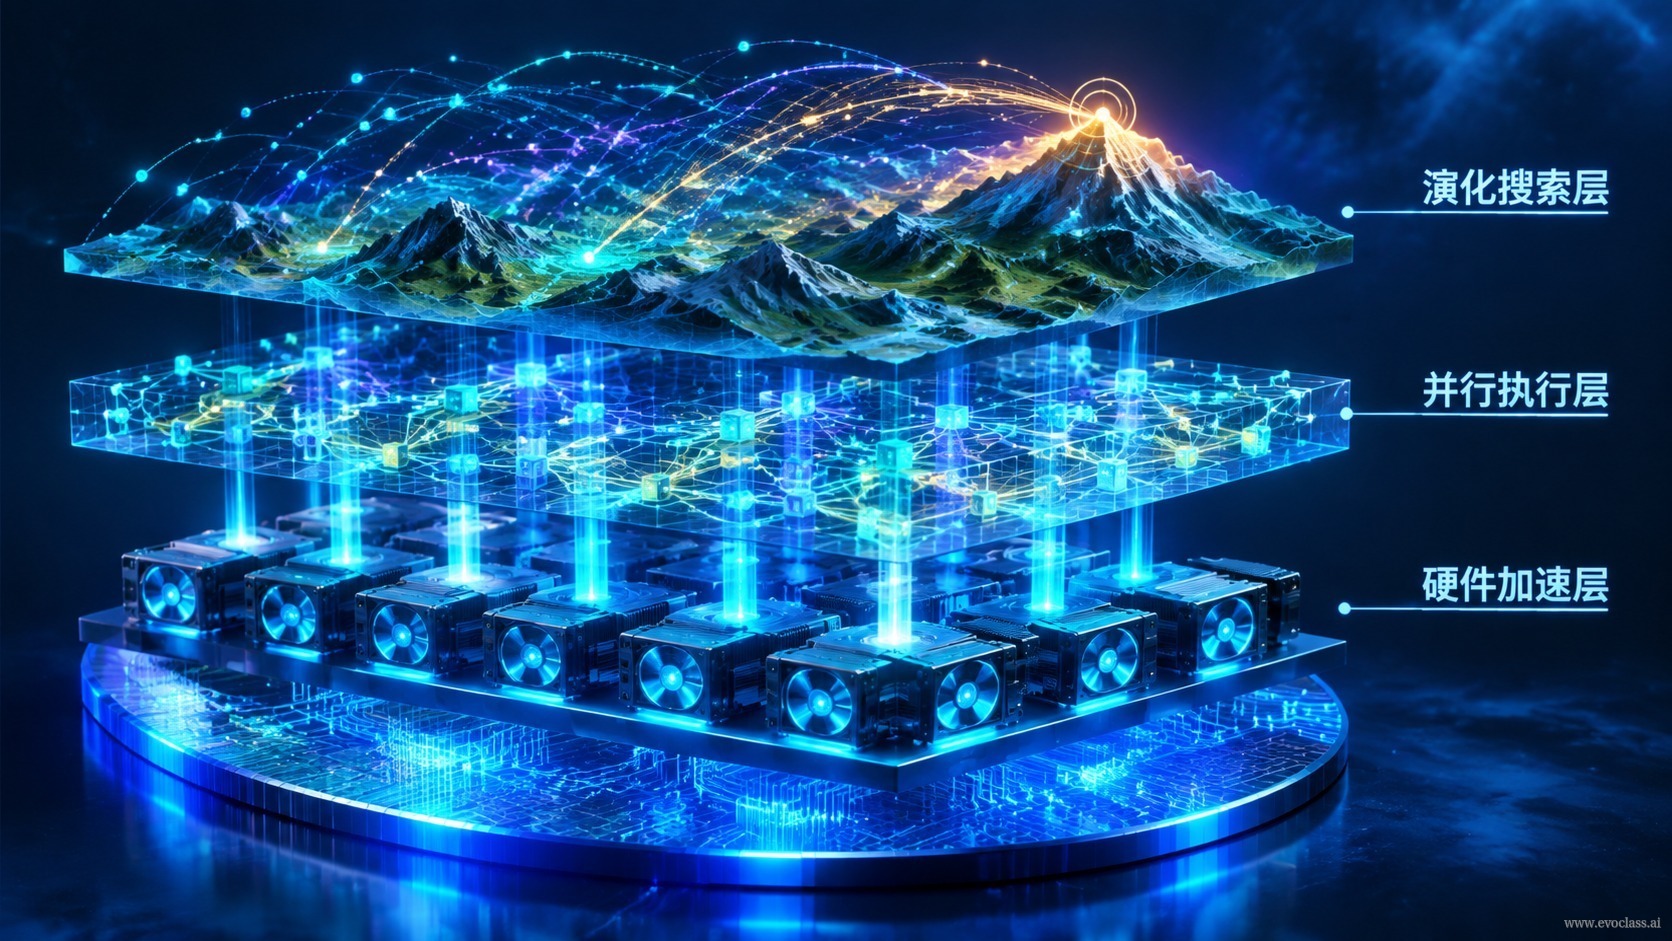
EvoX 現代計算基盤の全体像この図は EvoX の基盤を、候補リストからテンソル化計算グラフへのアップグレードとして要約しています。集団・評価・ランタイム状態の三層を統一的にテンソル化し、Runtime が GPU と異種演算リソースへバッチ実行をスケジューリングします。これによりアルゴリズム、問題、ワークフローとモニタリングが相互に分離され、演算リソース拡張時に候補ごとのループで並列度が頭打ちになることなく、同じウォールクロック時間でより多くの候補と目的の組み合わせを探索できます。