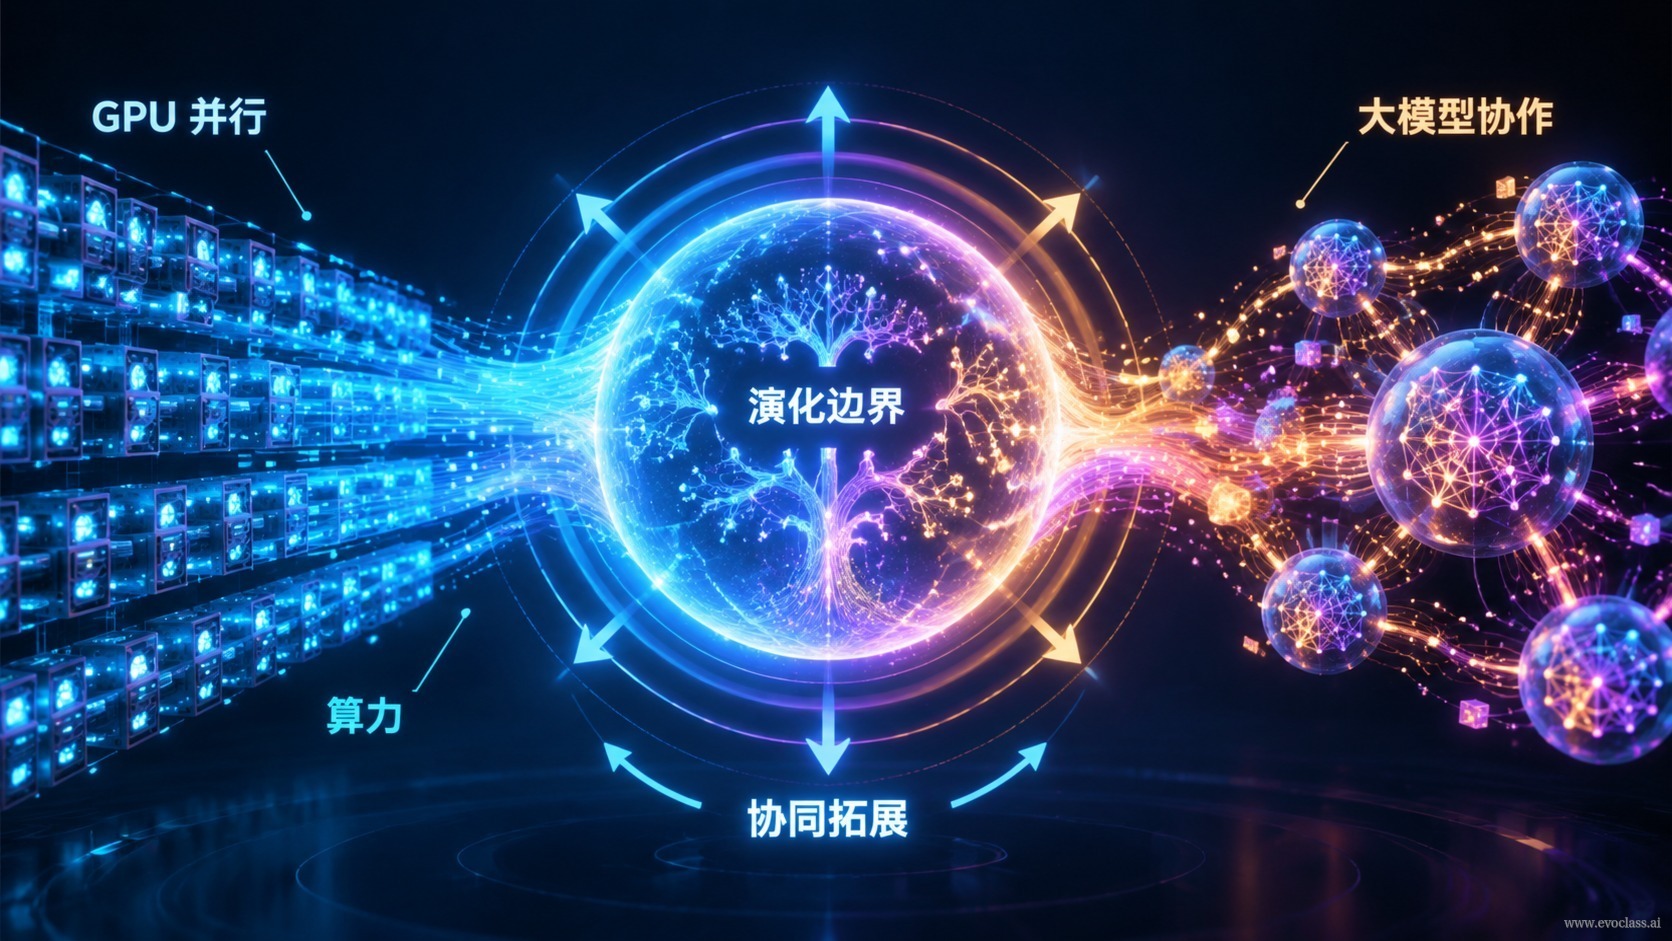
進化計算は長らく、一つの現実的な問題に制約されてきた。限られた時間内に、いったい何個の候補を評価できるのか、という問題である。今日、この制約は二つの工学的な力によって同時に緩められつつある——GPU 並列計算資源と大規模モデルによる意味的生成である。両者はともに進化計算の二重の工学的基盤を構成する。計算資源は「一度にどれだけの候補を探索できるか」を決め、大規模モデルは「どのような形態の候補を探索できるか」を決める。両者が一体となって、進化の対象の境界を数値パラメータからプログラム、モデル構造、さらにはアルゴリズムの仕組みそのものへと外側に拡張する。
計算資源の基盤:候補空間を逐次処理からテンソルへ
传统实现里,种群评价是 CPU 上的串行循环:一次只处理一个个体,调度开销随种群规模累积。以 EvoX 为代表的开源底座把候选、评价结果与算法状态统一组织为全体を一括計算可能なテンソルとして組織する。変異は個体群全体に作用し、評価と状態更新は選択とともに計算グラフに入り、コンパイル最適化を受ける。工学的な直接の成果は、「数万規模の候補を同時に探索する」ことが実験室のテクニックから日常的な手法になったことである。
この種の基盤はシステムをアルゴリズム、問題モジュール、ワークフロー、Runtime スケジューラに分割する。研究者は「いかに進化させるか」に専念すればよく、Runtime がバッチ計算を GPU、アクセラレータ、分散クラスタへスケジューリングする。明確にすべきは、計算資源が解決するのはスループットであり、「賢さ」ではないということだ。候補の良し悪しは判断せず、個体群全体の適応度を一度に計算することだけを担う。それは候補空間拡張の基盤的支えであるが、候補がどのような形になるかは決めない。
意味的基盤:候補の形態を数値ベクトルから構造的ソリューションへ引き上げる
大規模モデルの貢献は、より速く計算することではなく、コード・領域知識・タスクの文脈を理解し、意味レベルの生成能力を備えている点にある。したがって、単に数値ベクトルを出力するのではなく、そのまま呼び出せるソルバーコードや代理モデルのトポロジー構造といった、構造の複雑な候補を構築できる。これにより候補の「形態」空間が開かれる。
進化対象の境界の三段階の外側拡張
- 数値パラメータ:古典的な設定であり、個体群のメンバーは固定構造下の一組のパラメータ値である。
- プログラム / モデル構造:個体群のメンバーが実行可能なコード断片、あるいはネットワークや代理モデルのトポロジー構造になる。大規模モデルの生成能力こそ、このレベルの入口である。
- アルゴリズムの仕組み:「どのように生成し、どのように評価するか」というプロセスそのものも進化の対象に入る。これこそが、後の「進化で進化を改善する」(MetaDE、AutoPSO など)が成立する前提である。
翼型最適化を例に挙げよう。従来の手法では、あらかじめ設定されたいくつかの数値パラメータ上での探索しかできなかった。大規模モデルがソルバーコードを読み書きし、代理モデルの構造を構築でき、さらに GPU が個体群を一括並列評価できるようになると、探索対象は「一組のパラメータ値」から「生成と評価のソリューションそのもの」へと引き上げられる。
代替ではなく相補
両者は相補の関係にある。計算資源は探索の広度を広げ、大規模モデルは候補の質と形態の複雑さを高める。どちらか一方を欠けば、境界の拡張は成立しない。計算資源のみで意味的生成がなければ、探索対象はあらかじめ書き込まれたエンコーディングに制限されたままである。生成能力のみで一括評価がなければ、膨大な候補を許容可能な時間内にスクリーニングしきれない。
境界拡張の代償
境界の拡張は同時に新たな制約をもたらす。第一に評価コストの上昇であり、一回の評価がミリ秒オーダーから分オーダーになり得る。第二に正確性の検証が難しくなるであり、生成されたコードがコンパイルできなかったり、物理的・工学的制約を満たさなかったりする可能性がある。第三に「使える答え」の判定基準がより曖昧になるであり、多目的トレードオフや専門家の意思決定といった段階との連携が必要である。
GPU 並列と大規模モデルの協働による進化の境界拡張フロー図図は、進化の境界拡張が二重の基盤に依存することを示している。GPU とテンソル化 Runtime は個体群評価を逐次ループから一括並列へと移し、一度にどれだけの候補を探索できるかを決める。大規模モデルは意味レベルの生成を提供し、どのような形態の候補を構築できるかを決める。両者が相補的になると、進化対象は数値パラメータからプログラム / モデル構造へ、さらにアルゴリズムの仕組みへと拡張できるが、評価コスト、正確性検証、答えの判定基準といった新たな制約ももたらす。