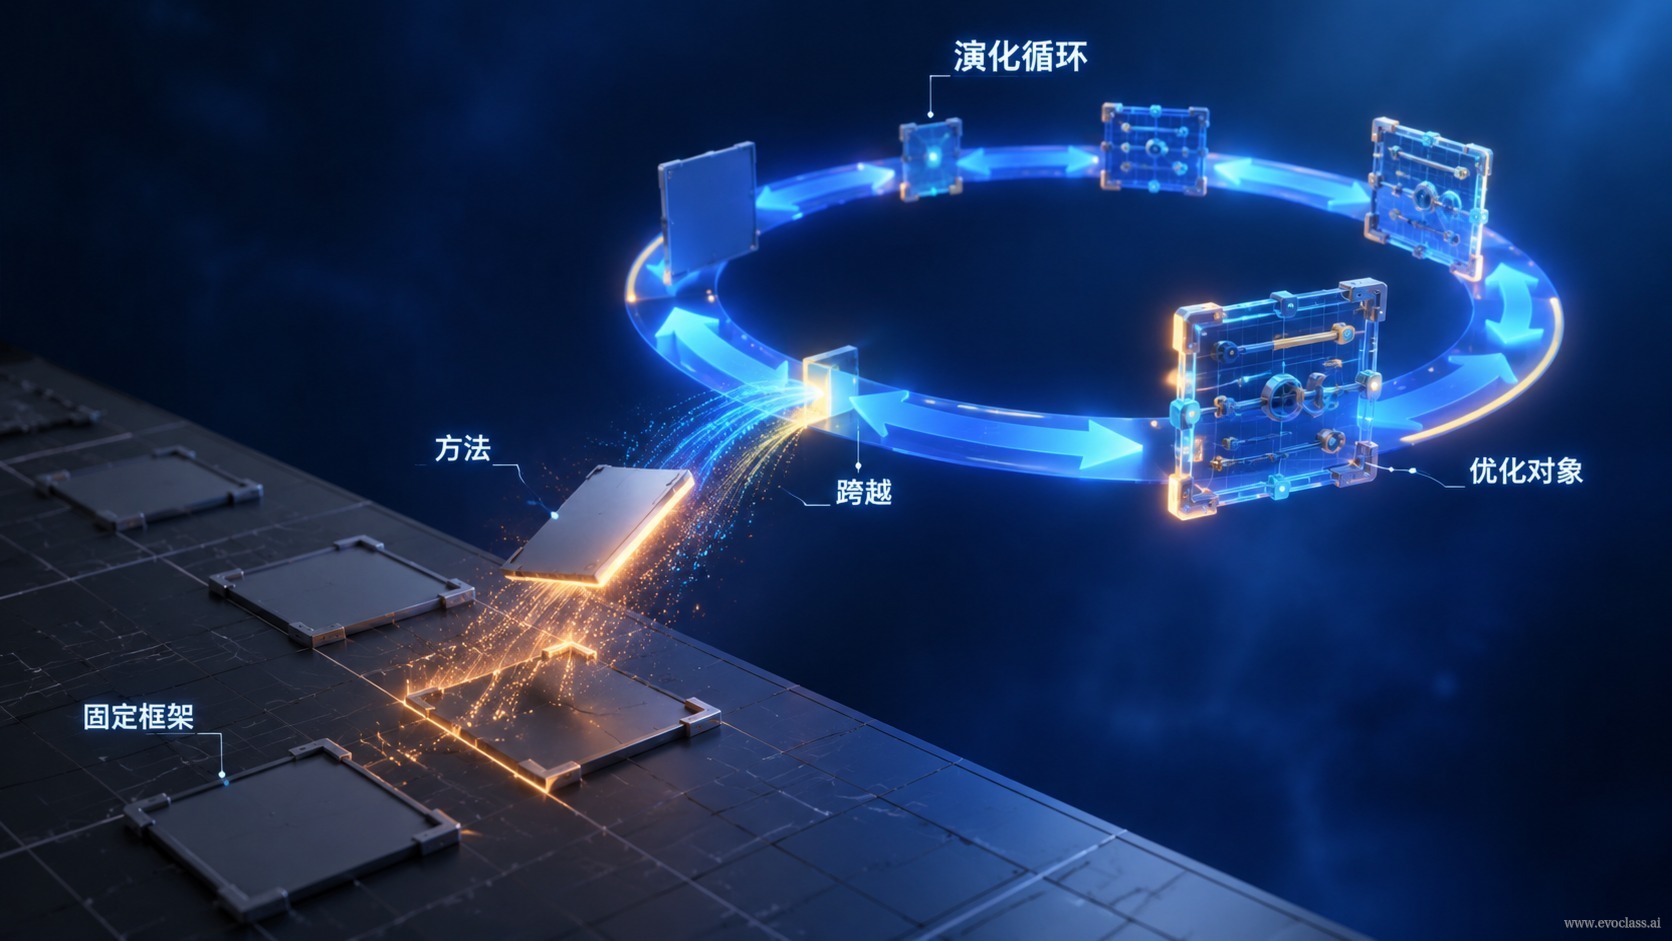
これまでの講義では、進化プロセスを一括計算可能なテンソルとして組織化し、大規模な候補評価の効率問題を解決しました。このページではさらに一歩踏み込みます。もし最適化の対象が候補解だけでなく、候補解を生成する方法であったら、何が起こるでしょうか? 方法進化(Meta-Evolution)の核心的な飛躍とは、「候補解を生成する方法」そのものを最適化対象に変換することです。もはや解だけを進化させるのではなく、解を生成・改善するアルゴリズム、戦略、演算子を進化させ、アルゴリズムを固定されたツールから持続的に進化するソルバーへと変貌させます。
一、「解の進化」から「方法の進化」へ
従来の経路は単一のチェーンとして書けます:問題 → 固定アルゴリズム → 候補解。研究者はまずアルゴリズムや演算子を選定し、次にアルゴリズムを問題空間で探索させますが、アルゴリズム自体は変わりません。方法進化はこのチェーンを次のように書き換えます:問題族/環境 → 進化可能な方法空間 → 候補生成器 → 候補解評価 → 方法更新 → 再生成。最適化変数は解 x から方法、演算子、ハイパーヒューリスティック規則、または候補生成プロセスへと拡張されます m。ここでの「方法」とは、差分進化における変異戦略、粒子群における慣性重みとトポロジー、局所探索演算子、さらにはより上位のアルゴリズム選択とスケジューリング規則を指すことができます。
二、五つの重要な転換
- 進化対象の拡張:解、パラメータ、構造から、方法、演算子、ハイパーヒューリスティック規則、または候補生成プロセスへと拡張されます。
- 問題の再定義:最適化問題は「与えられたアルゴリズムの下で最適解を探す」から「タスクや環境において、より上手く解を探すソルバーを進化させる」へと変わります。
- フィードバック関係:方法が候補を生成しタスク評価を受け、その評価結果が逆に方法の変異、選択、再結合を駆動し、方法層と解層の間に持続的なフィードバックを形成します。
- 評価基準の移行:方法の優劣は単回の最適値だけでなく、タスク間・環境間の汎化、ロバスト性、多様性、計算コストで判断します。
- 役割の転換:研究者はもはや固定されたプロセスを設計するだけでなく、進化可能な方法空間、フィードバック信号、選択メカニズムを設計します。
三、フィードバック閉ループがなぜ重要か
方法層と解層は二つの独立した最適化ループではありません。方法層は候補生成器を生成し、解層はそれを用いて具体的なタスクで候補を生成し評価を得ます。これらの評価は集約または信用割り当てを経て方法層に戻り、方法自体の変異、選択、再結合を駆動します。フィードバック信号が疎すぎたり短期的な最適値のみを報酬としたりすると、方法層は単一タスクに過学習しやすくなります。フィードバック信号がタスク間汎化と多様性を含むならば、方法層は「より上手く解を探す」メタ戦略を学べます。これは方法空間上にさらにもう一層の進化探索を開くことと理解できますが、その評価は解層の実際の性能から切り離せません。
四、概念の基盤:MetaDE と AutoPSO
方法進化はスローガンにとどまりません。MetaDE は差分進化の戦略、パラメータ、さらには演算子の組み合わせを進化可能な対象とします。AutoPSO は粒子群の構造、パラメータ、トポロジーを自動探索に組み込みます。それらは同じ出発点を共有しています:すなわち「候補を生成する方法」を最適化対象に組み込み、アルゴリズムの自己進化を実現することです。本ページではまず統一された概念の基盤を構築し、具体的なアーキテクチャとアルゴリズム構造の進化は後続で展開します。
方法進化の概念構造の模式図図は、従来の「問題→固定アルゴリズム→候補解」という単一のチェーンを、「環境または問題族→進化可能な方法空間→候補生成器→解評価→方法更新」という閉ループへと拡張しています。最適化対象は解からアルゴリズム、演算子、ハイパーヒューリスティック規則へと拡張され、MetaDE と AutoPSO はこの概念基盤の具体的な例です。