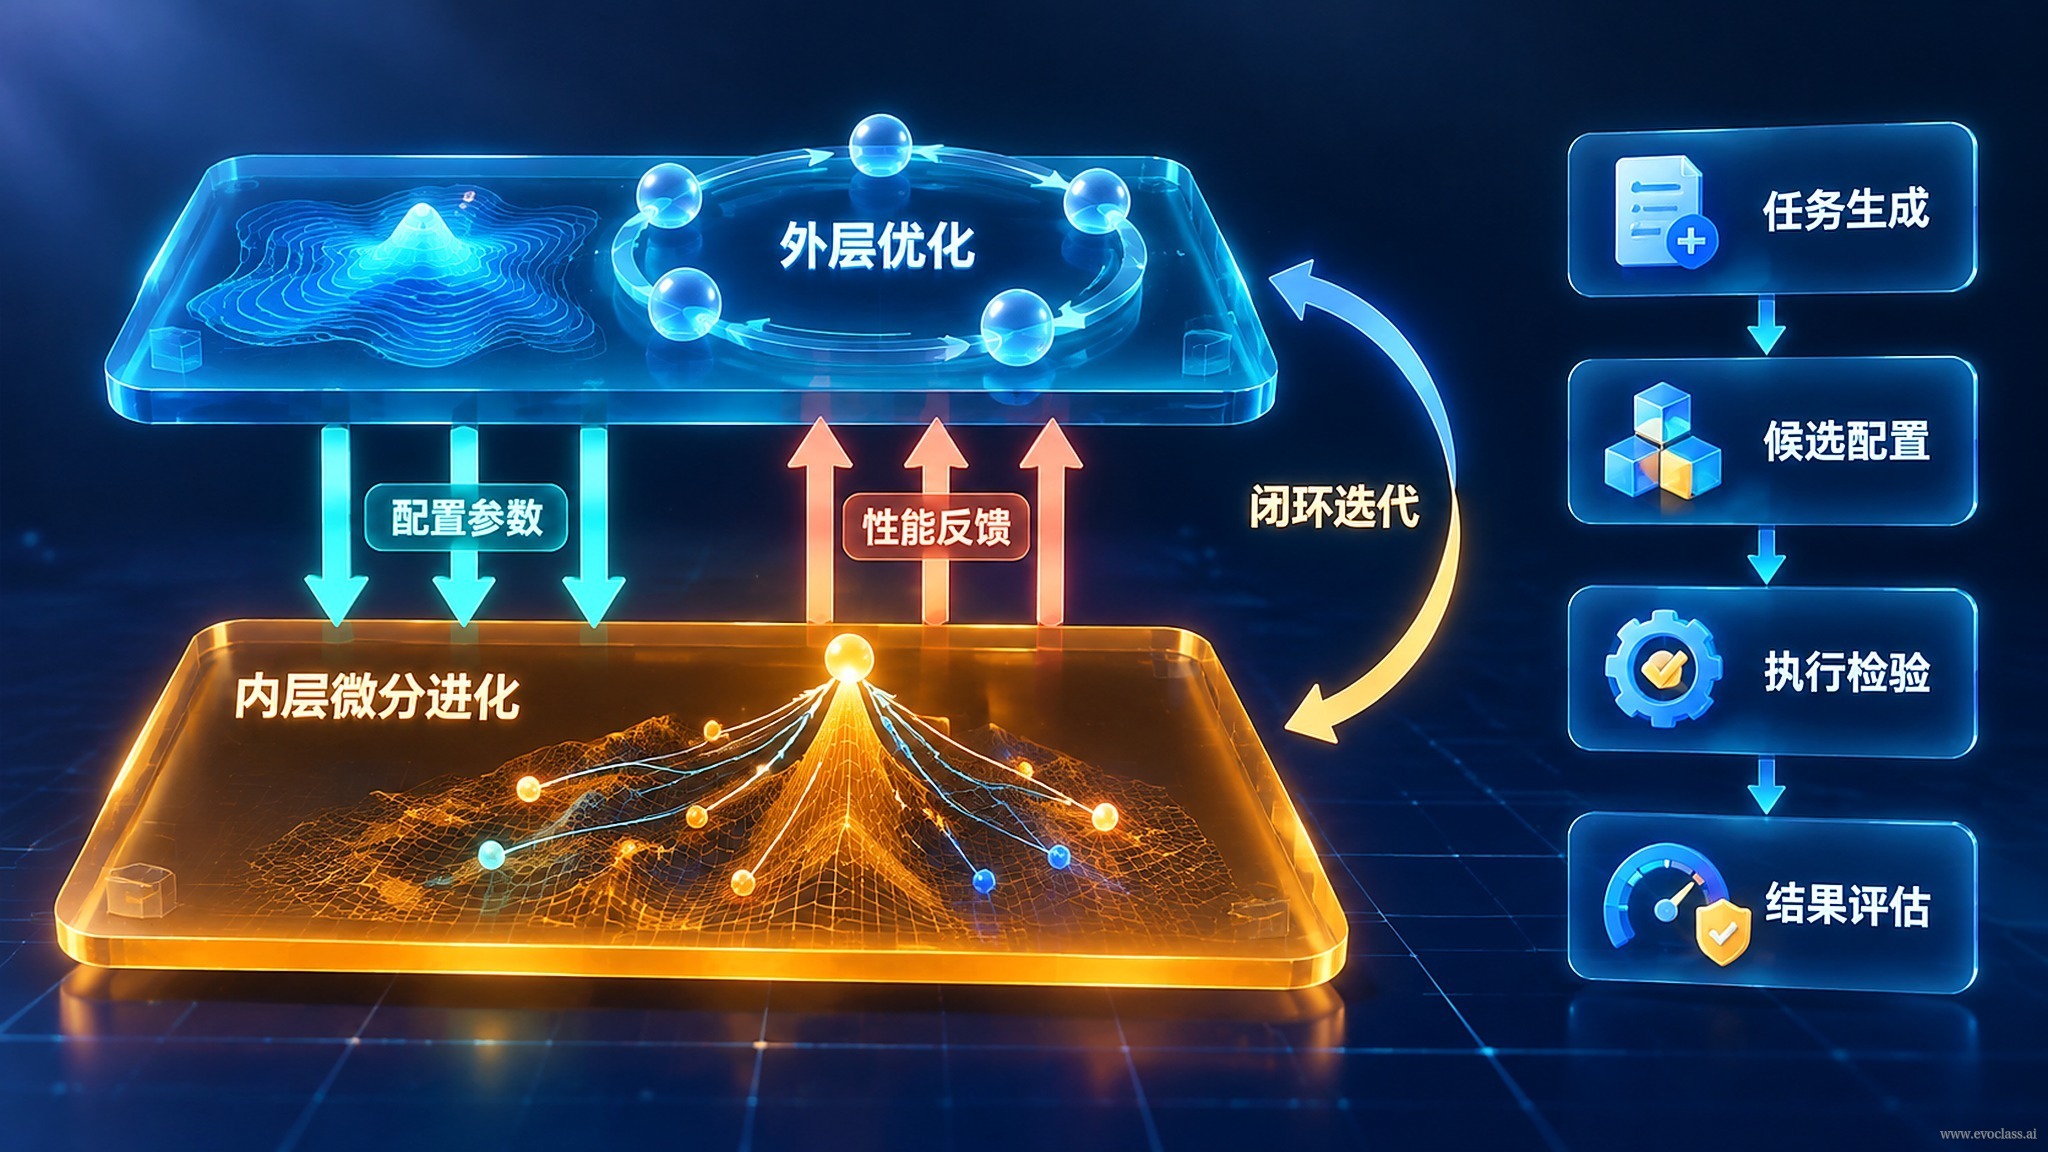
従来の差分進化(DE)では、変異戦略と主要な制御パラメータを研究者が事前に設定し、探索プロセス全体を通じて固定していました。MetaDE の核心的な転換点は次のとおりです:アルゴリズム自身の設定も進化の対象として扱う——外層の進化はアルゴリズム空間を探索し、内層は解空間での性能を評価します。これにより「どのように進化させるか」を人手による事前設定から適応的な探索へと転換します。
二層構造:外層はアルゴリズムを探索し、内層は問題を解く
- 内層:元の最適化タスクにおける差分進化の通常の求解プロセスであり、実際のタスク性能を与える役割を担う。
- 外層:1 つの DE アルゴリズム設定を 1 個体として、設定空間に対して選択・交叉・変異・淘汰を実行する。
二層の役割は混同してはならない:外層の最適化対象はアルゴリズム設定であり、内層の最適化対象は問題の解である。前者は「どのように探索するか」を決め、後者は「どれだけ良く探索できるか」を決める。
外層で進化するものとは
外層の個体がコード化するのは数個の数値ではなく、アルゴリズムの挙動全体です:変異戦略(rand/1、best/1、current-to-best/1 など)、交叉方式(二項交叉、指数交叉)、さらにスケーリング因子 F、交叉確率 CR、集団サイズなどの制御パラメータです。個体間の差異は、同一アルゴリズムファミリーが異なる問題特性に対して示す挙動傾向の違いに対応します。
検証ループ:候補設定は必ず実際に一度実行する
各候補設定は、メタ指標や事前の判断だけで採否を決めることはできず、元のタスクに投入して実際に実行し、実性能による検証を受けなければなりません。そのうえで外層は、内層からフィードバックされた適応度に基づいて選択・淘汰・保持を実行し、どの設定が継承・伝播されるかを決定します。これにより「設定生成 → タスク検証 → フィードバックによる取捨」という反復ループが形成され、外層の適応度は内層の実際の実行結果からのみ得られます。
固定 DE との違い
従来の DE では戦略とパラメータを研究者が事前に設定し、全過程を通じて固定していました。MetaDE はこの決定権を外層の進化に委ねることで、アルゴリズムに問題特性への適応能力を持たせます——例えば探索の初期には探索性の高い rand/1 と大きな F を好み、後期には収束の速い best/1 と小さな F へと切り替えます。
コストと前提条件
各候補設定は内層タスクを完全に一度実行する必要があり(通常、ランダム性を抑えるために複数回の独立実行の平均値を取る)、評価コストは外層の集団サイズと世代数に応じて倍々に膨らみます。そのため MetaDE は並列化、テンソル化、ランタイムスケジューリングといったエンジニアリング基盤に強く依存します——これこそがテンソル化 Runtime の上に構築する必要があるエンジニアリング上の理由です。
位置づけ:MetaDE は「内外二層の進化と適応メカニズム」を思想から実装可能なアーキテクチャへと具体化したものであり、後続のアルゴリズム構造進化(AutoPSO、EvoGO)に方法論的なパラダイムを提供します。
MetaDE の二層構造とタスク検証フロー図は MetaDE の二層フローを示しています:外層は一整套の DE 設定を個体として選択・交叉・変異・淘汰を行い、候補設定は必ず内層の元のタスクに投入して実際に実行し、通常は複数回の独立実行の平均適応度を取り、そのフィードバックによって保持と伝播を決定します。これにより変異戦略、交叉方式、F、CR などの設定を人手による事前設定から適応的探索へと転換します。