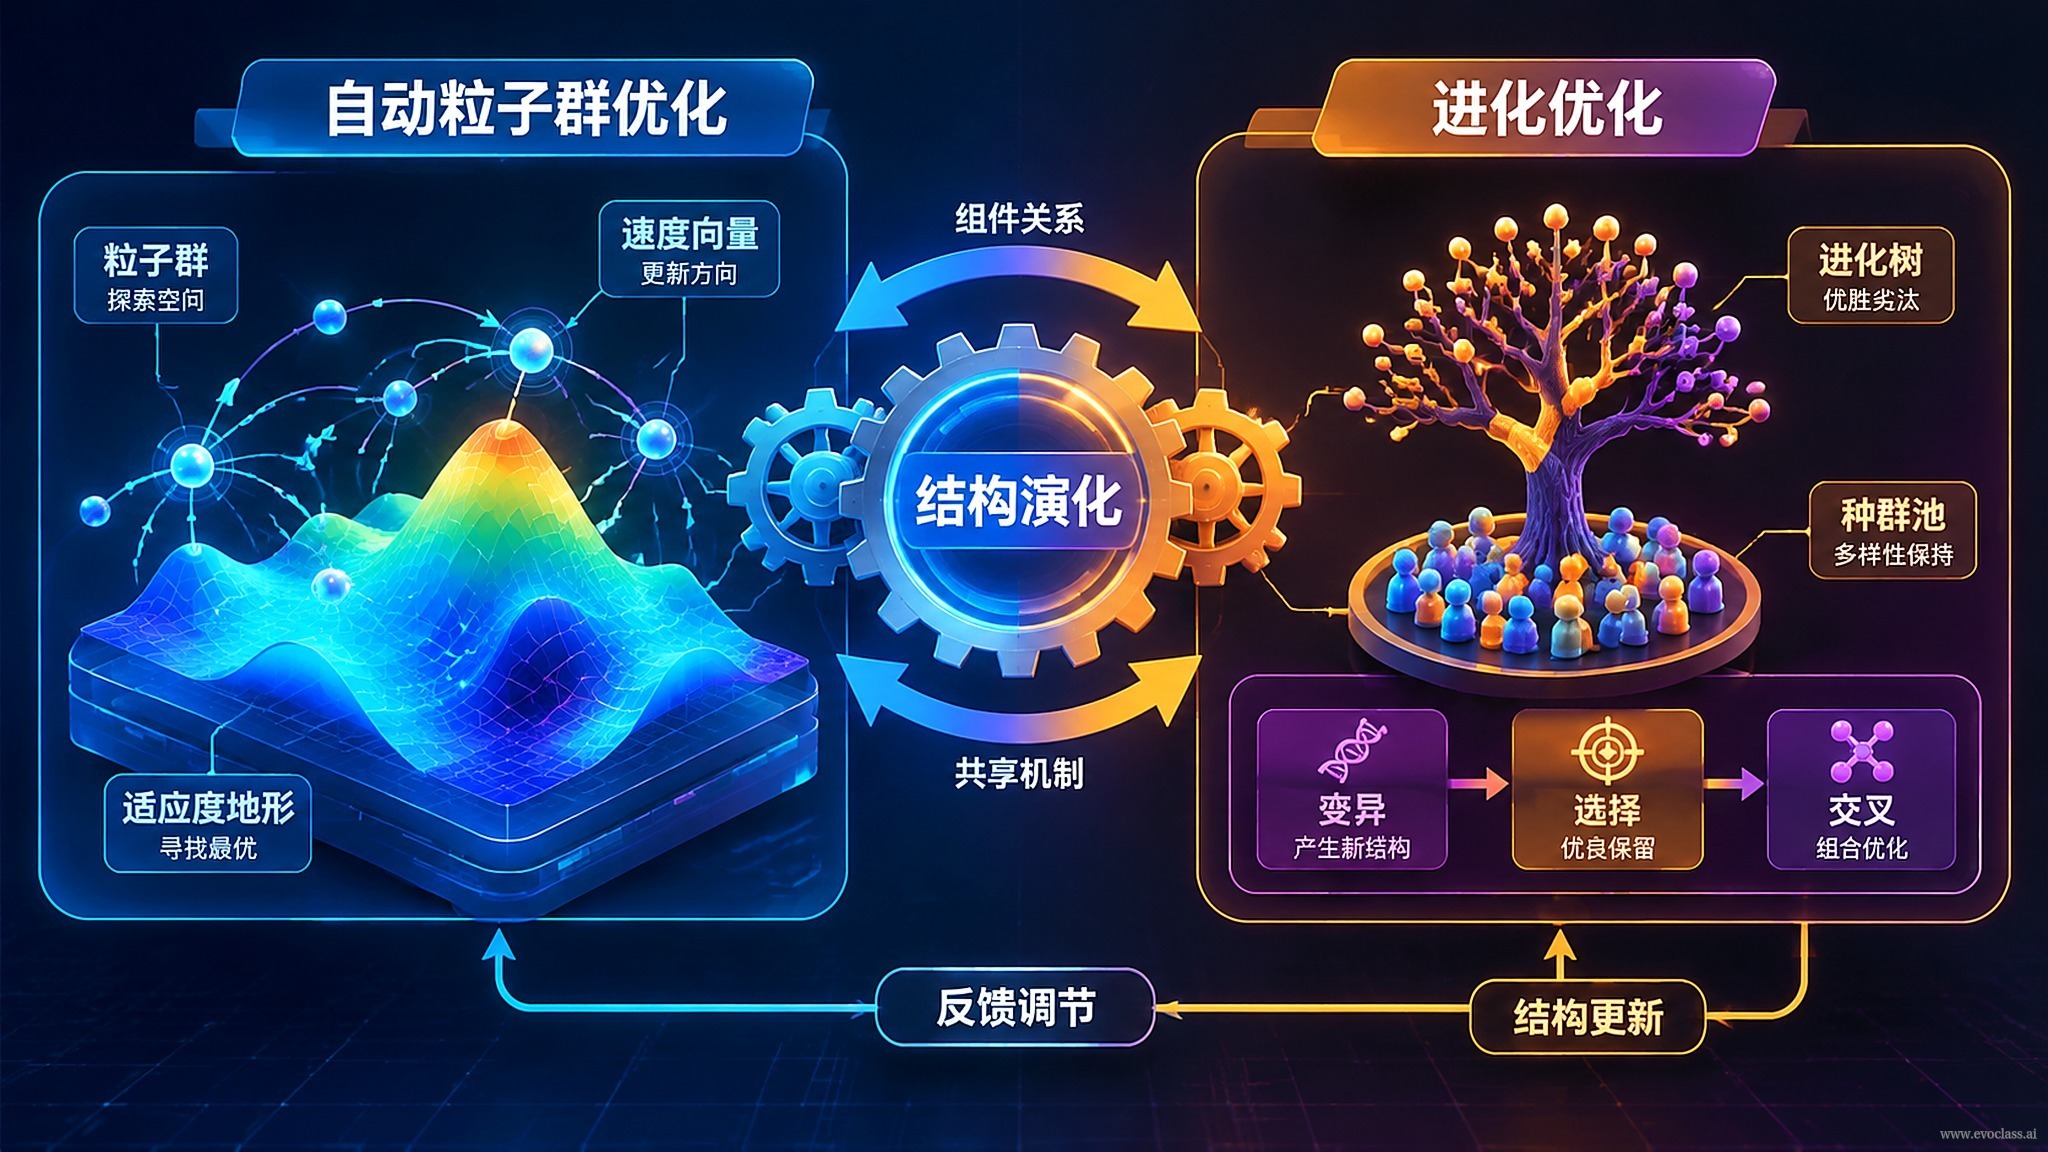
MetaDE のような手法では、進化はパラメータ層で起こります。内層アルゴリズムが実際のタスクを解き、外層アルゴリズムが内層アルゴリズムの設定と戦略を調整します。一方、 AutoPSO と EvoGO は、進化の対象をもう一段上へ引き上げます——すなわちアルゴリズム構造そのものを直接進化させます。コンポーネントをどう組み合わせるか、候補をどう生成するか、更新規則をどう組織するか、という点です。
判断基準:外層は結局何を探索しているのか
「パラメータ調整」と「構造変更」を区別するには、手法の名前を見るのではなく、外層の探索空間の階層を見る必要があります。MetaDE のような手法の外層探索空間は、内層アルゴリズムの設定と戦略(学習因子、突然変異確率、選択圧などの値)です。一方、AutoPSO / EvoGO の外層探索空間はアルゴリズム構造——どのコンポーネントが組み合わせに関与するか、候補生成の流れがどのような形か、状態をどう更新するか——です。
- パラメータ層:構造は固定で、数値のみを調整。到達可能な範囲は行動の「強度」。
- 構造層:コンポーネントと接続方式が可変。到達可能な範囲は行動の「形態」。
AutoPSO:古典的 PSO をコンポーネントプールに分解
古典的 PSO の速度—位置更新公式はハードコードされています。AutoPSO はこのプロセスを組み合わせ可能なコンポーネント——速度項、近傍トポロジ、摂動項、再起動戦略など——に分解し、外層の進化がそれらを選んで新しい候補生成器として組み立てます。もはや固定された古典的更新構造を踏襲するのではなく、「更新構造」そのものを探索可能な変数とします。学習因子の調整は行動の強度を変えるだけであり、コンポーネントの組み合わせを変えてこそ行動の形態が変わります。
EvoGO:履歴フィードバックに構造の変更方向を決めさせる
EvoGO は、履歴フィードバックを構造進化の経路に組み込むことに重点を置きます。過去の探索軌跡と性能記録は、もはや「解の選択」だけに用いられるのではなく、「構造が次のステップでどこを変更するか」を決めるために用いられます。これによりフィードバックは、結果のフィルターから構造更新のハンドルへと変わります——それは、完了した候補の中から良い結果を一つ選ぶだけでなく、次ラウンドの構造候補の方向を変えるのです。
共有される二層の骨格とエンジニアリング上の意味
両者は同一の骨格を共有します。内層アルゴリズムが実際のタスク上で実行され、外層が内層の性能に基づいて構造を進化させます。鍵となる前提はサンプル密度です——GPU で大量の内層タスクを並列バッチ実行することで、「構造—性能」の対応サンプルが十分に密になり、外層の選択が統計的な意味を持ち、単一実行のノイズに左右されなくなります。
AutoPSO と EvoGO の構造進化の関係図はパラメータ層と構造層の進化を対比しています。MetaDE の外層は学習因子や突然変異確率などの設定値を探索し、アルゴリズム構造は固定です。一方、AutoPSO と EvoGO の外層は、コンポーネントの組み合わせ方、候補生成と更新規則の組織方法を探索します。AutoPSO は PSO の更新を速度項、近傍トポロジ、摂動、再起動などのコンポーネントプールに分解し、外層が選んで組み立てます。EvoGO は履歴軌跡のフィードバックを用いて、構造が次のステップでどこを変更するかを決めます。