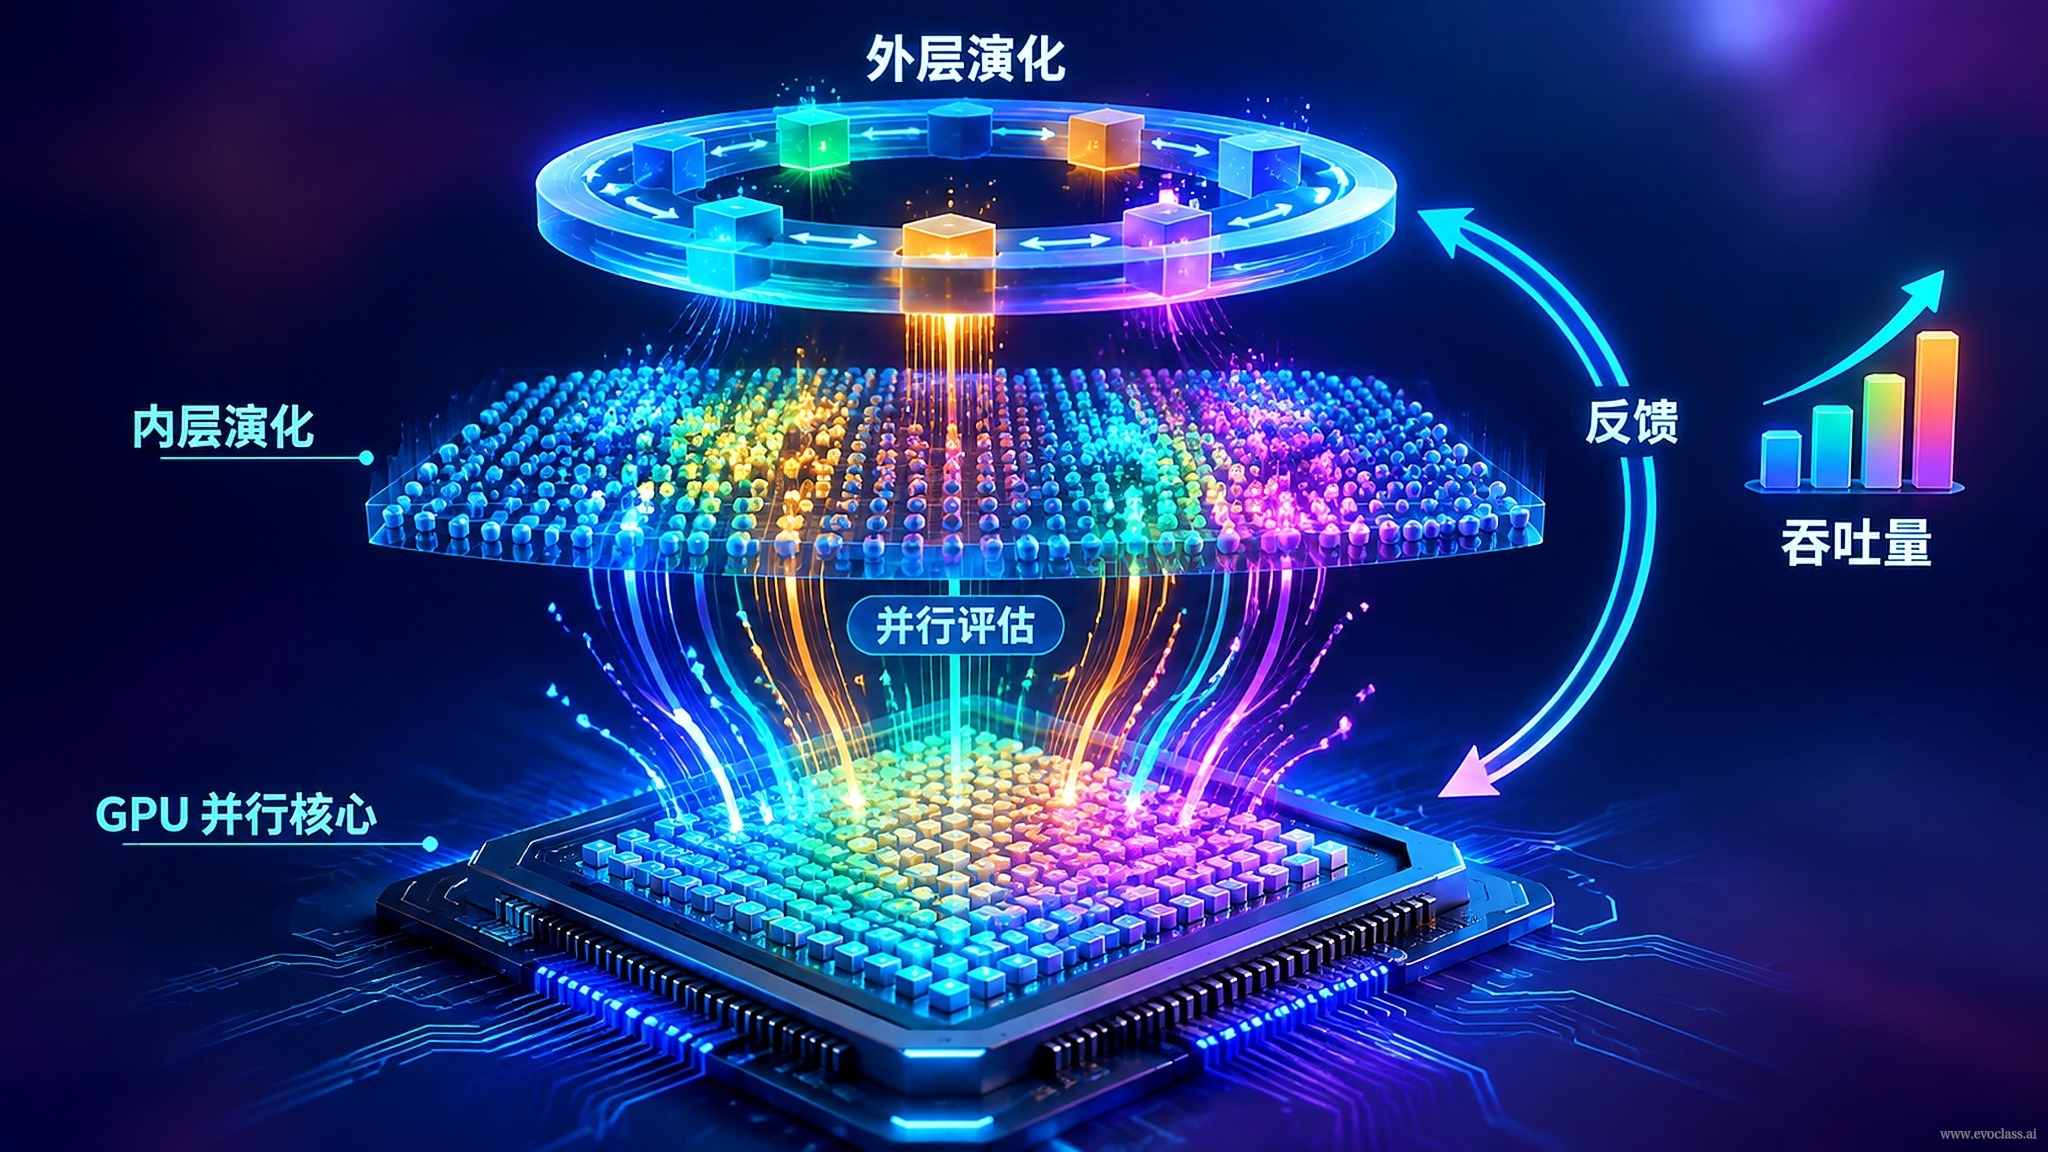
進化アルゴリズムが進化アルゴリズム自身を改善するために用いられる場合、システム内には二層の計算が同時に存在します。内層では多数のアルゴリズム設定が多くのタスクインスタンス上で実行・評価され、外層ではその実行結果に基づいて設定の選択・変異・更新が行われます。強力な並列基盤がなければ、外層の進化は内層の逐次評価によってボトルネックとなってしまいます。GPU並列こそが、「進化による進化の改善」を理論上の構想から高スループットの実行可能なプロセスへと変える鍵です。内層のタスクはバッチで並列実行され、パフォーマンスデータを絶えず生み出し、外層の進化はそのデータをフィードバックとして、より優れたアルゴリズム設定を選び続けます。
二層がそれぞれの役割を担う
- 内層(実行と評価):GPU上で多数の候補アルゴリズム設定(異なるハイパーパラメータ、演算子、探索戦略)をバッチ実行し、各タスクインスタンスごとに実行とスコアリングを完了します。タスクの粒度が小さく数が多いため、GPUのバッチ処理スループット特性にぴったり合致します。
- 中間層(フィードバック集約):膨大な内層タスクの生のパフォーマンスを統計指標に集約し、各設定がタスク分布全体において優れているか劣っているかを推定し、外層で使用する適応度を形成します。
- 外層(設定選択):統計フィードバックを入力として選択・変異・更新を実行し、次世代の設定を生成して内層に送り返すことで、クローズドループを構成します。
GPU並列が代替不可能な理由
従来の逐次ループでは、1回のイテレーションの実時間は「候補設定数 × タスクサンプル数」によって決まり、規模が少し大きくなるだけで耐えられなくなります。そのため逐次ループが候補設定とタスクサンプルの規模を制限する主要なボトルネックとなります。GPU並列は大量の内層アルゴリズムを同時に実行し、逐次ループを「主要なボトルネック」から「許容できるバッチ処理オーバーヘッド」へと引き下げ、それにより探索可能な設定空間とタスクサンプル量を同時に拡大します。
中核メカニズム:ひとつのクローズドループ
システム全体は次のように要約できます: 「内層タスクの並列スループット → パフォーマンスフィードバックの集約 → 外層の設定選択」 というループです。並列度が高いほどフィードバックサンプルがより十分になり、外層の適応度推定がより安定し、設定改善の方向がより信頼できるものになります。改善された設定は再び下層へ送り返され、次の並列スループットのラウンドへと進みます。まさにこのクローズドループによって、アルゴリズムは継続的な自己最適化能力を備え、「進化による進化の改善」が理論上の構想から効率的で実行可能なプロセスへと変わります。
GPU並列二層進化スループットアーキテクチャ図はひとつのクローズドループを示しています。内層はGPU上で多数の候補アルゴリズム設定をバッチ実行してスコアリングを完了し、中間層は膨大な内層のパフォーマンスを統計指標に集約して適応度を形成し、外層はそれに基づいて選択・変異を行い次世代の設定を生成して内層に送り返します。並列度が高いほどフィードバックサンプルが密になり、外層の設定の優劣に対する推定がより安定し、逐次評価のボトルネックも許容できるバッチ処理オーバーヘッドへと引き下がります。