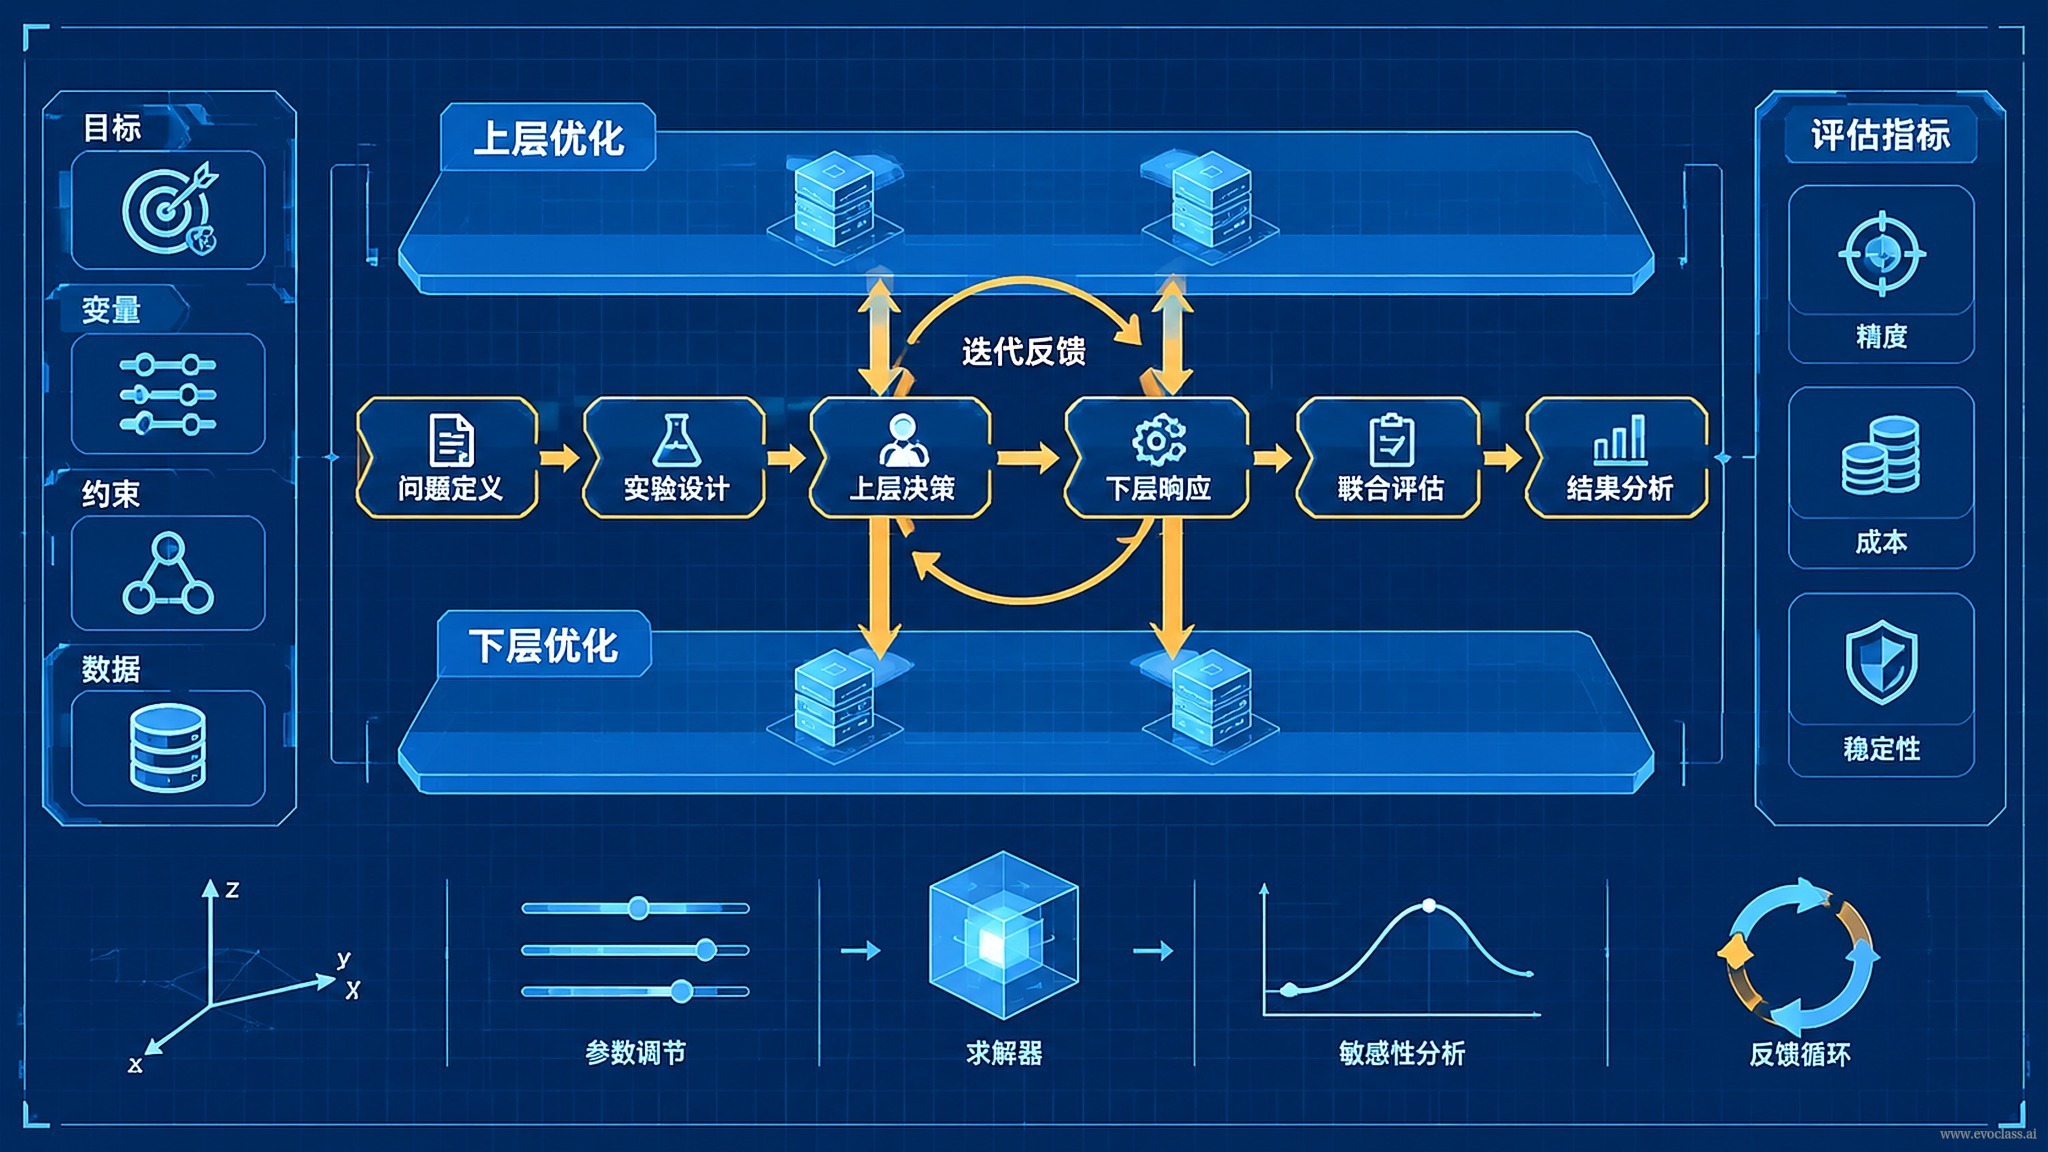
二層最適化実験ブループリントが答えるべき具体的な問いは、次の一つです:差分進化(DE)の変異因子 F は結局いくつに設定すべきか。そのアプローチは手動調整を続けることではなく、F を固定ハイパーパラメータから外層で進化可能な対象へと引き上げ、「ある F 設定で DE 求解タスクを一度実行すること」を内層評価プロセスとして位置づけます;外層は内層のタスク性能に基づいて設定を更新します。このブループリントが機能するのは、EvoX の現代的な計算基盤の上に成り立っているからです:個体群、評価結果、アルゴリズム状態はまとめて計算可能なテンソル,候选配置得以批量变异、批量评价并进入计算图接受编译优化,再由 Runtime スケジューラが計算を GPU、アクセラレータ、または分散クラスタへとディスパッチすることで、本来長大な直列実験サイクルを許容可能な時間枠に圧縮します。
内層タスク:性能を比較可能なシグナルに変える
内層は再現可能な実験です。まず最適化タスクまたはベンチマーク関数集合を選び、次に DE の主体構造、次元、評価予算、ランダムシード集合をすべて固定します——唯一変化する量は、外層から渡される F 設定だけです。各実行では必ず記録します:最良値、収束速度(閾値に到達するまでに要した世代数)、成功率、制約違反量、多目的指標(超体積など)、候補多様性。これらの記録こそが外層が「見る」ことのできるすべての情報であり、外層が良否を判断する唯一の根拠です。評価はテンソル化方式でバッチ実行され、同一バッチの候補は一つの計算グラフを共有することで、個体ごとの直列評価のオーバーヘッドを避けます。
外層戦略オブジェクト:F はもはや定数ではない
外層が探索するのは一つの数値ではなく、一つの F 戦略です。一般的なエンコーディングには三種類あります:定数 F;段階的定数、例えば遺伝子 [F1, F2, F3] を世代区間ごとに切り替える;少数の遺伝子で制御されるスケジュール関数、例えば現在の成功率、個体群分散、世代比率に応じて異なる F をトリガーするもの。戦略型エンコーディングでは、遺伝子そのものに加えて入力特徴量と出力規則を必ず明記しなければなりません。そうでなければ、同じ遺伝子でも実装が異なれば全く異なる結果になります。
マッピング方式:遺伝子型から実行時設定へ
外層の遺伝子型から内層の実行時設定へのマッピングは必ず明示的かつ再現可能でなければなりません。例えば遺伝子 [F開始, F終了, 減衰] は世代に伴い減衰するスケジュールにマッピングされます:F(t) = F開始 + (F終了 − F開始) × e^(−減衰 × t / T)、ここで t は現在の世代、T は総世代数;遺伝子 [F1, F2, F3] は三段定数切り替えにマッピングされます。同じ遺伝子型は常に同じ実行時設定へマッピングされなければなりません。そうでなければ、外層が学習した「良い遺伝子」は説明できず、新しいタスクへも移転できません。
クローズドループの流れと必須ログ
完全なループは次のとおりです:外層個体群が F 設定のバッチを生成 → Runtime スケジューラがテンソル化バッチに従って内層 DE タスクを並列ディスパッチ → GPU バッチ評価 → 指標を集計 → 外層の選択・変異・交叉・更新 → 次のラウンドへ。ここでは EvoX の階層的構成を踏襲します:アルゴリズム層が外層の進化と内層の DE ロジックを担い、問題モジュールがベンチマークタスクを提供し、Runtime スケジューラがバッチ計算を GPU または分散クラスタへディスパッチし、監視モジュールが指標を回収します。クローズドループには再現可能な記録を必ず残さなければなりません:ランダムシード、評価予算、タスク ID、ハードウェアモデル、停止条件。いかなる「外層が勝利した」という結論も、同じ条件下で再実行できるものでなければなりません。
境界条件とベースライン:三層の防御
ノイズ防御:内層評価の変動が大きい場合、単一実行の結果は信頼できません。複数回の独立実行を行い、信頼区間を報告する必要があります;適応度は平均、中央値、または最悪分位点で集約でき、同時に訓練タスクと検証タスクを分けることで、外層がいくつかの幸運なシードにだけ過適合するのを防ぎます。コスト防御:内層タスクが高コストな場合、まず低忠実度モデルや代理評価で粗いスクリーニングを行い、その後少数の候補に対して高忠実度の再評価を行います。ベースライン防御:固定 F = 0.5 と古典的自適應 DE は必ず同一条件下で比較し、さらにアブレーション実験によって、その利益が外層進化そのものに由来するのであって、評価回数の増加に由来するのではないことを確認しなければなりません。外層の探索空間が小さすぎる場合、二層最適化は手動パラメータ調整へと退化してしまいます;その場合は単に予算を増やすのではなく、エンコーディング空間を拡大すべきです。
二層最適化実験ブループリントとフロー図では差分進化の変異因子 F を例にしています:内層はタスク、次元、評価予算、ランダムシードを固定し、外層から渡される F 戦略のみを変化させ、最良値、収束速度、成功率、制約違反量、超体積、候補多様性を記録します;外層は定数 F、区分 F、またはスケジュール関数をエンコードでき、明示的マッピングを経てバッチ評価し、選択・更新します。クローズドループではさらにシード、予算、タスク ID、ハードウェア、停止条件を保持し、結論が再実行可能であることを保証する必要があります。