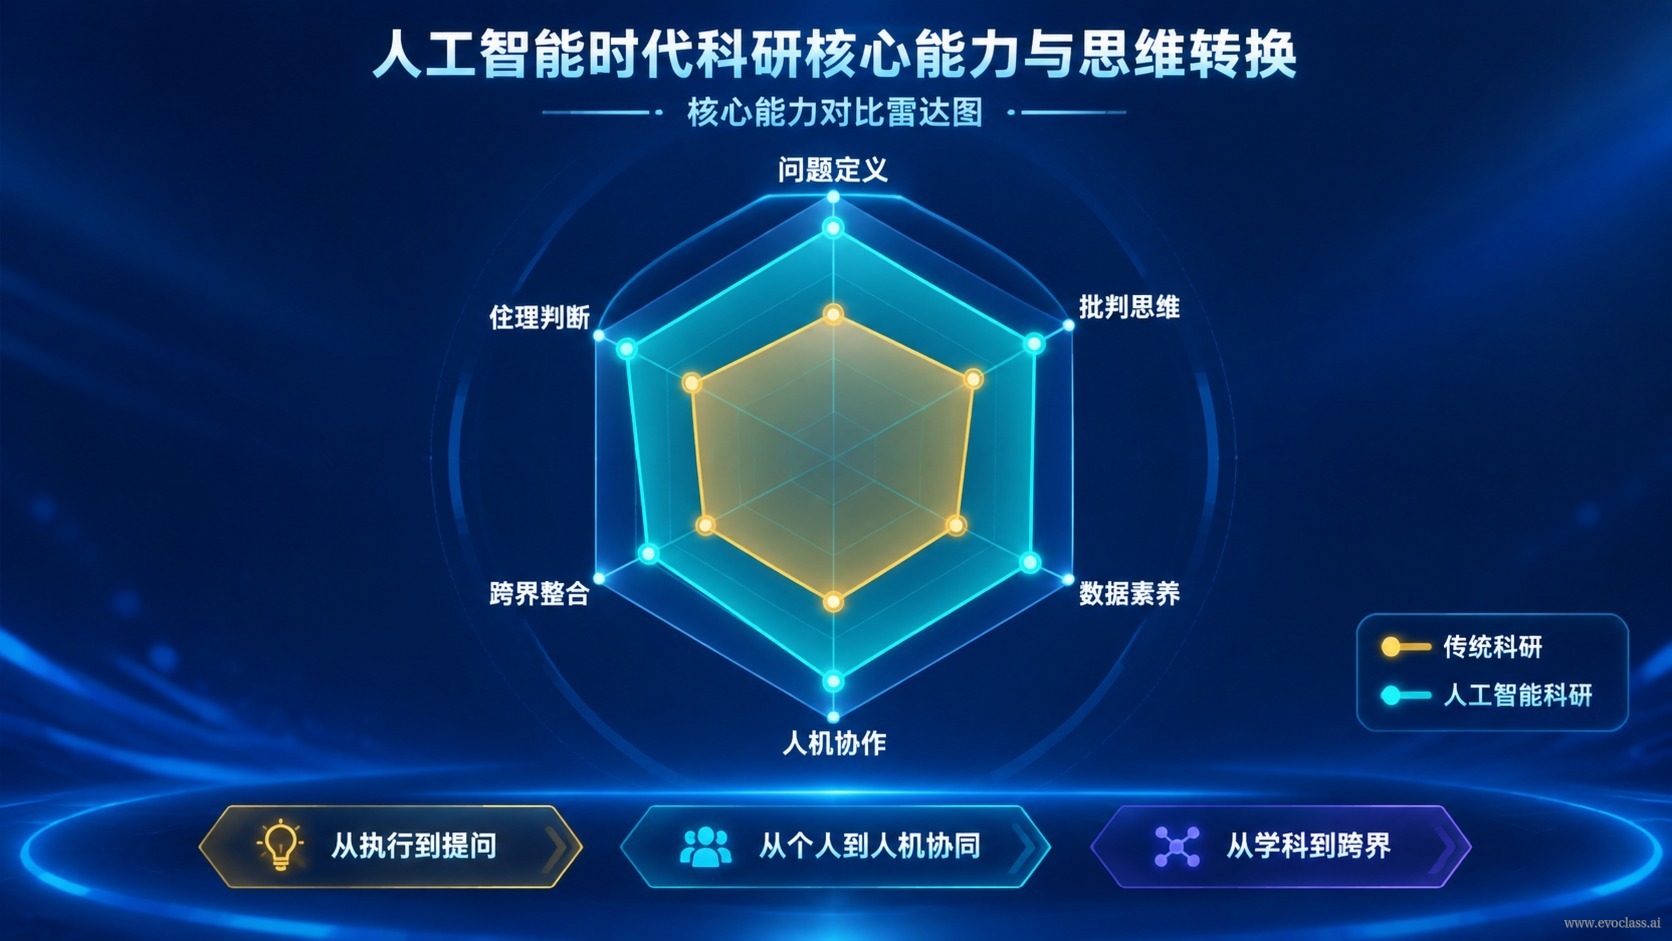
AI 支援型の科学研究において、研究者の核心能力は今、一度の思考の転換を経験しています。かつては「自らの手で実装を書けるかどうか」で能力を測っていましたが、今やコードや実験スクリプトは AI が素早く生成できます。真に希少なのは、重要な問いを立て、評価と公平な比較の基準を定義し、AI が生み出した証拠を批判的に判断する力です。
役割の移行:実装者から証拠の裁定者へ
実装コストが大幅に下がると、研究者の役割は「実装者」から問題定義者・実験設計者・証拠の裁定者へと上昇します。AI はアイデアを実行可能な答えに変える役割を担いますが、「どの問いに答える価値があるか、どの証拠を信じるべきか」は依然として研究者が決めるのです。
- 問題定義者:どのような問題が科学的価値を持つかを見極めること。最も結果を出しやすい問題ではない。
- 実験設計者:曖昧なアイデアを実行可能で再現可能、比較可能な実験プロトコルへ変換すること。
- 証拠の裁定者:AI が示す曲線・指標・結論に懐疑を持ち、その信頼できる境界と失敗条件を問いただすこと。
人間が答えるべき 3 つの重要な問い
- 変更対象:今回動かすのは最適化パラメータ、プログラム実装、アルゴリズム構造、それとも研究プロセスそのものか?変更の階層が異なれば、結論の意味もまったく異なる。
- 評価フィードバック:どの指標で観測するか、どの代理信号で真の目標を近似するか、合格ラインをどこに置くか、どのような場合を失敗と判定するか——この 4 つはどれも欠かせない。
- 公平な比較:ベースライン、予算、ランダム性、計算資源の条件、統計的検定が揃っているか。揃っていない比較では、ランダムな変動や計算資源の優位がアルゴリズムの進歩と誤読されがちである。
なぜ「センス」が決定的に重要なのか
AI は「動く」案を大量に生成できるが、実行可能であることは価値があることとは違う。Taste matters:数多くの実行可能な案の中から、どの問題、どの仮説、どの証拠が真に科学的価値を持つかを見極めることこそ、人間の研究者の核心的価値である。それに伴い、能力の重心は単なるコーディング速度から、批判的思考、システムの抽象化、領域的判断、人と AI の役割分担へと移っていく。
ケース:EvoX / MetaDE 系のタスク
AI は 1 日で数十個の変異オペレータの変種と、それに付随する実験スクリプトを生成できる。しかし研究者は決めなければならない:変異オペレータを改善するのか、評価プロセスを最適化するのか、それとも探索空間を再構築するのか?そしてそれに基づき多目的指標と公平なベースラインを設定する。そうしなければ、「動く」結果しか得られず、信頼できる知識にはならない。
核心能力の移行この図は能力比較の形で、AI 時代における科学研究能力の重心の移行を示している。実装が素早く生み出せるようになると、研究者のより本質的な価値は、重要な問いの提起、再現可能な実験の設計、証拠の境界の判断、そしてベースライン・予算・統計的検定の公平な整合へと移っていく。
核心能力の移行
この図は能力比較の形で、AI 時代における科学研究能力の重心の移行を示している。実装が素早く生み出せるようになると、研究者のより本質的な価値は、重要な問いの提起、再現可能な実験の設計、証拠の境界の判断、そしてベースライン・予算・統計的検定の公平な整合へと移っていく。