従来の進化的計算は、ハイパーパラメータ・重み・連続変数など、低次元で事前定義された数値パラメータベクトルを主な対象としており、その探索空間は人手で設定された構造と符号化方式によって限定されていた。計算規模とエンジニアリング基盤が拡大するにつれ、高次元・離散・構造化された対象の探索は不可能から処理可能へと変わり、探索の境界は計算資源とツールチェーンとともに外へ広がっていく。
これを踏まえ、大規模モデルはコード理解・文脈推論・候補生成の能力を備え、プログラムレベルの対象を直接構築・修正・評価できるため、符号化方式や突然変異演算子を人手で設計する必要性が低下する。計算資源の規模が拡大した後も、候補を生成する方法自体が人手で事前に固定されたままであれば、システムは既定のパターンを繰り返すしかない。候補生成の方法そのものを進化の対象に組み込むこと(例えば差分進化の変異戦略とパラメータ設定)こそ、この境界拡張が方法論のレベルで直接的に表れているものである。
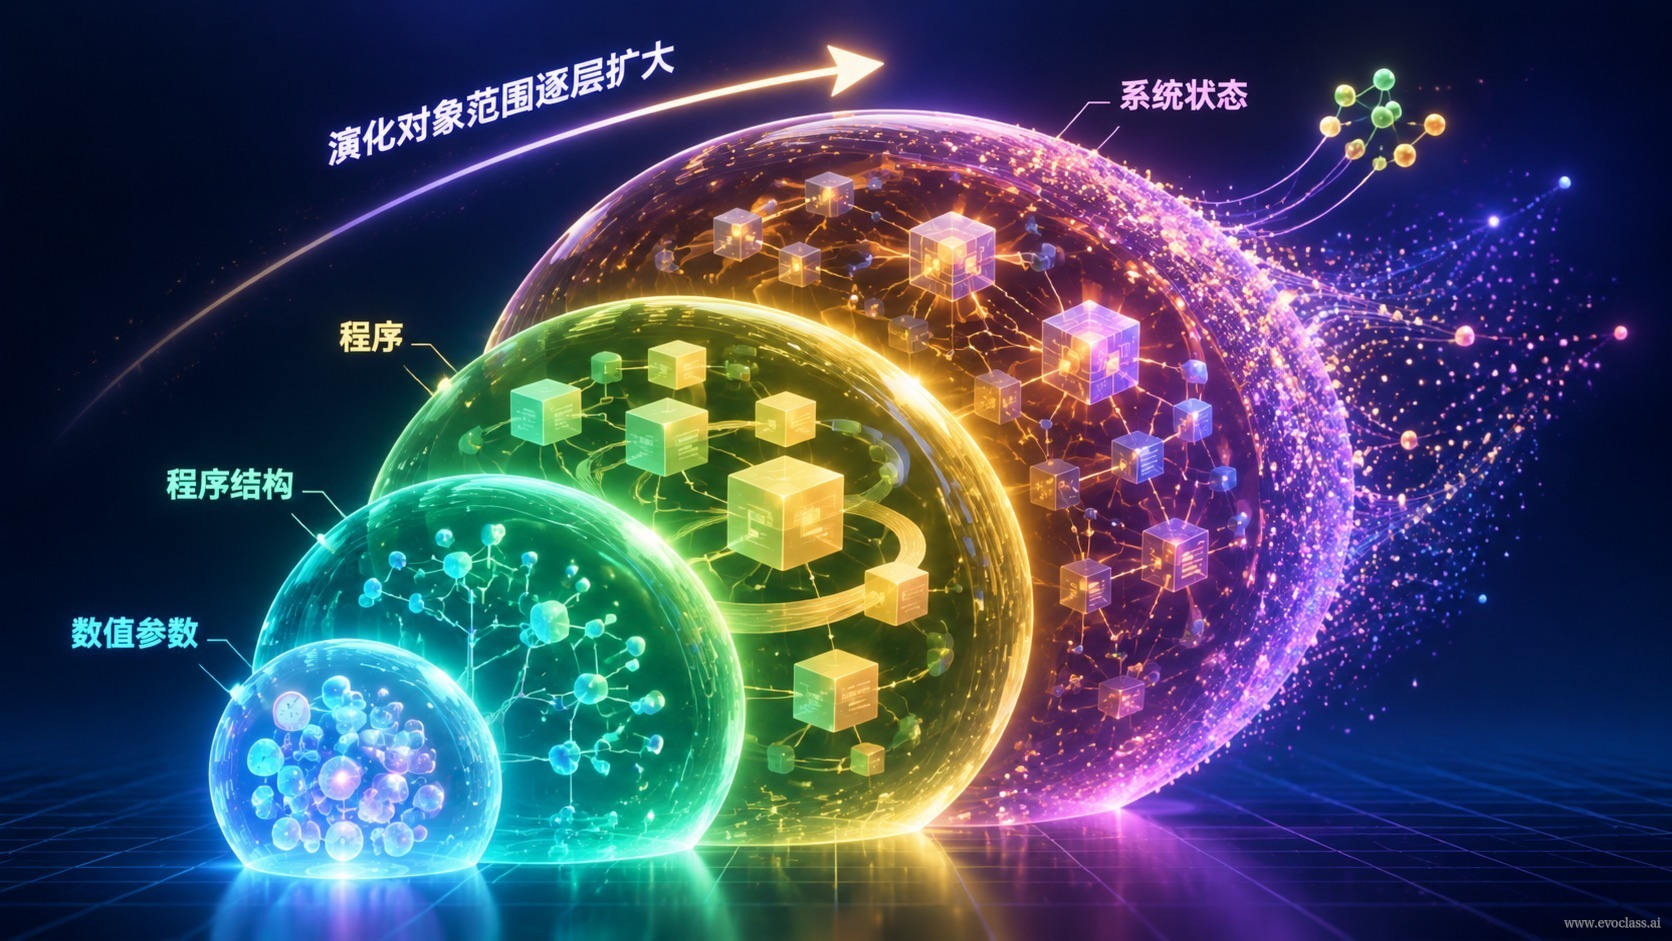
下図はこの階層的拡張の構造を示している。
このように、進化の対象は階層的に拡張される:数値パラメータ → モデル構造 → アルゴリズムの仕組み → プログラムとソフトウェアエンジニアリングの状態。階層が高くなるほど意味的制約は強くなり、評価の連鎖も長くなる。候補は実行可能かつ検証可能でなければならず、適応度評価もスカラー関数から実行結果とエンジニアリング制約を組み合わせた判断へと変わる。この拡張はパラメータ最適化を置き換えるものではなく、パラメータ最適化をより大きなプログラム・システム進化のループに組み込み、局所的なパラメータ調整からシステムレベルの改善へと至る連続的なスペクトルを形成するものである。
進化対象が数値パラメータからプログラムシステムへ拡張される階層図図は下から上へ、進化対象の階層的な拡張を示している:数値パラメータ、モデル構造、アルゴリズムの仕組み、そしてプログラムとソフトウェアエンジニアリングの状態へと至る。階層が高くなるほど意味的制約は強くなり評価の連鎖も長くなり、候補は実行可能かつ検証可能でなければならない。適応度もスカラー関数から実行結果とエンジニアリング制約の組み合わせによる判断へと変わり、それによってパラメータ最適化はより大きなプログラム進化のループに組み込まれる。
進化対象が数値パラメータからプログラムシステムへ拡張される階層図
図は下から上へ、進化対象の階層的な拡張を示している:数値パラメータ、モデル構造、アルゴリズムの仕組み、そしてプログラムとソフトウェアエンジニアリングの状態へと至る。階層が高くなるほど意味的制約は強くなり評価の連鎖も長くなり、候補は実行可能かつ検証可能でなければならない。適応度もスカラー関数から実行結果とエンジニアリング制約の組み合わせによる判断へと変わり、それによってパラメータ最適化はより大きなプログラム進化のループに組み込まれる。