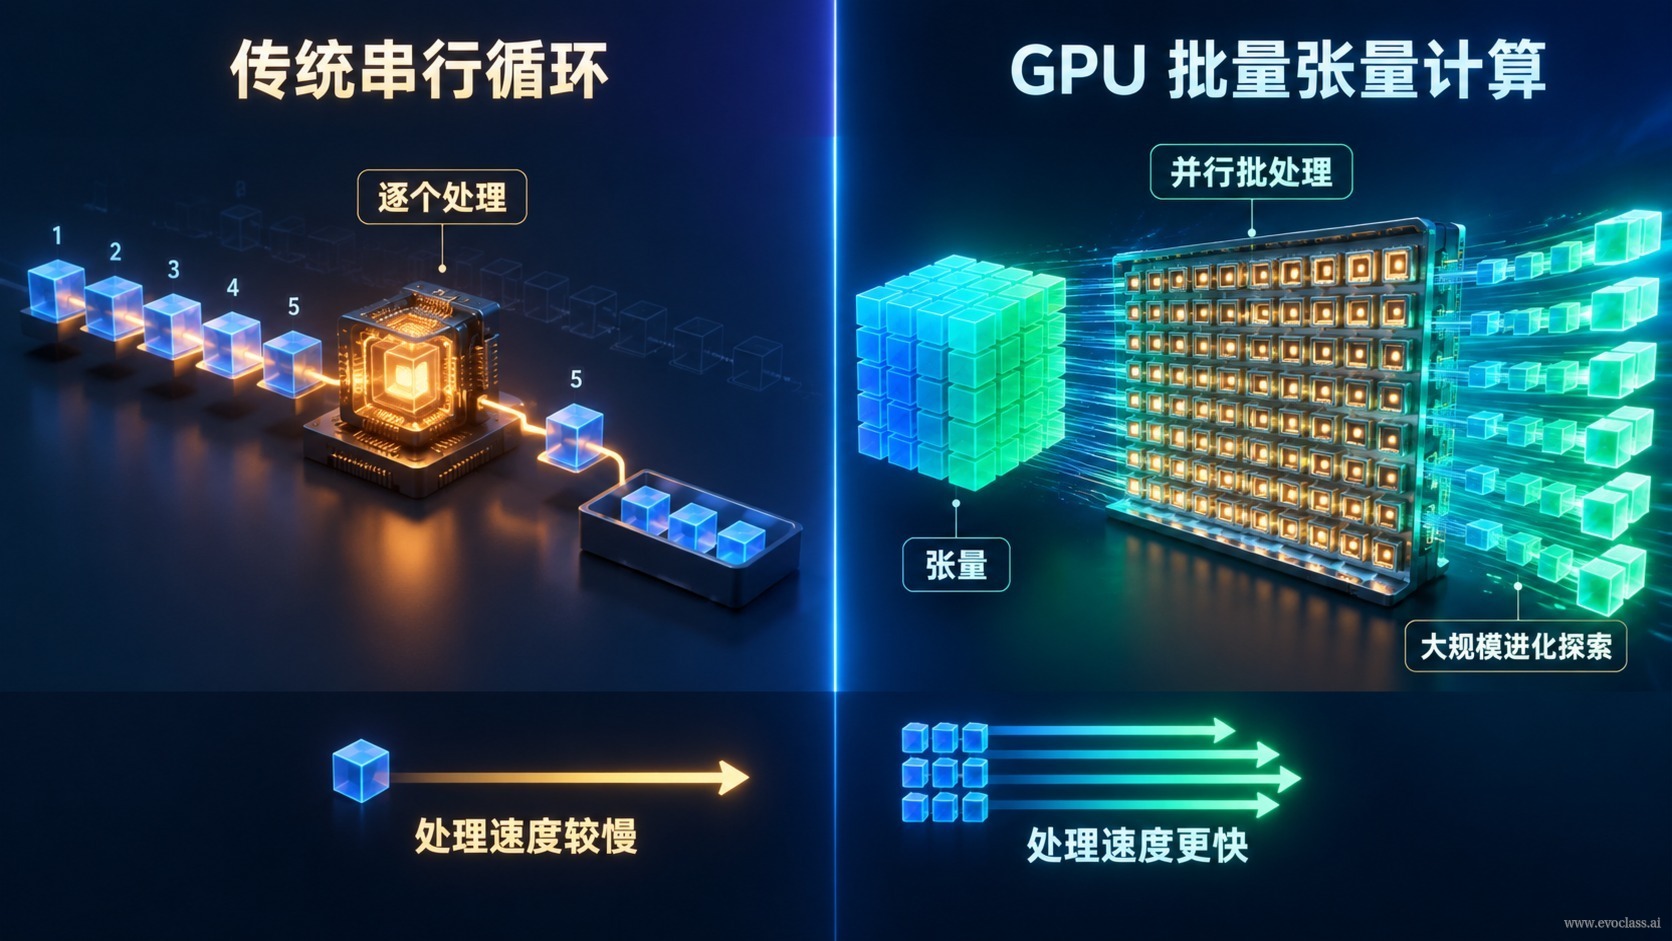
集団規模が数十から数千・数万へと拡大すると、進化計算の真のボトルネックはもはや「良い解を見つけられるか」ではなく、「限られた時間内に十分な数の候補を評価できるか」に移ります。EvoX が示すエンジニアリング上の答えは、互いに支え合う二本の主軸です:テンソル化計算は個体ごとの逐次ループをバッチテンソル演算へと書き換え、統一アーキテクチャはアルゴリズム・問題・ワークフロー・Runtime スケジューリングを分離し、この並列機構をさまざまな進化アルゴリズムやタスクに再利用できるようにします。
多様性にスループットが必要な理由
進化探索は集団の多様性に依存します。候補がより分散しているほど、局所最適から脱出できる確率が高まります。しかし「多様性の維持」は本質的に計算資源の問題です。それは、各世代ごとに大量の候補に対して評価と状態更新を完了させることを要求します。候補を生成する方法が依然として人手で事前に固定され、評価も個体ごとに逐次実行されるなら、システムは既定のパターンを繰り返すしかなく、多様性がもたらす利益は計算スループットのボトルネックによって相殺されてしまいます。
手法進化:「候補を生成する手法」も進化の対象にする
計算資源の規模が拡大すると、EvoX は最適化の対象を一段上へと引き上げます。もはや問題を解くだけでなく、候補解を生成する手法そのものを進化の対象とするのです。これが手法進化です。例えば MetaDE では、内側のアルゴリズムが実際のタスクを解き、外側のアルゴリズムが内側アルゴリズムの設定と戦略(たとえば差分進化の変異戦略やハイパーパラメータ)を進化させ、GPU で多数の内側タスクを並列実行し、そのタスク性能が逆に外側設定の選択を導きます。AutoPSO 与 EvoGO 进一步通过组合粒子群组件、利用历史反馈学习候选生成方式,实现从“改参数”到“改算法结构”的跨越。这种内外双层演化天然要求同一代、乃至同一时刻有大量内层任务被批量评价与状态更新,因此对计算吞吐与并行能力提出更高要求。
テンソル化計算グラフ:ループをバッチテンソルに置き換える
従来の逐次 CPU ループは通常、個体ごとに「評価—記録—更新」を実行し、そのたびに小規模な演算子しか起動しないため、次の三つのコストが生じます:スケジューリングのオーバーヘッドが高い、演算子の断片化、GPU 稼働率の不足。テンソル化計算グラフのアプローチは、集団の維持・バッチ評価・状態更新を全体としてバッチテンソル演算に組織し、同一世代さらには複数世代の候補を並列計算できるようにすることです。たとえば、同一世代に N 個の候補解が含まれる場合、逐次実装は個体ごとにループしますが、テンソル化実装は集団を一つのテンソルに組織し、バッチ評価と並列状態更新を一度に完了させることで、スケジューリングのオーバーヘッドを大幅に削減し、GPU 利用率を高めます。
統一アーキテクチャ:並列機構を再利用可能にする
ループをテンソルに書き換えるだけでは十分ではありません。アルゴリズム・問題・スケジューリングのロジックが互いに結合していると、進化アルゴリズムを変えるたび、あるいはタスクの種類を変えるたびに書き直す必要があります。統一アーキテクチャは、アルゴリズム・問題・ワークフロー・Runtime スケジューリングなどのモジュールを分離することで、テンソル化並列機構をさまざまな進化アルゴリズムやタスク(MetaDE、AutoPSO などの手法進化の場面など)に再利用できるようにします。さらに異種計算資源スケジューリングと組み合わせることで、CPU・GPU などの資源をバッチタスクレベルで管理し、組み合わせ可能で拡張可能な並列探索を支えます。
なぜこれが「基盤」レベルの能力なのか
GPU と大規模モデルがもたらすエンジニアリング基盤により、テンソル化バッチ計算は局所的な最適化から、システムレベルの進化探索を支える基礎能力へと昇華しました。言い換えれば、テンソル化が解決するのは「速く走れること」であり、オープンで分離された統一アーキテクチャが解決するのは「入れ替えが効くこと」です。前者はスループットを提供し、後者は組み合わせ可能で拡張可能な再利用の境界を提供します。この二つが結びついて初めて、高強度で多様性の高い並列進化探索が真にエンジニアリング能力として実現するのです。
串行循环与GPU批量张量计算架构对比图左側の従来型 CPU 逐次処理は個体ごとに「評価—記録—更新」を実行し、小規模な演算子しか起動しないため、スケジューリングのオーバーヘッド増大、演算子の断片化、GPU 稼働率の不足を招きます。右側は集団の維持・バッチ評価・状態更新を全体としてテンソル演算に組織し、同一世代さらには複数世代の候補の計算を一度に完了させ、Runtime スケジューリングから分離することで、並列機構をさまざまなアルゴリズムやタスクに再利用できるようにします。