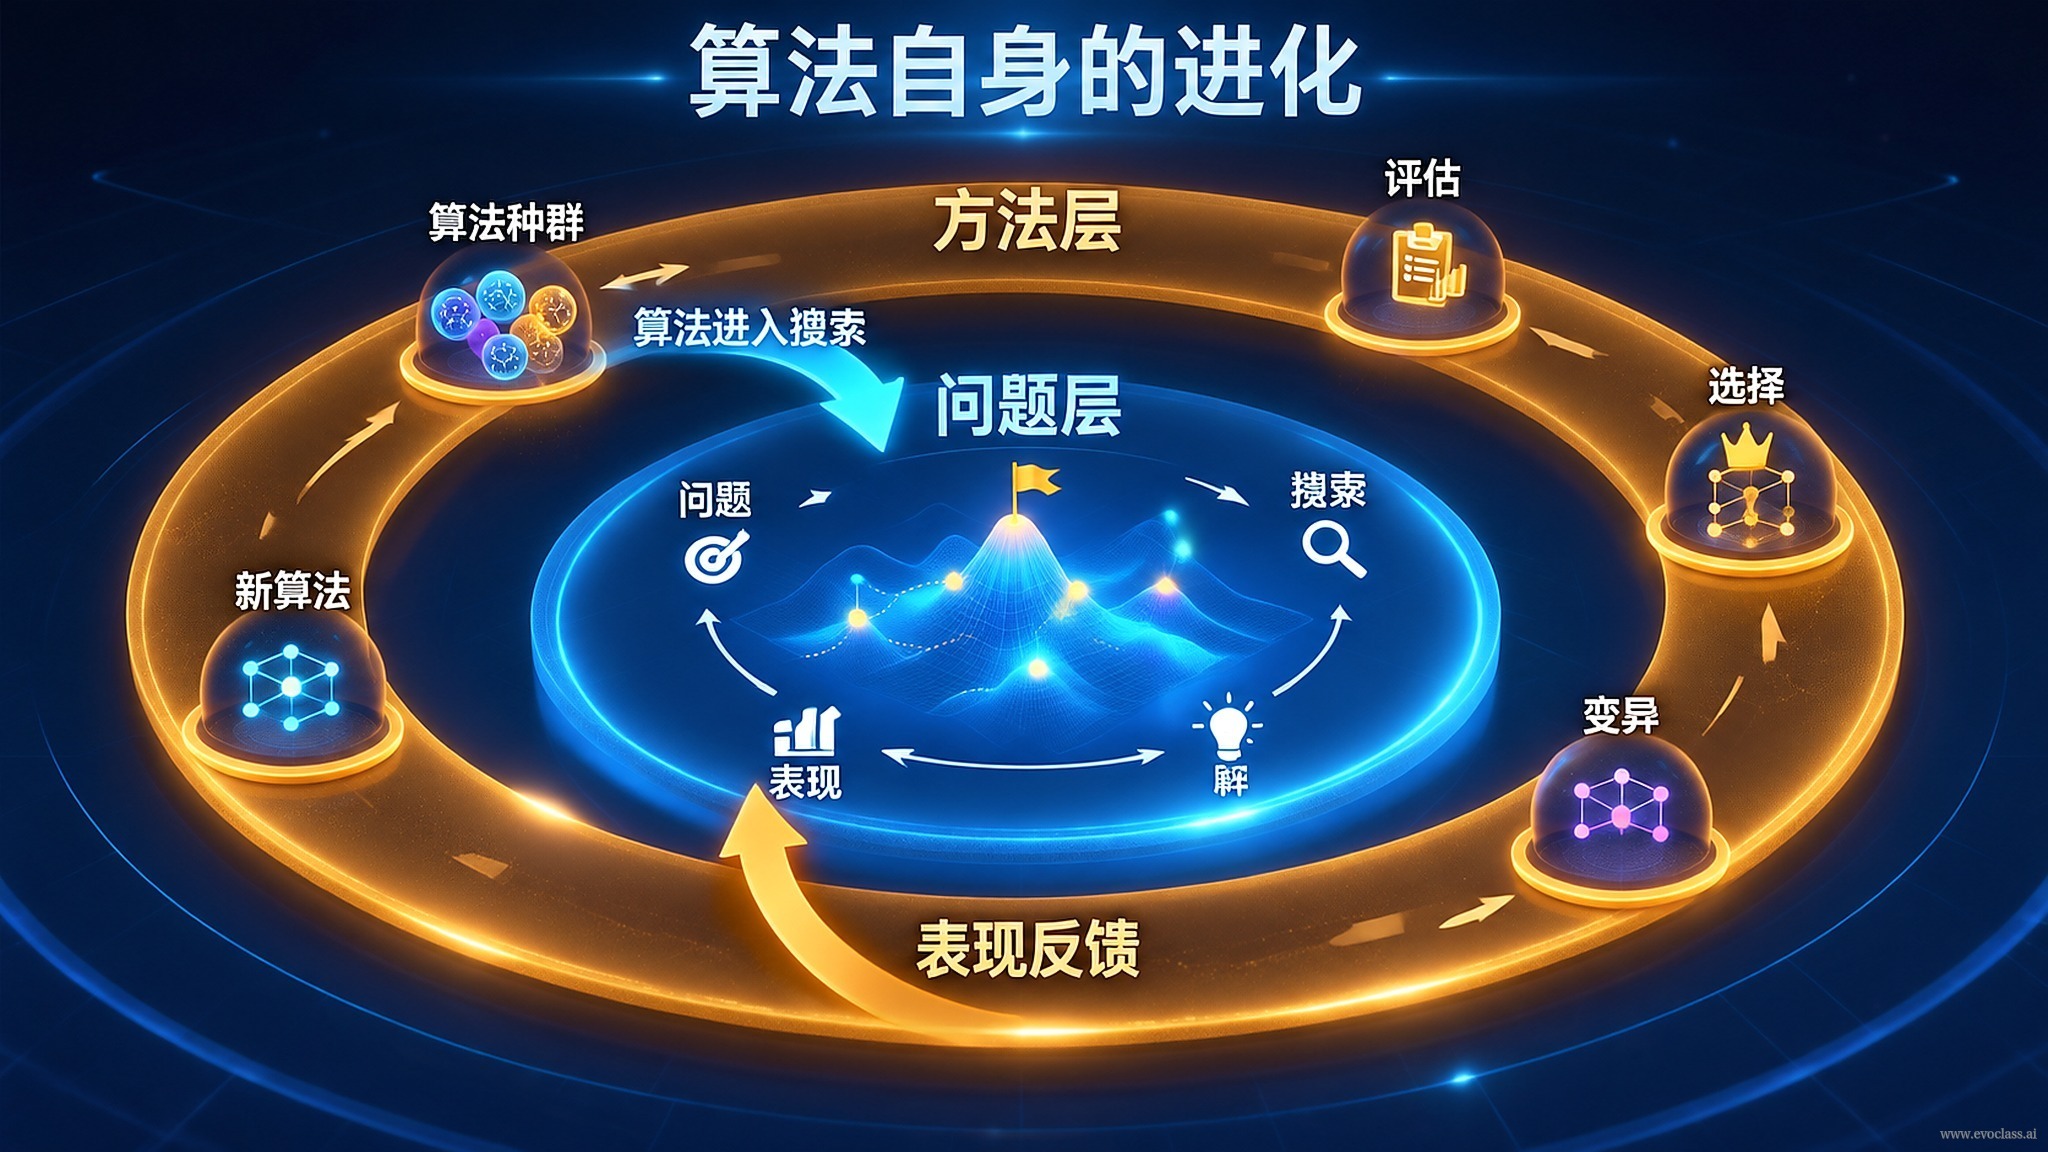
従来の進化アルゴリズムは固定された生成メカニズムの下で動作します。選択・交叉・変異といった「答えをどう生み出すか」のルールは人があらかじめ書き込み、探索は答えの空間内を移動するだけで、最適化される対象は常に候補解でした。しかし計算資源の規模が拡大すると、この前提がむしろ天井となります。候補を生み出す手法が変わらなければ、システムは既定のパターンを繰り返すしかありません。
手法進化(メタ進化)は問題を一段上に押し上げます。アルゴリズムはより良い答えを出力するだけでなく、外側の探索を通じて答えを生み出す戦略・パラメータ・コンポーネントを継続的に改善し、「答えを求める」ことから「手法を改善する」ことへの進化を遂げます。EvoX はまさにこの路線に沿って進められた研究であり、候補生成の手法そのもの(例えば差分進化の変異戦略やパラメータ設定)を進化の対象に組み込みます。
二層のロジック:内層は答えを求め、外層は手法を改める
- 内層:利用現在の手法具体的な問題を解き、候補解を生成します。
- 外層:解の品質・選好信号・安定性・コストなどのフィードバックに基づき、次ラウンドで使用する手法を改善します。
- 探索空間へ引き上げられる対象は、ある一つの解ではなく候補生成メカニズムそのものです。だからこそ、それは評価・選択・更新が可能な対象となるのです。
選好最適化はどの層に置くべきか
選好最適化は上層のフィードバックに関与できますが、二種類の目的を切り分ける必要があります:現在の答えを評価することと答えを生み出す手法を改善すること。「この解がより好ましい」をそのまま「この戦略がより優れている」と読み替えるのは、答えの選好を手法の優劣と偽ることであり、外層探索は単一回の結果のノイズに振り回されてしまいます。
典型的な形態
MetaDE は外層で差分進化の変異戦略とパラメータを進化させ、内層は通常通りタスクを解きます。AutoPSO と EvoGO はさらに粒子群のコンポーネントを組み合わせ、履歴フィードバックを利用して候補生成方式を学習し、「パラメータの変更」から「アルゴリズム構造の変更」への飛躍を実現しました。
何を得て、何を払うか
この転換はアルゴリズム設計を一度きりの人手によるパラメータ調整から持続的な自己適応へと押し進めますが、代償もまた明確です:探索空間の膨張(手法空間は解空間よりはるかに大きい)、評価コストの上昇(各候補手法ごとに内層タスクを実行する必要があり、通常は GPU 並列バッチ評価で薄める必要がある)、検証の複雑さの増大(外層の改善が本当に汎化するかは、独立した検証設計を必要とする)。
二層進化ロジックの構成図図は進化を内外二層に分けています。内層は現在の手法で具体的な問題を解き候補解を生成し、外層は解の品質・選好・安定性・コストなどのフィードバックに基づき、次ラウンドで候補を生成する戦略・パラメータ・コンポーネントを改善します。これにより探索対象は解から候補生成メカニズムへと引き上げられます。
二層進化ロジックの構成図
図は進化を内外二層に分けています。内層は現在の手法で具体的な問題を解き候補解を生成し、外層は解の品質・選好・安定性・コストなどのフィードバックに基づき、次ラウンドで候補を生成する戦略・パラメータ・コンポーネントを改善します。これにより探索対象は解から候補生成メカニズムへと引き上げられます。