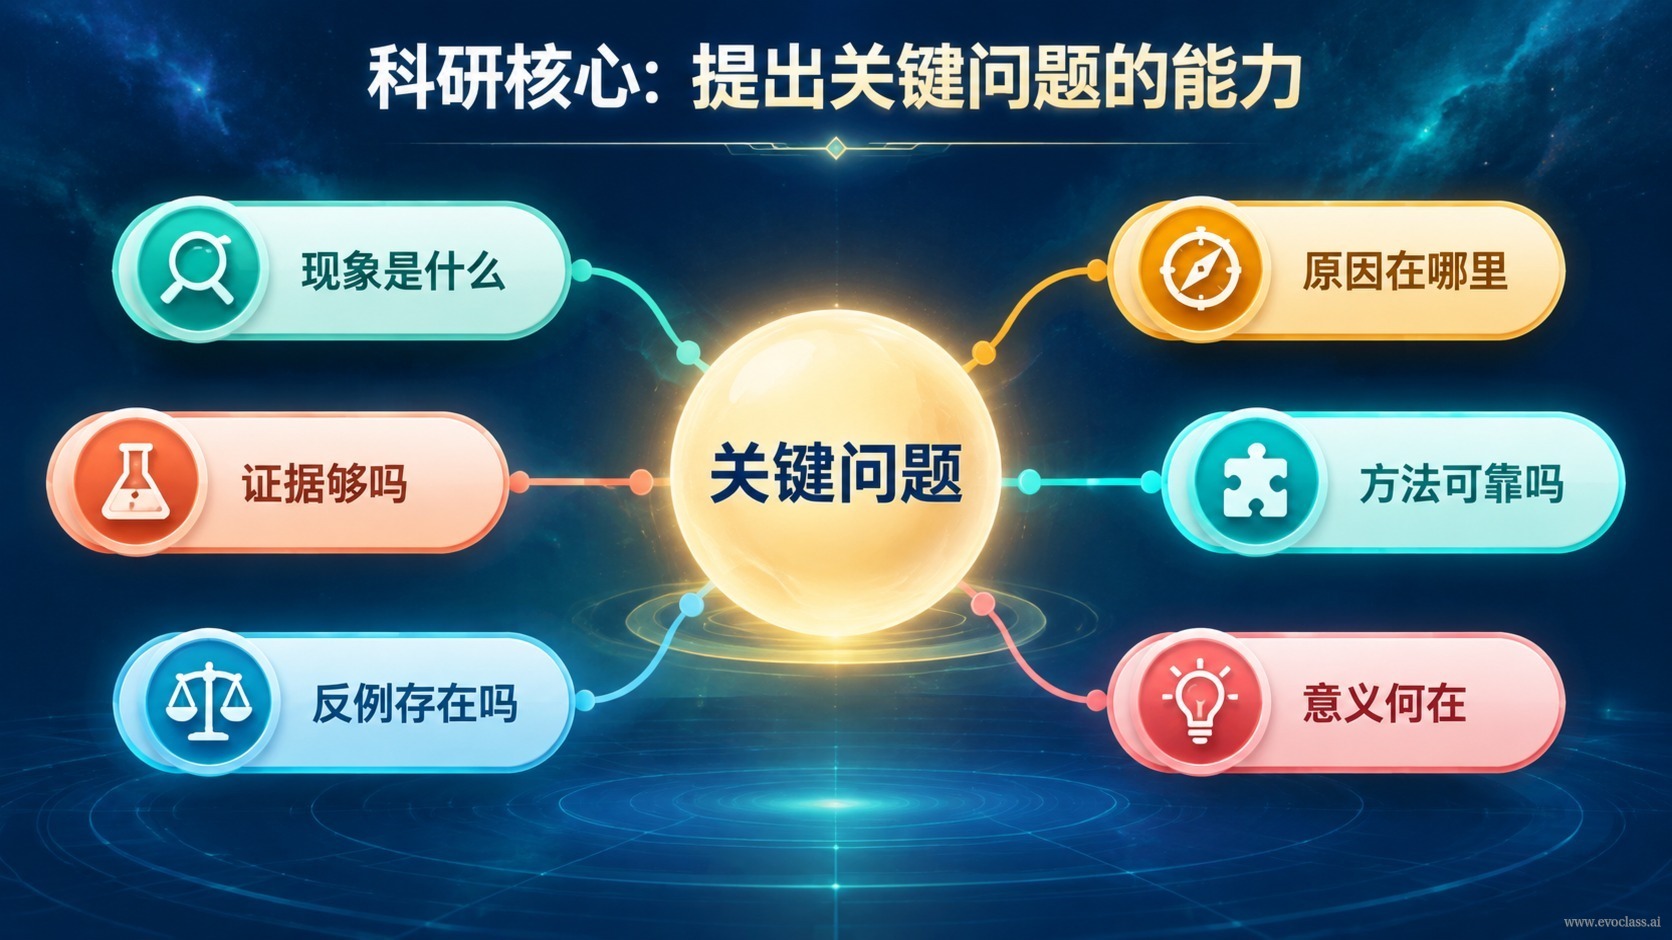
AI Native な研究では、自動プログラミングと大規模モデルの能力によって、「答えを実装する」コストは非常に低くなりました。コード生成、手法の探索、実験の実行はすべて AI に任せられます。答えが安価になったとき、研究の重心は「作れるかどうか」ではなく、やる価値があるか、どこへ向かうべきか——まさにこれが鍵となる問いを立てる力です。
鍵となる問いで明確にすべきこと
鍵となる問いは実装の細部を問い詰めることではなく、曖昧な直感を検証可能・進化可能・分業可能な研究構造へと変換することです。少なくとも次の点を明確に定義する必要があります:
- 真の目標と複数目標のトレードオフ:本当に改善すべき量は何か?複数の目標の間でどう取捨し、どれを優先するか?
- 譲れない制約:どの条件がハードな境界であり、いかなる手法も超えてはならないか?
- 観測可能な評価指標:どの量を、どのような条件で測定すれば、結論が揺るがないものになるか?
- 候補空間の境界:探索と進化の実行可能な範囲はどれほどで、どのような多様性とロバスト性が必要か?
- 検証プロトコルと失敗の判定基準:どれほどの評価予算で、どのような手順で検証し、どのような結果を失敗と判定すべきか?
問いの質が解空間の質を決める
AI が探索する解空間は、問題定義によって範囲が決まります。問題定義が明確であればあるほど、探索と進化は意味のある領域に収まりやすくなり、成果も説明可能で再利用可能になりやすくなります。逆に問題定義が曖昧だと、モデルは広すぎる空間でランダムに試すしかなく、結果は一見実現可能でも蓄積できません。「EvoX で最適化する」を例にすると、鍵となる問いは次のように変換されるべきです:「真のトレードオフは何か?目標と制約をどう定量化するか?評価予算と検証基準は何か?どのような多様性とロバスト性が必要か?どのような結果を失敗と判定すべきか?」こうして初めて、AI は効率的に答えを実装し、人は方向を統制できます。
人と AI の役割分担と研究者の核心的なセンス
人と AI の役割分担の核心は:AI が答えの空間と実行経路を拡張し、人間が方向・取捨の基準・科学的意義を統制する。Genesis のようなシステムレベルの継続的進化の実践では、この点が特に顕著です——候補の修正はコンパイル、テスト、上位層の受け入れ検証を通過して初めて、採用されたプロジェクト版に取り込まれ、その後の作業の歴史的基盤となります。もし鍵となる問いで評価プロトコルと失敗判定基準を明確に定義していなければ、受け入れ検証の関門は判断のしようがなく、AI の成果は一度きりのコード成果物にとどまり、コンテキストやタスク周期を越えて継続的に蓄積することはできません。
したがって、研究者の核心的なセンスは次の三つの判断に表れます:何を問う価値があるか、どの証拠が受け入れられるか、どの案が実行可能でも取り組む価値がないか。EvoX の実践では、鍵となる問いは実行可能・評価可能・反復可能なワークフローへと導くものであるべきで、一度きりの実装結果だけを追求するものではありません。
補足:人と AI の役割分担と研究者の核心的なセンス——AI は答えの空間を拡張し、人は方向・取捨の基準・科学的意義を守る。
鍵となる問いのチェックリスト マインドマップこのマインドマップは、鍵となる問いを真の目標と複数目標のトレードオフ、譲れないハード制約、観測可能な評価指標、候補空間の境界、そして検証プロトコルと失敗判定基準に分解しています。問いの質が AI の探索と進化の落ちる領域を決めることを示しており、EvoX 最適化を例にすると、トレードオフ・定量化・受け入れ基準を明確にして初めて、成果が説明可能で再利用可能になりやすくなります。