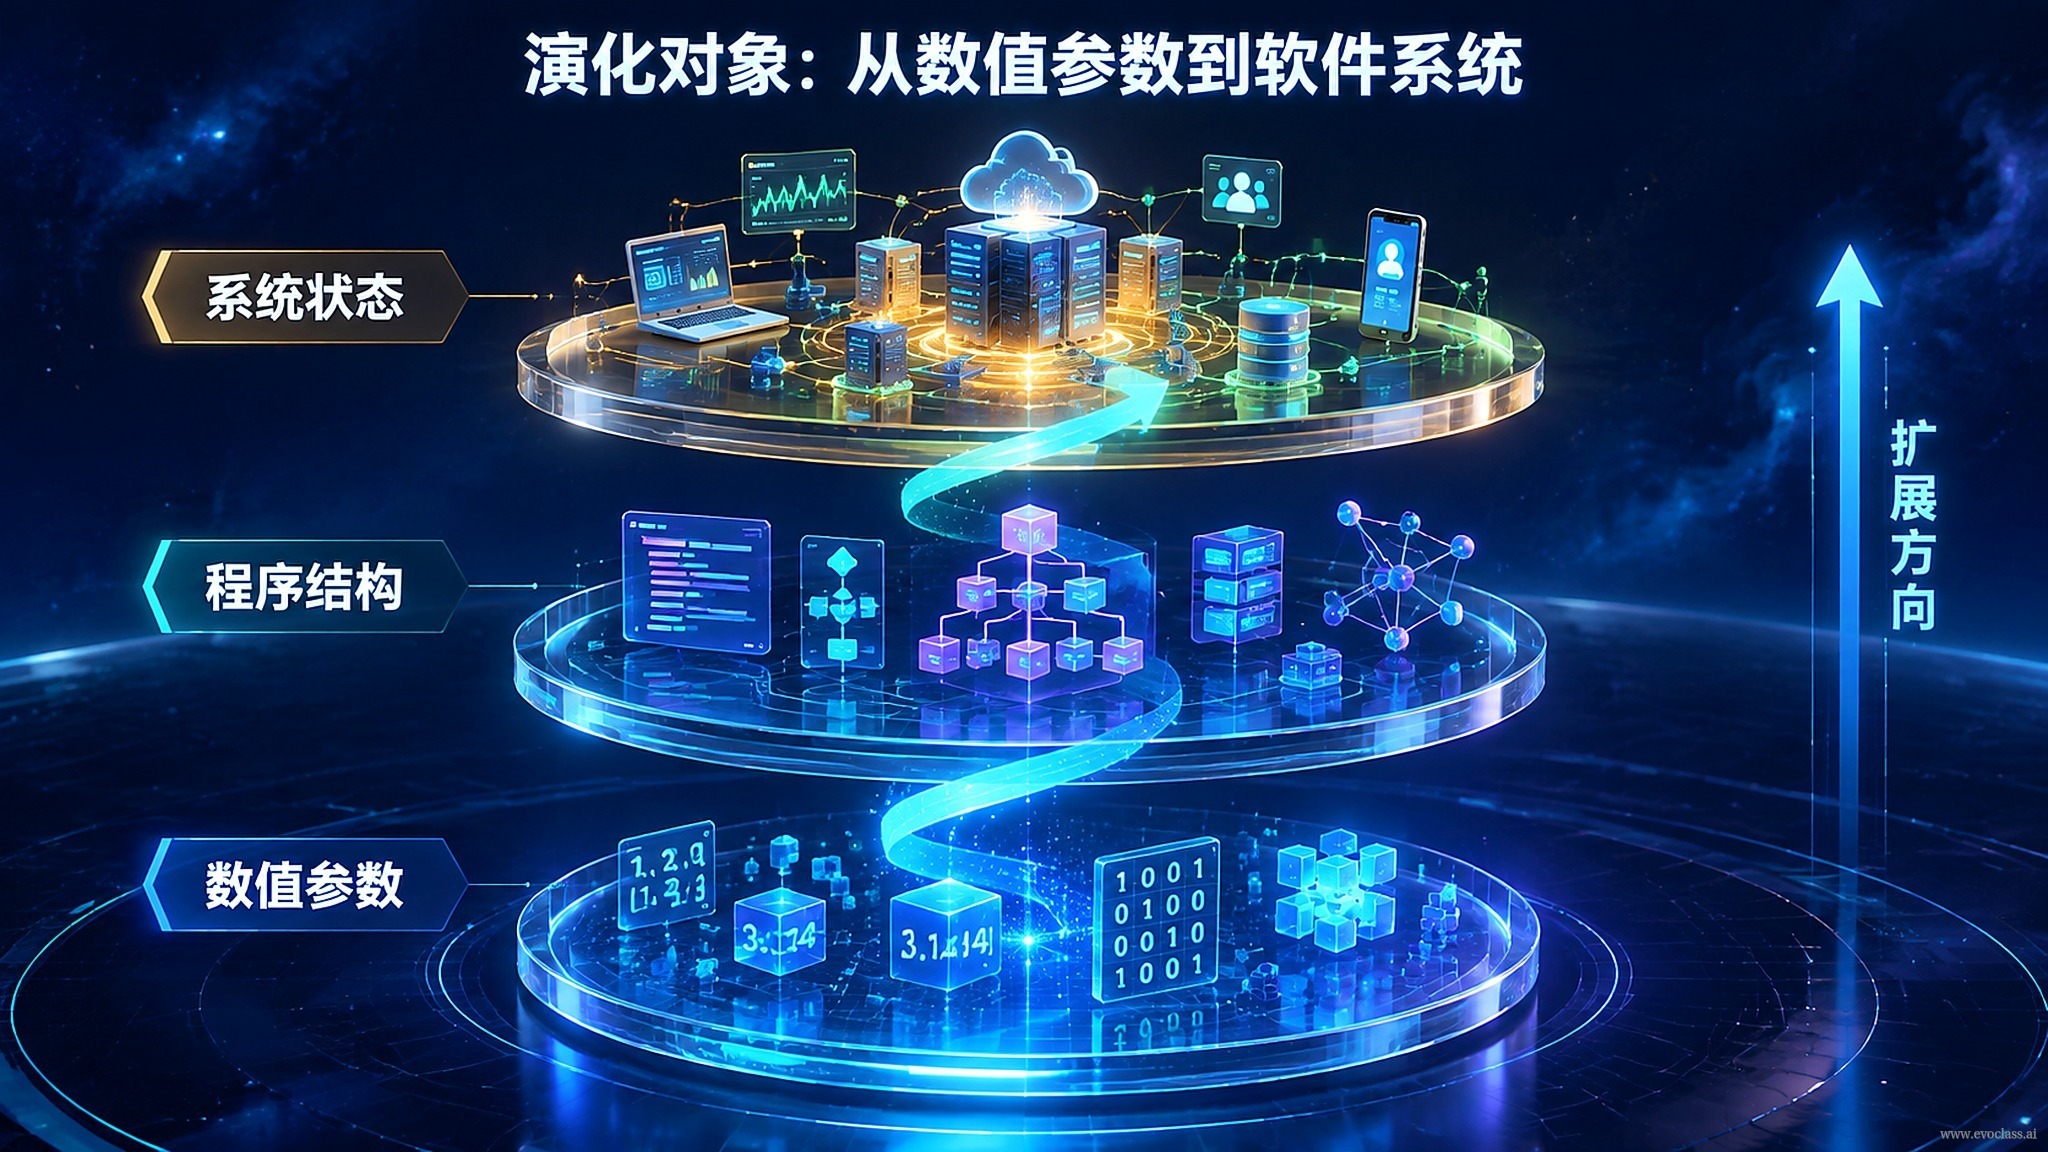
진화 연산의 초기 실무에서 '진화'의 대상은 거의 대부분수치 파라미터— 학습률, 배치 크기, 정규화 강도, 가중치 초기화 방식이었습니다. 탐색 공간은 숫자 집합이고, 평가 방식은 한 번의 학습과 한 번의 검증이었습니다. 연산 규모가 커지고 대규모 모델의 능력이 성숙해지면서 진화 가능한 대상은 뚜렷하게 확장되었습니다. 프로그램, 모델 구조, 알고리즘 메커니즘, 나아가 하나의소프트웨어 엔지니어링 상태(설정, 의존성 버전, 인터페이스 계약, 배포 및 운영 전략)까지 포함됩니다.
이 확장 경로는 명확한 화살표 체인으로 표현할 수 있습니다: 수치 파라미터 → 프로그램과 모델 구조 → 소프트웨어 엔지니어링 상태와 시스템 수준 후보. 오른쪽 계층으로 갈수록 표현력이 강해지고 포괄할 수 있는 변화 유형이 많아지며, 이로 인해 시스템 수준 진화가 가능해집니다.
세 계층의 진화 대상, 각기 다른 비용
- 수치 파라미터 계층: 후보는 숫자 집합이므로 생성이 저렴하고 평가가 빠르지만, '얼마나 잘 튜닝되었는가'만 답할 수 있을 뿐 원래 없던 메커니즘을 보완할 수는 없습니다.
- 프로그램과 모델 구조 계층: 후보는 네트워크 구조, 연산자 조합, 프롬프트 워크플로 또는 코드 패치이며, 변화는 '얼마나 정확하게 하는가'가 아니라 '시스템이 무엇을 할 수 있는가'를 바꿉니다.
- 소프트웨어 엔지니어링 상태 계층: 후보는 설정, 의존성 버전, 인터페이스 계약과 배포 전략이며, 시스템이 안정적으로 운영되고 재현될 수 있는지를 직접 결정합니다.
무게중심 이동: '후보를 어떻게 생성하는가'에서 '어떻게 실행하고 평가하는가'로
후보가 숫자에서 프로그램으로 바뀌면 '후보 생성' 단계는 오히려 더 이상 병목이 아닙니다. 대규모 모델은 구조, 메커니즘과 패치를 대량으로 만들어낼 수 있습니다. 진화의 유효성을 실제로 결정하는 것은실행 및 평가 메커니즘— 누가 후보를 실제로 실행할 수 있고, 누가 수용 가능한 비용 내에서 그것이 유지될 가치가 있는지 판단할 수 있는가입니다.
표현력이 강할수록 평가 부담도 커집니다. 수치 파라미터는 한 번의 학습만으로 점수를 매길 수 있지만, 코드 패치는 샌드박스 격리, 회귀 테스트와 기준 비교를 거쳐야 세 가지 질문에 답할 수 있습니다: 정말로 유효한가, 리스크를 초래하는가, 결과를 재현할 수 있는가. 샌드박스, 회귀 테스트와 기준은 바로 비용, 리스크와 재현성을 제약하는 엔지니어링 장치이며, 변화가 안정적으로 유지되거나 도태될 수 있게 해줍니다.
엔지니어링 트레이드오프: 후보가 많아진다고 진화가 더 좋아지는 것은 아닙니다
팀 실무에서 흔한 경로는 먼저 학습률과 하이퍼파라미터를 튜닝한 뒤, 점차 네트워크 구조, 연산자 조합, 프롬프트 워크플로 또는 코드 패치 탐색으로 확장하는 것입니다. 한 계층을 확장할 때마다 함께 답해야 합니다: 평가에 얼마나 많은 연산과 시간이 드는가? 실패한 후보가 기존 시스템을 오염시키지 않는가? 동일한 결과를 다음에도 재현할 수 있는가? 표현력, 평가 비용, 재현성과 안전성 사이에서 균형을 이룰 때에만 시스템 수준 진화가 진정으로 가능해집니다.
진화 대상의 세 계층 확장그림의 화살표 체인은 수치 파라미터에서 프로그램과 모델 구조로, 다시 소프트웨어 엔지니어링 상태와 시스템 수준 후보로 이어집니다. 오른쪽으로 갈수록 변경 가능한 대상이 많아지고 표현력이 강해집니다. 그러나 비용도 함께 상승하여, 수치 파라미터는 한 번의 학습으로 점수를 매기면 되지만 코드 패치는 샌드박스 격리, 회귀 테스트와 기준 비교를 거쳐야 유효성, 리스크와 재현성을 판단할 수 있습니다.