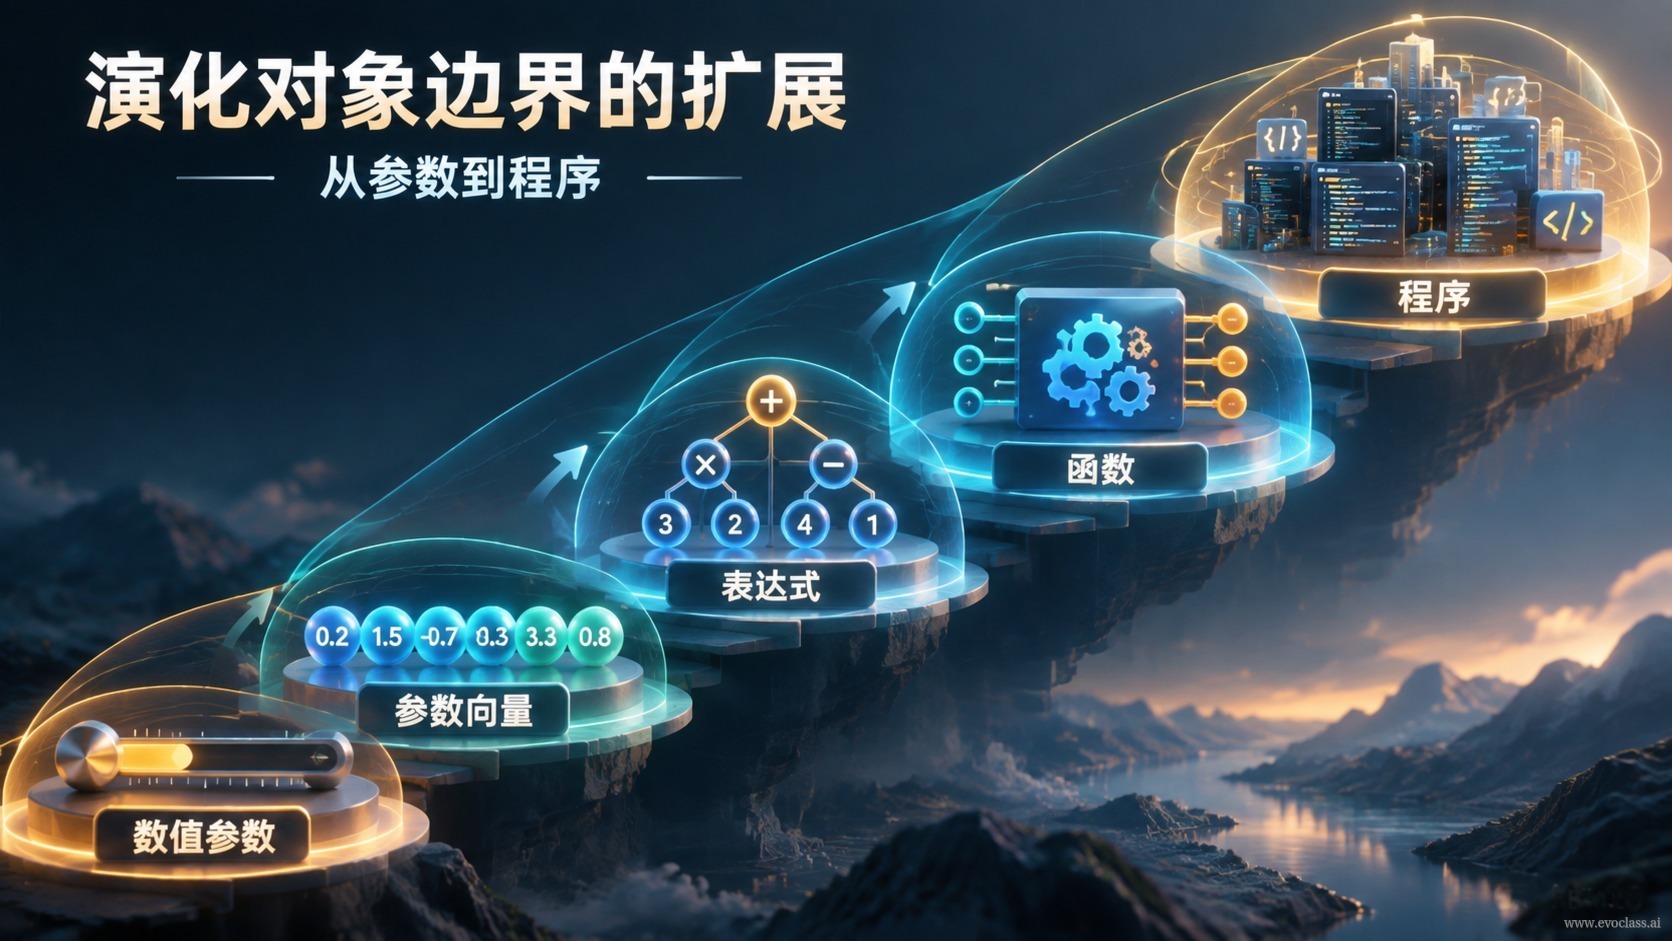
진화 대상진화 시스템에서 실제로 인코딩·변이·평가·선택되는 부분을 가리킵니다. 고전적 진화 알고리즘은 이 대상을 단순한 수치 파라미터 집합으로 가정했지만, GPU와 대규모 모델이 함께 구성하는 현대적 토대 위에서 이 경계는 바깥으로 밀려나고 있습니다. 즉 수치 파라미터에서 하이퍼파라미터와 모델 구조로, 다시 알고리즘 메커니즘과 연산자로, 최종적으로는 프로그램과 지속적으로 존재하는 소프트웨어 공학 상태로 확장됩니다.
이 사다리를 이해하는 핵심은 세 가지를 동시에 붙잡는 것입니다. 대상이어떻게 표현되는가, 어떤제약을 받는가, 어떤신호로 평가되는가입니다. 대상이 한 단계 올라갈 때마다 이 세 가지도 함께 바뀝니다.
- 수치 파라미터 계층: 대상은 연속 실수 벡터 θ \in \mathbb{R}^d이며, 예를 들어 학습률, 가중치 또는 차분 진화의 변이 인자입니다. 제약은 주로 값의 범위이고, 평가는 보통 단일 스칼라 목표 f(θ)입니다.
- 하이퍼파라미터와 모델 구조 계층: 대상에 층 수, 폭, 연결 방식, 데이터 증강 전략과 같은 이산적 선택이 포함됩니다. 탐색 공간은 혼합형이 되고 조합이 빠르게 폭발하므로, 평가는 일반화 능력과 과적합에 추가로 주목해야 합니다.
- 알고리즘 메커니즘과 연산자 계층: 대상 자체가 실행할 메커니즘입니다. 예를 들어 차분 진화의 변이 전략, 입자 군집에서 관성 계수의 조합 방식, 손실 함수의 구체적 형태 등입니다. 후보는 문법과 의미 제약을 충족해야 하며, 평가는 "누가 더 높은 점수를 받는가"에서 견고성, 안정성, 다목적 트레이드오프로 전환됩니다.
- 프로그램과 공학 상태 계층: 대상이 학습 스크립트, 파이프라인 구성, 의존성 관계, 프로젝트 상태가 됩니다. 후보는 컴파일·테스트·검수를 통과해야만 유효한 것으로 간주되며, 평가는 시스템 수준 피드백으로 격상됩니다. 즉 정확도가 얼마나 향상되었는지, 자원 오버헤드가 수용 가능한지, 결과를 재현할 수 있는지입니다.
경계가 왜 바깥으로 확장되는가
두 가지 힘이 함께 밀어냅니다. 첫째, 연산 규모가 병렬 탐색의 가능성을 열어주었습니다. 과거 단일 후보를 중심으로 작성된 직렬 루프는 텐서화와 배치 병렬로 대체되어, 전체 개체군을 한 번에 생성하고 한 번에 평가할 수 있습니다. 둘째, 대규모 모델이 자연어, 코드, 도메인 맥락을 이해할 수 있어 시스템이 구조적으로 복잡한 후보를 구성할 수 있습니다. 과거에는 반드시 사람이 설계해야 했던 인코딩과 변이 방식을 이제 모델이 함께 생성할 수 있습니다.
"후보를 생성하는 방법" 자체도 표현되고 평가될 수 있게 되면 자연스러운 질문이 떠오릅니다. 후보해를 진화시킬 수 있다면, 후보해를 생성하는 방법도 진화 대상이 될 수 있을까요? 바로 이것이 "해를 최적화하는 것"에서 "알고리즘 자체를 최적화하는 것"으로 나아가는 단계입니다.
평가 신호는 대상과 함께 격상되어야 합니다
파라미터 계층에서는 단일 스칼라 목표로도 탐색을 이끌 수 있습니다. 예를 들어 \min f(θ)입니다. 프로그램 계층에 이르면 "이 코드가 유지할 가치가 있는가"를 어떤 단일 스칼라로도 요약할 수 없습니다. 평가는 제약이 있는 다목적 트레이드오프가 되어 정확도 f1, 평가 비용 f2 과 안정성 f3을 동시에 고려하고, 제약 C(x) ≤ 0 아래에서 서로 지배하지 않는 후보 집합을 찾아야 합니다. 공학에서 흔히 쓰는 판단 체크리스트로는 컴파일 통과 여부, 테스트 커버리지 여부, 벤치마크 향상 여부, 자원 오버헤드의 수용 가능성, 결과 재현 가능성 등이 있습니다.
흔한 오해: 확장은 마구 생성하는 것과 다릅니다
대상 경계를 바깥으로 밀어낸다고 해서 코드를 마음대로 생성해도 된다는 뜻은 아닙니다. 대상이 자유로워질수록 제약이 사라지는 것이 아니라 "값의 범위"에서 "문법, 인터페이스, 실행 가능성"으로 옮겨갈 뿐입니다. 검증 책임도 줄어드는 것이 아니라 오히려 무거워집니다. 스크립트 수준 진화를 허용한 팀은 보통 두 가지 현실 문제에 먼저 부딪힙니다. 탐색 공간이 급격히 팽창하는 것, 그리고 "돌아가기는 하지만 수익이 없는" 후보가 대량으로 평가 예산을 잡아먹는 것입니다.
따라서 더 안정적인 방법은 계층적으로 개방하는 것입니다. 허용되는 변경 범위를 한 계층씩 넓히고, 먼저 저비용 필터링이나 대리 모델로 명백히 무효한 후보를 걸러낸 뒤, 고충실도 평가는 소수의 유망한 방안에만 남겨두고 정확도와 오버헤드 사이에서 명시적으로 트레이드오프합니다.
진화 대상이 수치 파라미터에서 복잡한 코드 구조로 진화하는 계층 다이어그램그림에서 진화 대상이 수치 파라미터에서 복잡한 코드 구조로 진화하는 계층 다이어그램을 살펴보고, 그것이 「진화 대상이 파라미터에서 프로그램·모델 구조·알고리즘 메커니즘·소프트웨어 공학 상태로 확장된다」는 것과 어떤 관계가 있는지 생각해 보세요.