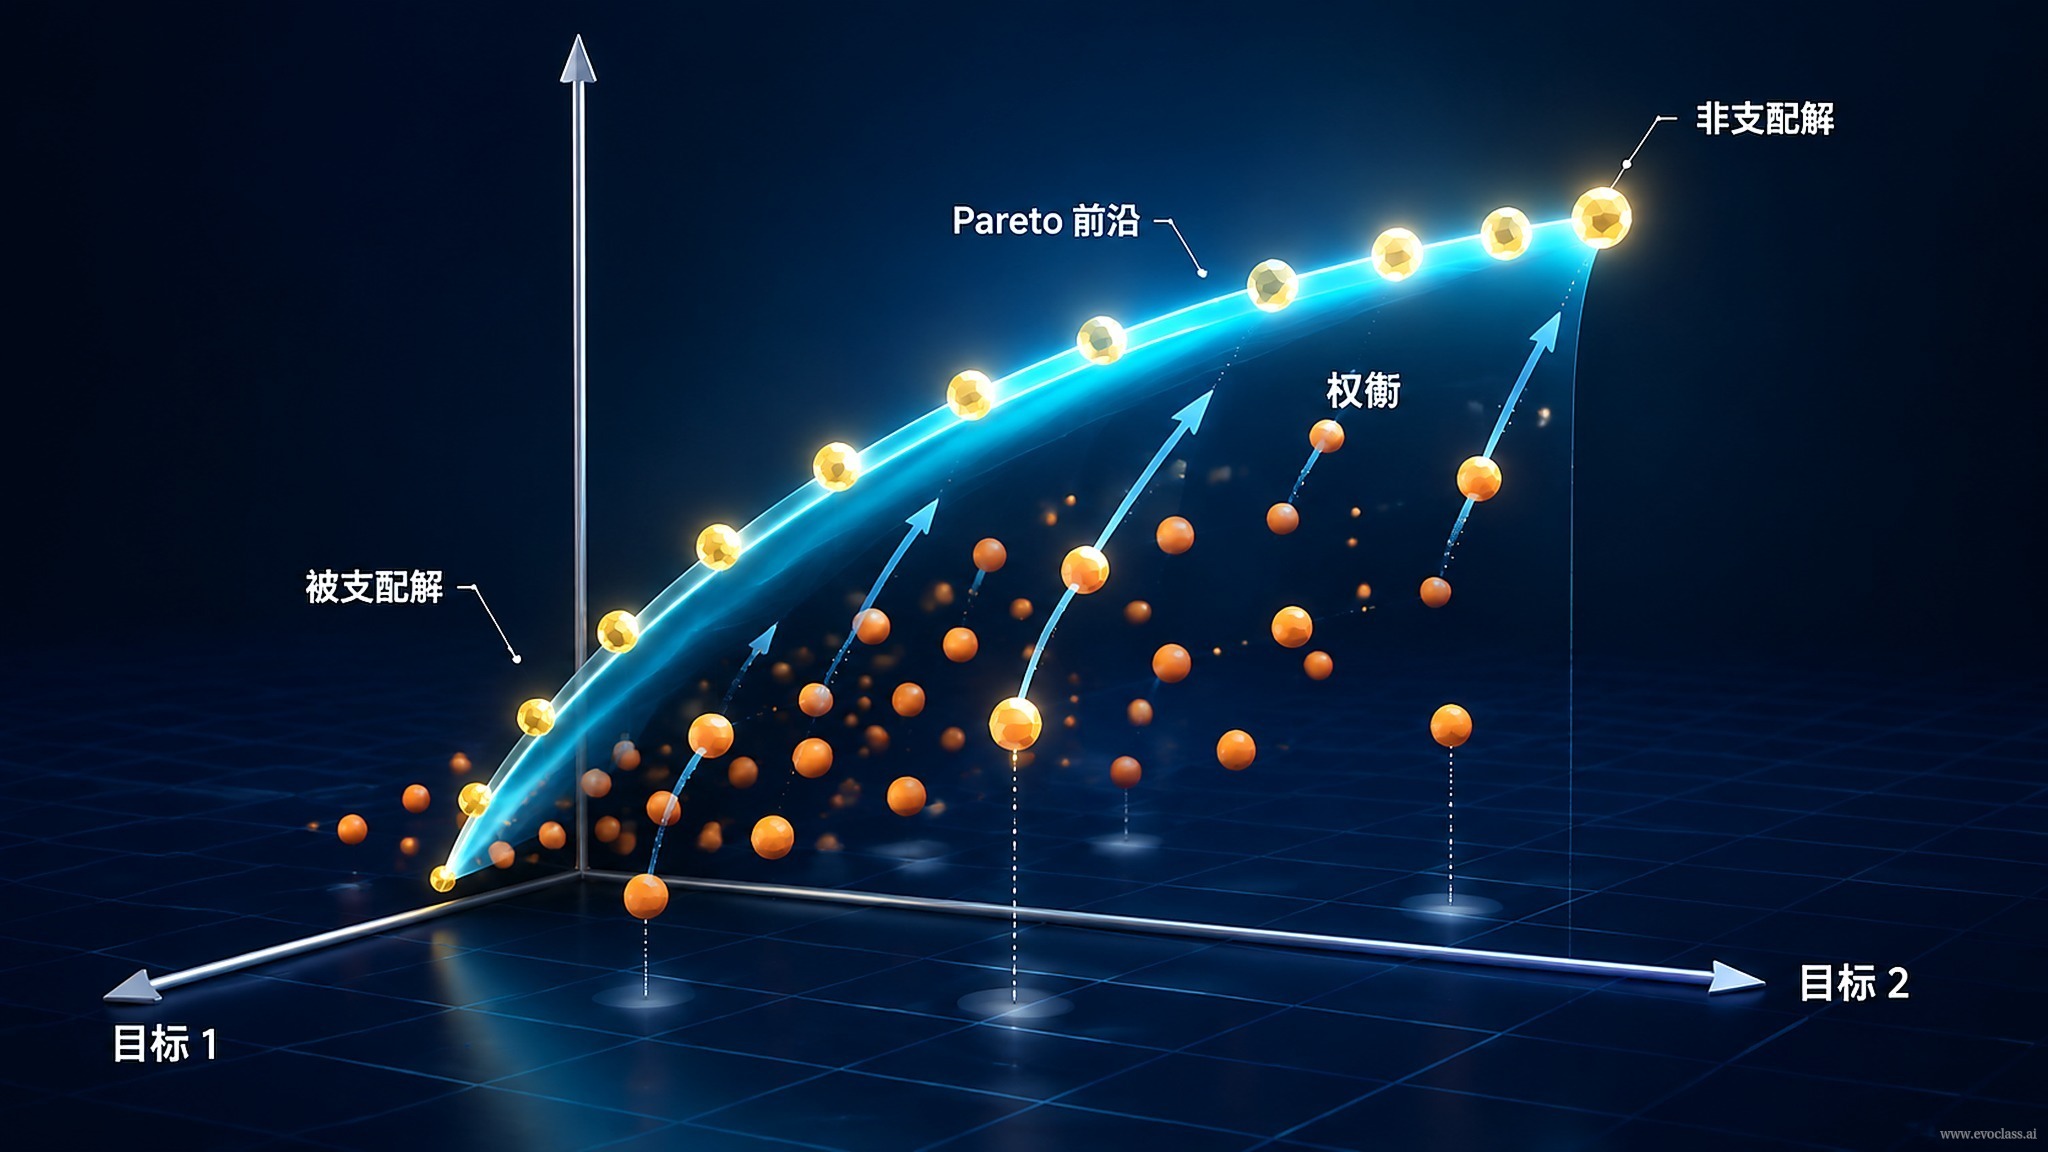
현실 물리 세계에서 공학과 과학 연구 문제에는 대개 '대가 없는 유일한 최적해'가 존재하지 않습니다:목표를 완전히 정량화하기 어렵고, 제약이 서로 중첩되며, 평가 피드백 비용이 높습니다. 또한 여러 목표가 서로 얽혀 있습니다. 항공기 설계를 예로 들면, 양력을 높이면 흔히 항력이 증가하거나 안정성이 떨어집니다. 따라서 시스템의 핵심 임무는 전문가를 대신해 직접 결정을 내리는 것이 아니라, 서로 차별화된 후보 방안들을 탐색하고 유지하여 전문가에게 이익과 대가를 비교할 수 있는 기반을 제공하는 것입니다.
세 가지 핵심 사실
- 이상적 가정은 존재하지 않음: 목표는 흔히 부분적으로만 정량화할 수 있고(예: '쾌적성', '안전 여유도'), 제약은 겹겹이 중첩되어 있으며, 고충실도 시뮬레이션, 벤치 시험, 시험 비행 등 매번의 실제 평가에는 상당한 시간과 비용이 듭니다.
- 다목표 간 상충 관계: 양력과 항력, 성능과 안정성, 정밀도와 에너지 소비는 흔히 동시에 최적에 도달할 수 없으며, 어떤 개선이든 그로 인해 치른 대가를 분명히 밝혀야 합니다.
- 비용이 큰 피드백으로 시행착오 제한: 무한히 시도할 수 없으므로 한정된 평가 예산 아래에서는 다양성을 유지하는 것이 단일점을 조기에 확정하는 것보다 더 견고합니다.
왜 단일 해로 조기에 수렴해서는 안 되는가
시스템이 탐색 초기에 고립된 '최적해'를 제시하면 의사결정 공간이 압축됩니다: 전문가는 다른 가능성을 볼 수 없고, 이 점이 어떤 두 목표 사이에서 트레이드오프를 했는지 판단할 수 없습니다. 더 적절한 방법은 비지배 관계를 따라 후보 방안군을 유지하는 것으로, 이들은 양력, 항력, 안정성 등 여러 차원에서 각기 다른 중점을 두며,权衡할 수 있는 하나의Pareto 프런트를 이룹니다. 프런트 위의 모든 점은 정당한 트레이드오프를 나타내며, 하나의 목표를 개선하려면 다른 하나를 희생해야 합니다. 따라서 프런트의 가치는 '어느 것이 가장 좋은가'가 아니라 이익과 대가의 온전한 관계를 제시하여 이후의 선호 판단과 의사결정을 뒷받침하는 데 있습니다.
흔한 오해
다목표 문제를 사전에 '가중 합산'하여 하나의 스칼라 목표로 만드는 것은 탐색 이전에 전문가 대신 선호 가중치를 정해버리는 것과 같으며, 트레이드오프 정보가 사라집니다. 가중치는 의사결정 단계의 마지막 단계여야 하며, 모델링 단계의 첫 번째 가정이어서는 안 됩니다.
Pareto 프런트 탐색그림은 다목표 문제를 하나의 Pareto 프런트로 제시합니다: 프런트 위의 각 점은 정당한 트레이드오프이며, 양력, 항력 또는 안정성 중 하나를 개선하려면 흔히 다른 하나의 후퇴를 대가로 치러야 합니다. 서로 지배하지 않는 이 후보 방안군을 유지하면 전문가에게 이익과 대가를 비교할 기반을 제공하고, 탐색 전에 가중 합으로 단일점을 조기에 확정하는 것을 피할 수 있습니다.
Pareto 프런트 탐색
그림은 다목표 문제를 하나의 Pareto 프런트로 제시합니다: 프런트 위의 각 점은 정당한 트레이드오프이며, 양력, 항력 또는 안정성 중 하나를 개선하려면 흔히 다른 하나의 후퇴를 대가로 치러야 합니다. 서로 지배하지 않는 이 후보 방안군을 유지하면 전문가에게 이익과 대가를 비교할 기반을 제공하고, 탐색 전에 가중 합으로 단일점을 조기에 확정하는 것을 피할 수 있습니다.