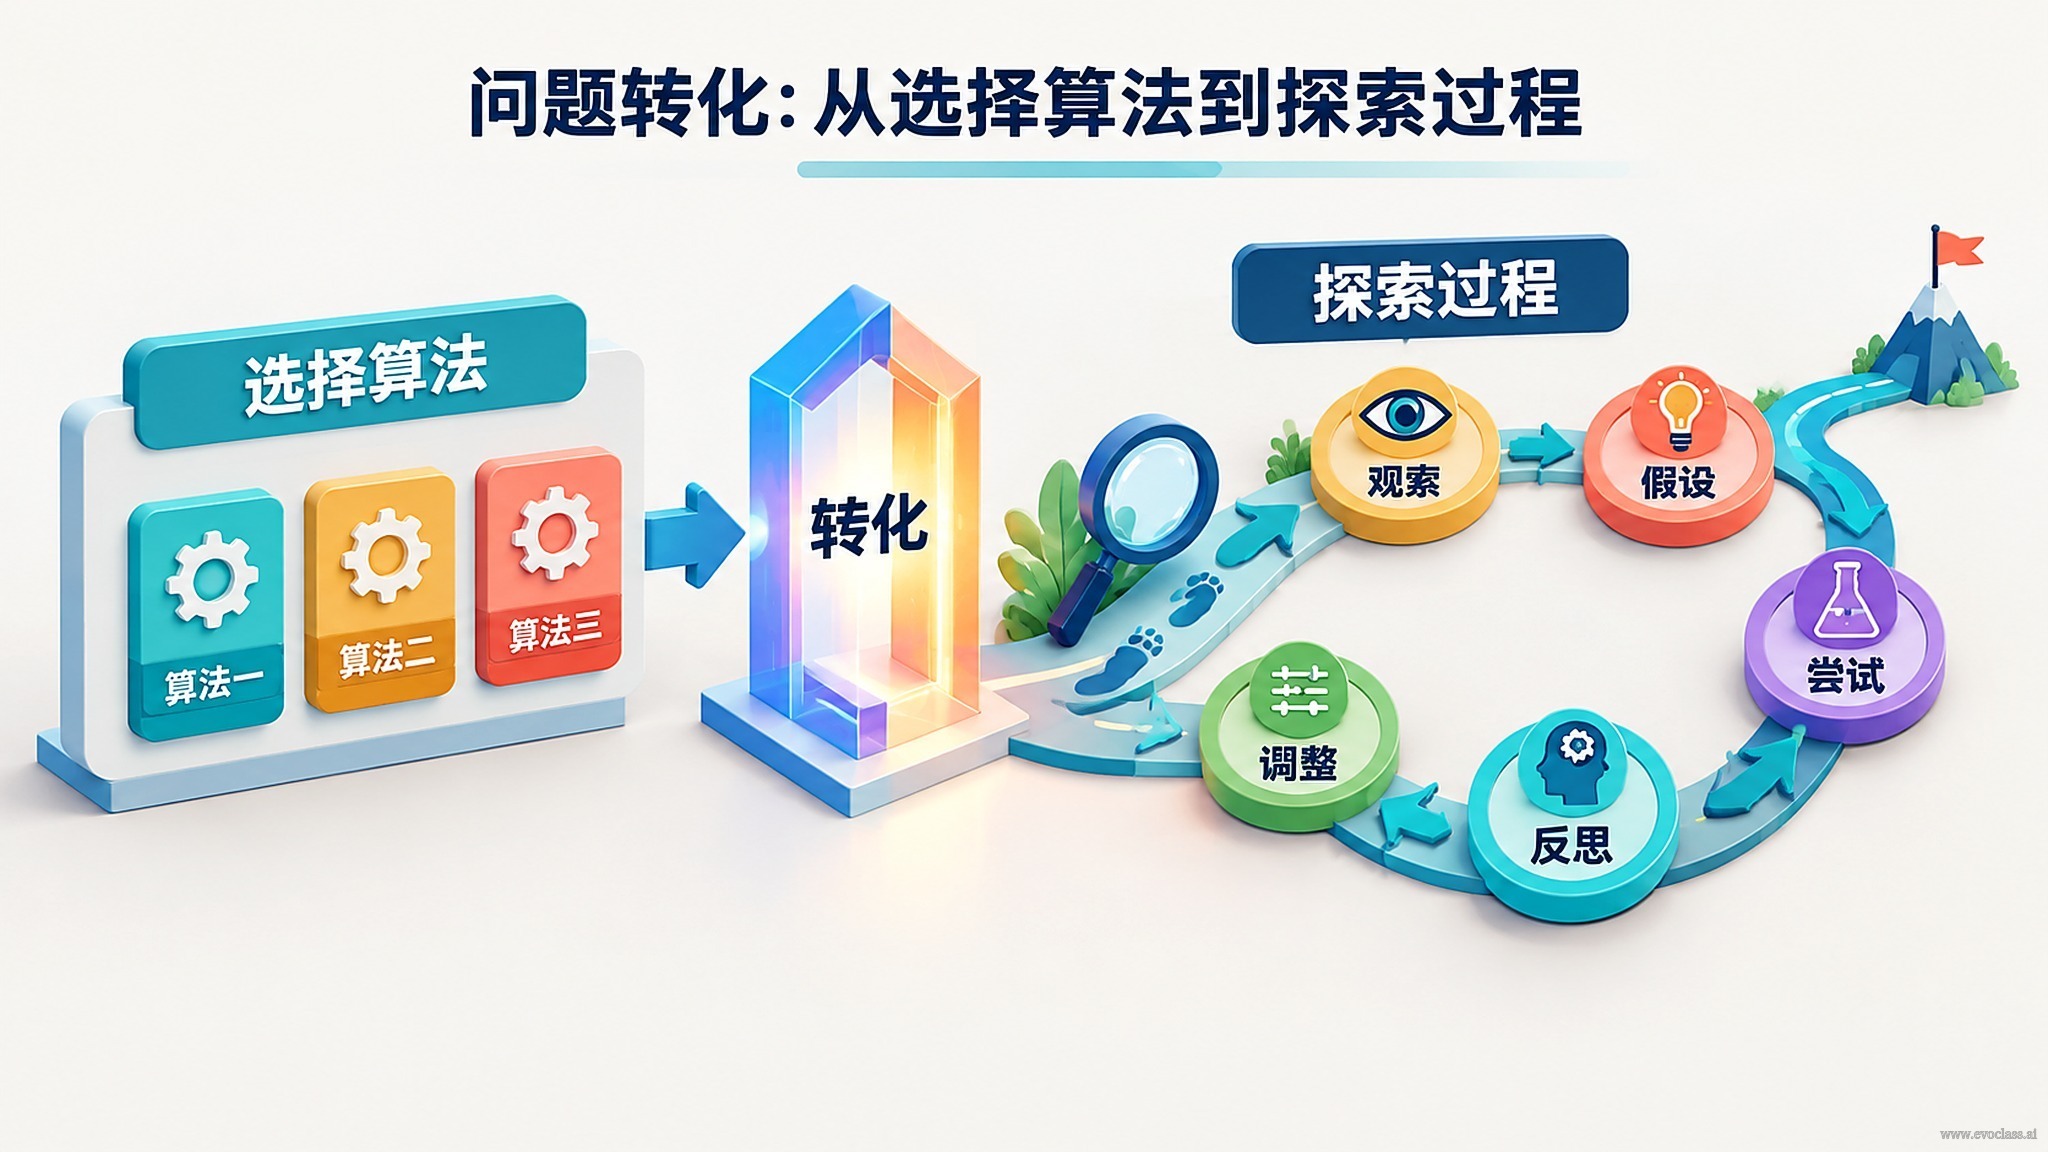
진화 연산의 실제 응용에서 흔히 범하는 출발점의 오류는, 과제를 받자마자 "DE를 써야 할까, PSO를 써야 할까"부터 묻는 것입니다. 이 질문은알고리즘 선정을 문제 풀이의 출발점에 놓지만, 이는 "어떤 도구로 탐색할 것인가"만 답할 뿐 "무엇을 탐색하고, 무엇이 좋은 것이며, 무엇은 절대 위반해서는 안 되는가"에는 답하지 않습니다. 성패를 실제로 좌우하는 것은문제 정의의 품질입니다.
이른바문제 변환이란 "어떤 알고리즘을 선택할까"를 "탐색 가능한 과정을 설계하자"로 다시 쓰는 것입니다. 먼저 실제 문제에서 무엇을 바꿀 수 있는지, 바꾼 뒤 어떻게 평가할지, 어떤 제약을 반드시 충족해야 하는지를 명확히 한 다음, 알고리즘이 이 탐색 공간에서 후보를 반복적으로 생성하고 선별하도록 하는 것입니다. 이로써 알고리즘 선택은 탐색 과정 설계의 한 요소가 되며, 그 출발점이 아닙니다.
먼저 확정해야 할 네 가지 정의
- 가변 대상: 어떤 파라미터, 구조, 전략 또는 프로세스가 조정될 수 있는지 정의하여, 이를 통해 탐색 공간과 인코딩 경계를 형성합니다. 이것이 없으면 후보 해를 표현할 수 없고 생성할 수도 없습니다.
- 평가 방법: 변경 이후 우열을 어떻게 판단할지 정의하며, 목적 함수, 평가 지표, 선호 방향, 그리고 실행 가능성과 다양성 등의 측정을 포함합니다. 평가 방식은 실질적으로 탐색이 어느 방향으로 나아갈지를 결정합니다.
- 핵심 제약: 반드시 충족해야 하는 하드 제약과 트레이드오프가 가능한 소프트 선호도를 구분합니다. 하드 제약을 목적 함수에 섞어 "할인"해 버리면, 점수는 높아 보이지만 실제로는 전혀 배포할 수 없는 방안을 만들기 쉽습니다.
- 탐색 과정: 문제를 "후보 생성—평가—피드백—재생성"의 폐루프로 형식화하여, 평가 결과가 이후 생성에 영향을 미치도록 하며, 풀이 방식을 한 번에 고정해 버리지 않습니다.
변환이 가져오는 차이
파라미터 최적화 과제를 마주했을 때 습관적인 방식은 "먼저 알고리즘을 하나 고르고 — 예컨대 DE나 PSO — 그다음 하이퍼파라미터 튜닝을 시작하는 것"입니다. 변환 이후의 방식은 세 가지 질문에 차례로 답하는 것입니다. 어떤 파라미터를 조정할 수 있는가? 어떤 지표(또는 서로 상충하는 어떤 지표들)로 평가할 것인가? 어떤 제약은 절대 위반할 수 없는가? 이 세 가지 질문에 답하고 나면, 과제는 이미 진화 솔버에 연결할 수 있는 다목적 문제로 형식화됩니다. 이 시점에서 어떤 알고리즘을, 어떤 연산자 구성으로 탐색에 사용할지 결정하는 것은 폐루프 내부의 교체 가능한 엔지니어링 결정일 뿐입니다. 다시 말해, 알고리즘은 답 그 자체가 아니라 탐색 과정에서 구성 가능한 한 요소일 뿐이며, 문제 정의의 품질이 탐색의 상한을 결정합니다.
문제 변환 흐름그림은 풀이 과제를 "DE를 먼저 고를까, PSO를 먼저 고를까"에서 탐색 가능한 흐름으로 다시 씁니다. 먼저 가변 대상, 평가 방법, 핵심 제약을 정의한 다음, 후보 생성, 평가, 피드백, 재생성이 폐루프를 이루도록 합니다. 따라서 알고리즘 선택은 폐루프 내에서 교체 가능한 한 요소일 뿐이며, 문제 정의의 품질이 탐색의 상한을 결정합니다.