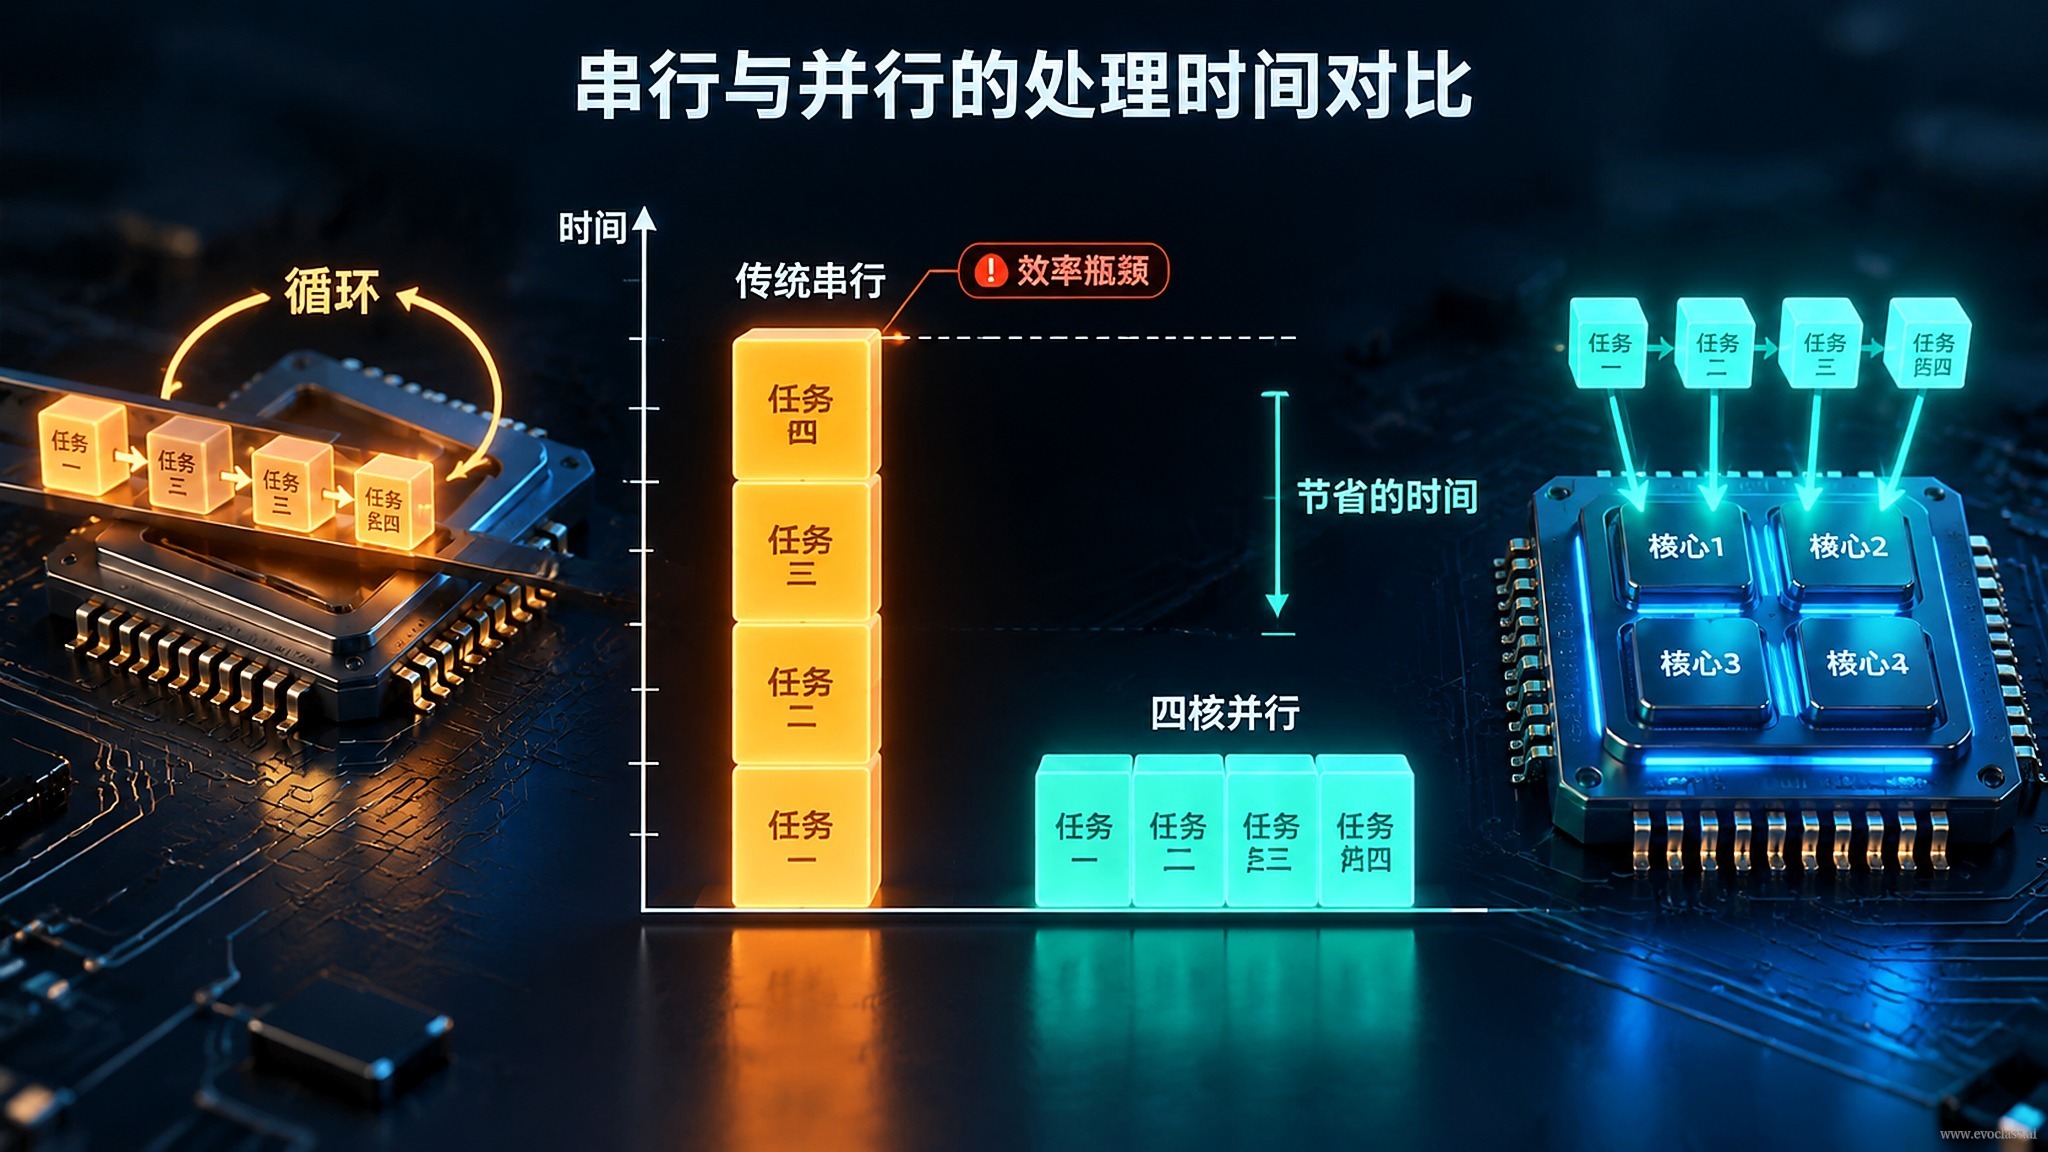
진화 과정은 개체군 다양성에 의존하며, 다양성은 개체군 규모와 평가 횟수의 배수적 증가를 의미합니다. 후보 평가가 수만 회 규모에 이르면,전통적 직렬 CPU 루프는 전체 파이프라인에서 가장 좁은 구간이 됩니다. 한 번에 하나의 개체만 처리하므로 하드웨어의 병렬 능력이 거의 유휴 상태로 남습니다.
한 번에 하나씩: 직렬 루프의 실행 모델
가장 단순한 구현은 전체 개체군을 하나의 리스트로 취급하고 루프로 개체를 하나씩 꺼내는 것입니다. 개체 가져오기 → 구체적 파라미터로 디코딩 → 평가 함수 호출 → 적합도 되쓰기. 인접 반복 간에는 거의 겹칠 수 없습니다. 평가 결과가 돌아오지 않으면 되쓰기가 진행될 수 없고, 되쓰기가 끝나지 않으면 다음 개체가 결과를 놓을 자리가 없습니다. 그래서 멀티코어, SIMD, GPU 같은 병렬 유닛은 대부분의 시간을 유휴 상태로 보내며, 하나의 개체가 파이프라인을 다 돌아가는 것을 지켜볼 수밖에 없습니다.
오버헤드는 어디에서 오는가
- 선형으로 팽창하는 평가 횟수: 총 평가 횟수는 대략 개체군 규모 × 반복 세대이며, 10⁵ 규모에 이르면 직렬 실제 소요 시간이 거의 선형으로 증가합니다.
- 인터프리터 계층의 개별 실행: 개체별 루프, 경계 검사, 타입 분기는 고정적이지만 높은 상수 오버헤드를 초래합니다.
- 비연속 메모리 접근과 데이터 이동: 개별적으로 가져오는 개체는 메모리에서 대개 연속적이지 않아 캐시 적중률이 낮고, 이동 비용이 반복적으로 발생합니다.
- 동기화와 스케줄링: 다음 개체를 가져오기 위해 실행 흐름이 반복적으로 멈췄다가 재개되어야 합니다.
규모를 시간으로 환산하기
개체군 1000, 반복 100세대를 예로 들면 총 약 10만 회의 후보 평가가 이루어집니다. 단일 평가가 평균 1 ms라면 평가 단계만 직렬로 약 100초가 걸리며, 여기에 연산자 계산과 스케줄링 오버헤드는 아직 포함되지 않았습니다. 다양성 유지를 위해 재시작 횟수를 1회에서 5회로 늘리면 비용은 거의 선형으로 약 500초까지 상승합니다. 동일한 작업량을 배치 단위로 구성해 병렬 하드웨어에 맡기면 실제 소요 시간은 개체 수가 아닌 배치 수에 의해 주로 결정됩니다.
이 병목은 언제 완화되는가
경계 조건도 마찬가지로 중요합니다. 단일 평가가 매우 저렴하거나(마이크로초 수준) 개체군이 매우 작으면(100 미만) 스케줄링과 메모리 오버헤드가 계산 오버헤드를 역전할 수 있고, 직렬과 병렬의 차이가 뚜렷하게 줄어들며, 텐서화의 한계 수익이 체감하고, 병목이 스케줄링 입자성과 메모리 대역폭으로 옮겨갑니다. 따라서 실행 모델을 개조할 가치가 있는지는 평가 비용과 규모를 함께 고려해 평가해야 합니다.
직렬과 병렬의 소요 시간 비교개체군 1000, 반복 100세대를 예로 들면 총 약 10만 회의 후보 평가가 이루어집니다. 단일 평가가 1밀리초일 때 직렬은 평가 단계만 약 100초가 걸리고, 재시작 5회 시 거의 선형으로 약 500초까지 증가합니다. 배치 단위로 구성해 병렬 하드웨어에 맡기면 실제 소요 시간은 개체 수가 아닌 배치 수에 의해 주로 결정됩니다.