진화 알고리즘의 엔지니어링 구현에서,텐서화 조직把“种群是什么、评价得怎样、运行到哪一步”从零散对象与列表统一映射为规则张量。其本质是建立种群、评价与状态的统一数据契约,使批量计算、设备驻留与后续并行调度具备共同内存语义。
개체군 텐서화: [N, D]로 인코딩
将 N 个候选解按批维组织为形状 [N, D] 的编码张量。连续变量、离散变量或多段编码可用字段张量或分组块表达,并保持统一数据类型与设备位置。
- 배치 차원 최외곽: 일반적으로 N을 최외곽에 배치하여 동일한 연산자가 전체 배치에 대해 벡터화 실행되도록 합니다.
- 필드 분할: 개체가 다중 파라미터 세그먼트로 구성된 경우 [N, D1] + [N, D2] + … 으로 분할하고 연속 저장을 유지합니다.
- 가변 길이 처리: 가변 길이 개체는 패딩과 마스크 또는 버킷팅으로 처리하여 이종 구조가 배치 계산을 방해하지 않도록 합니다.
评价结果矩阵化:[N, M] 与 [N, K]
一次批量评价产生 [N, M] 适应度矩阵;多目标、多约束与附加指标可并列为 [N, M+K] 或分表存储,避免逐个体循环调用评价函数。
状态张量统一管理
세대, 난수 상태, 전략 하이퍼파라미터, 최적해, 이력 캐시, 순위 또는 샘플링 상태 등도 텐서나 구조화된 상태 컨테이너에 포함되어 재현 가능성, 추적 가능성, 배치 업데이트 가능성을 보장합니다.
예시: N=1024, D=50, M=2
개체군은 [1024, 50] 텐서, 평가값은 [1024, 2] 텐서, 제약은 [1024, K]로 표현됩니다. 세대 generation, 최적해 best_x, 난수 상태 rng_state는 상태 텐서로서 디바이스에 통일 상주합니다. 각 세대 업데이트는 개체별 Python 루프가 아닌 동일 배치 차원에서 전체적으로 수행될 수 있습니다.
조직의 이점과 한계
통일된 텐서는 호스트와 디바이스 간 왕복을 줄이고 루프 오버헤드를 낮추며 이후 연산자 병렬화를 위한 데이터 기반을 제공하지만, 마스크 유효성, 패딩 낭비, 다중 목표 규모 증가, 상태 동기화 비용을 처리해야 합니다.
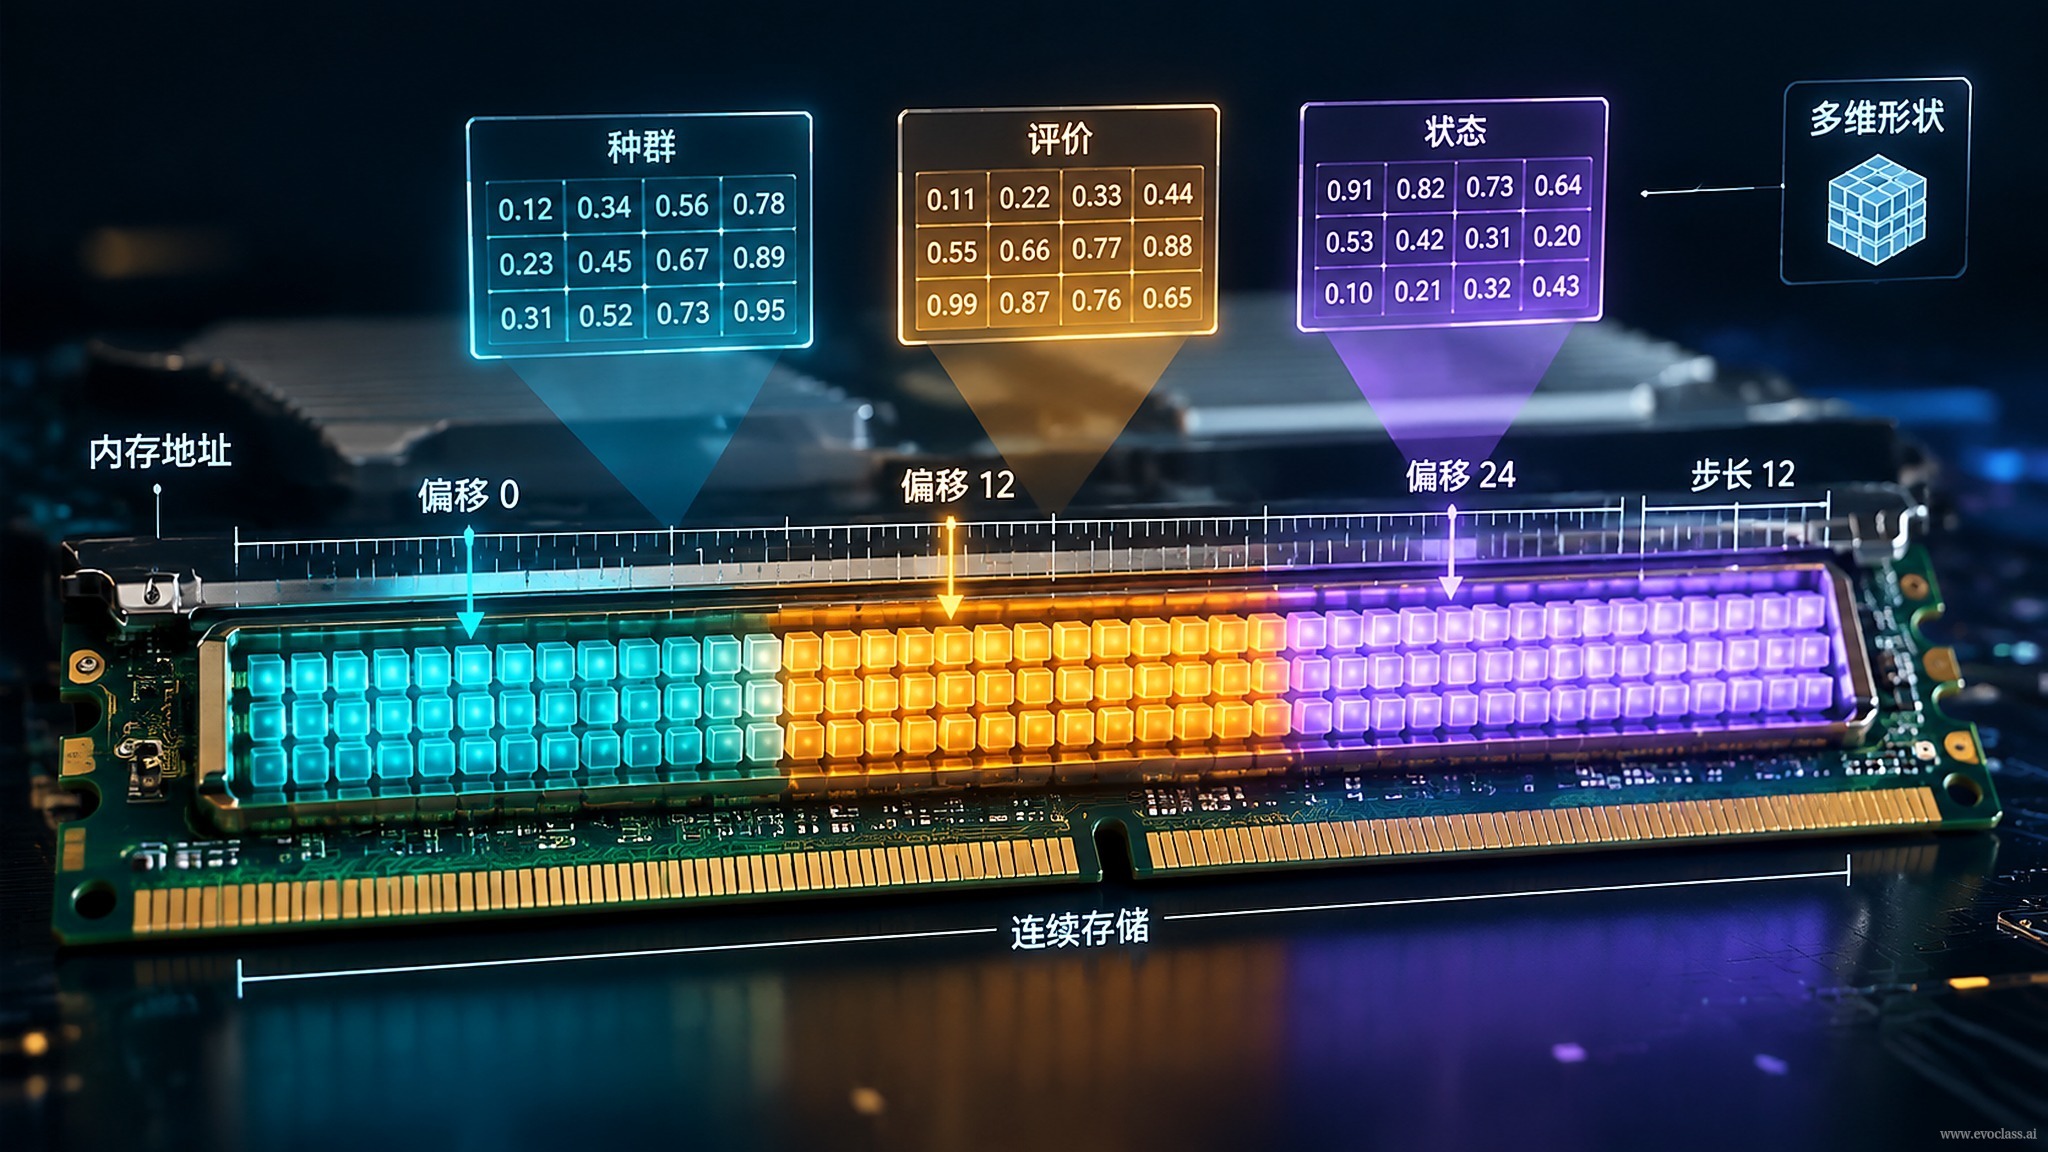
개체군, 평가, 상태의 텐서 레이아웃개체군은 [N, D] 텐서로 인코딩되고, 한 번의 배치 평가로 [N, M] 적합도 행렬을 얻으며, 다중 목표나 제약은 [N, M+K]로 확장할 수 있습니다. 세대, 최적해, 난수 상태 등도 텐서로서 디바이스에 통일 상주하여 각 세대 업데이트가 동일 배치 차원에서 전체적으로 완료되므로 호스트와 디바이스 간 왕복과 개체별 루프 오버헤드를 줄입니다.
개체군, 평가, 상태의 텐서 레이아웃
개체군은 [N, D] 텐서로 인코딩되고, 한 번의 배치 평가로 [N, M] 적합도 행렬을 얻으며, 다중 목표나 제약은 [N, M+K]로 확장할 수 있습니다. 세대, 최적해, 난수 상태 등도 텐서로서 디바이스에 통일 상주하여 각 세대 업데이트가 동일 배치 차원에서 전체적으로 완료되므로 호스트와 디바이스 간 왕복과 개체별 루프 오버헤드를 줄입니다.