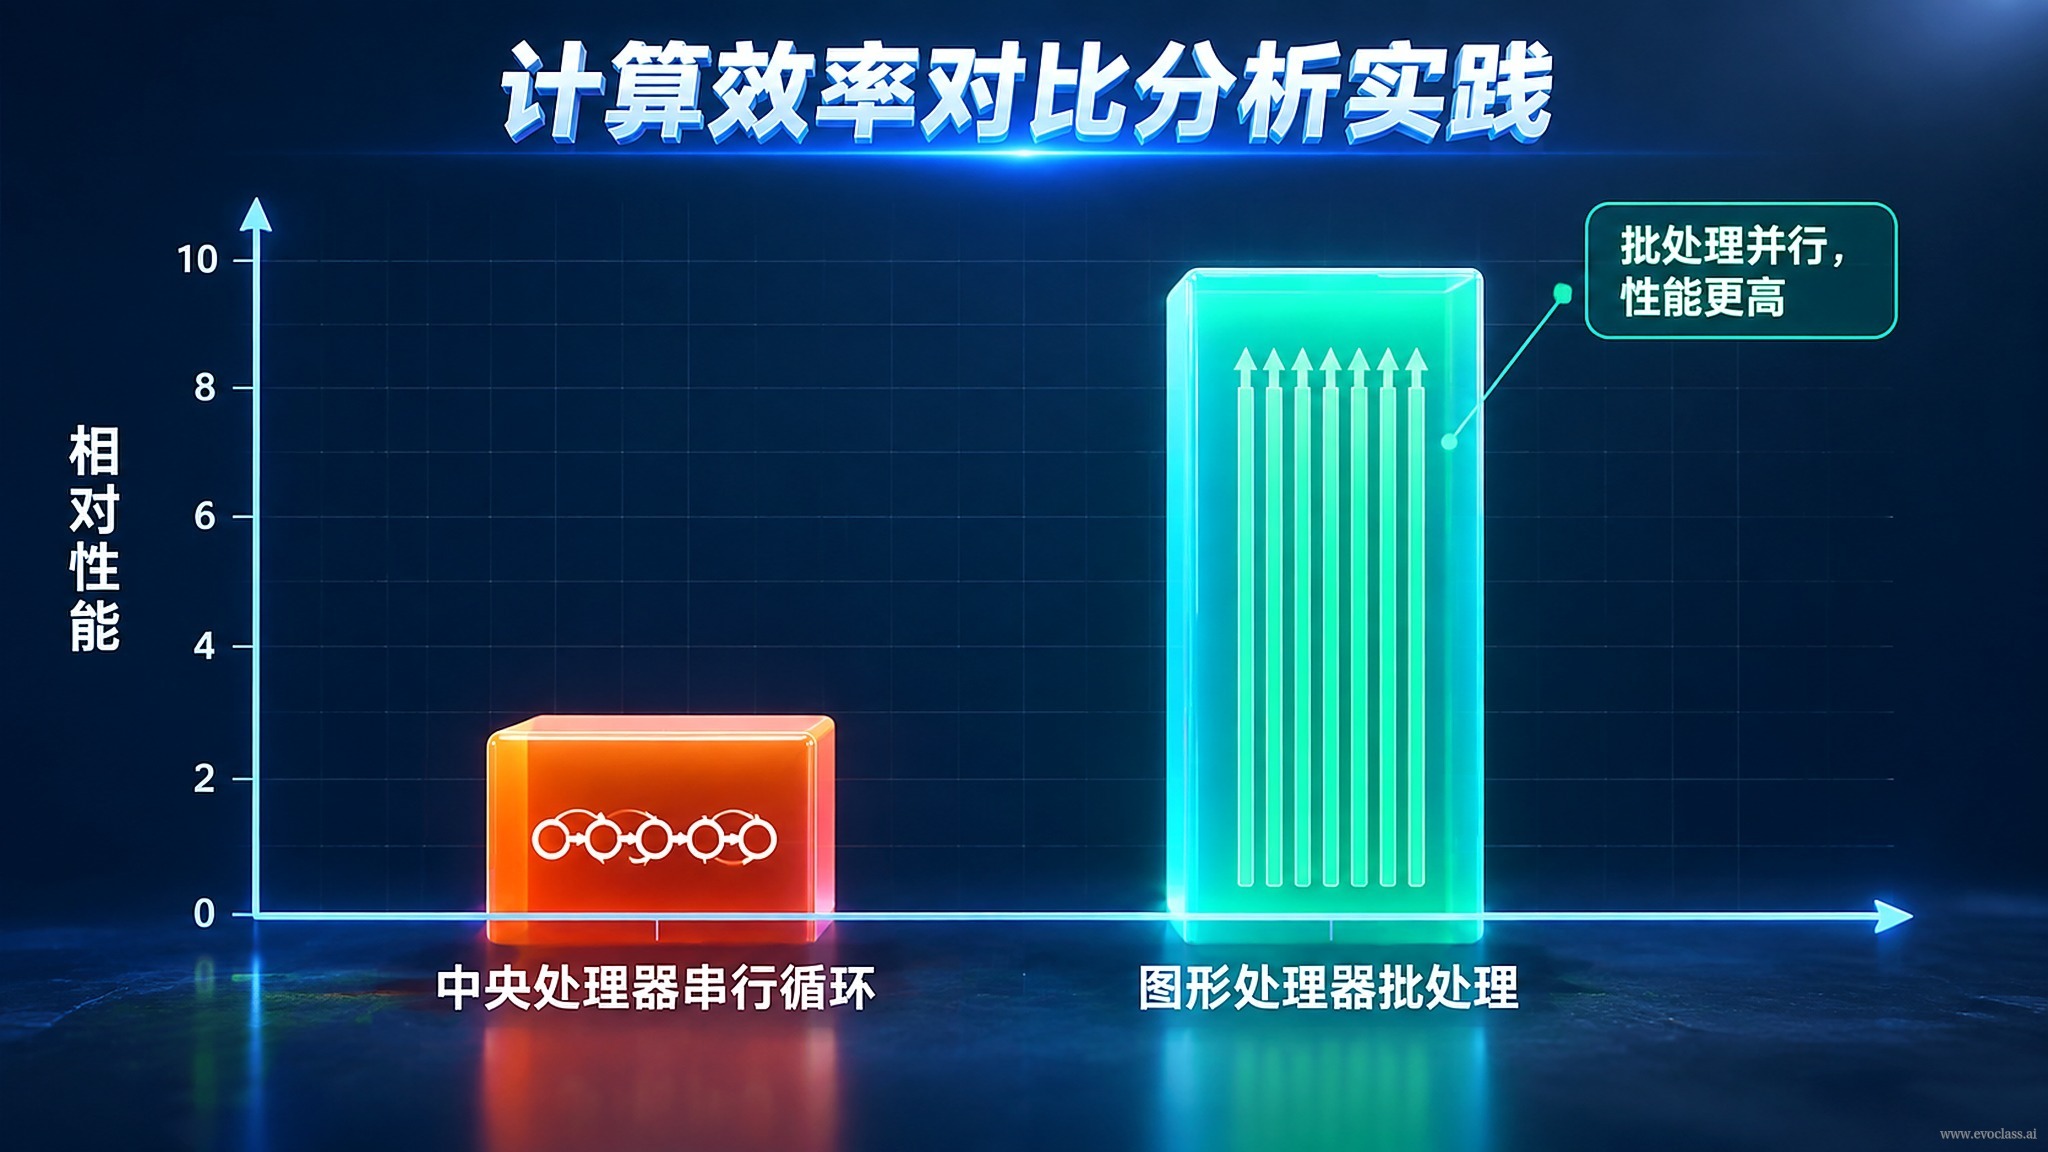
이 페이지에서는 '계산 효율 비교'를 재현 가능한 실습으로 다룹니다:동일한 진화 과제에서 전통적인 CPU 순차 개체 순회와 EvoX GPU 텐서 배치 처리의 엔드투엔드 효율을 비교합니다. 목표는 'GPU가 더 빠르다'는 결론을 외우는 것이 아니라, 텐서화 병렬화가 가져오는 가속이 어디서 비롯되고 그 대가는 무엇이며 경계는 어디인지 이해하는 것입니다.
두 가지 기준선, 동일한 과제
- CPU 순차 기준선: 반복문으로 개체를 하나씩 평가 함수에 전달하며, 세대마다 N번의 독립적 스케줄링, 상태 갱신, 결과 집계가 필요합니다. 반복문 제어, 인터프리터 오버헤드, 분산된 메모리 접근은 유효 연산 능력을 희석시키며, 개체가 많을수록 이러한 '비계산' 비용의 비중이 높아집니다.
- GPU 텐서 비교 구현: EvoX는 개체군, 평가 입력, 실행 상태를 텐서로 구성하여 GPU에서 평가와 연산자를 배치 실행하며, 한 번의 호출로 전체 후보 집합을 처리함으로써 순차 반복과 스케줄링 횟수를 크게 줄입니다.
측정 프로토콜: 비교를 재현 가능하게
재현 가능한 비교를 위해서는 반드시문제, 개체군 규모, 반복 세대 수, 난수 시드를 고정하고, 그런 다음 세대당 wall-clock, 총 소요 시간, 처리량(평가/초), 가속비, GPU 사용률과 VRAM 점유량을 기록합니다. 계측 전에는워밍업으로 최초 컴파일과 메모리 할당의 영향을 배제하고, 계측 시점에서디바이스 동기화를 수행하며, 계산 소요 시간과 호스트-디바이스 데이터 전송 소요 시간을 분리하여 집계합니다. 어느 한 단계라도 빠지면 측정된 가속비가 왜곡될 수 있습니다.
차이는 어디서 비롯되며 무엇에 제약받는가
- 이점의 원천: 배치 병렬화, 텐서화 연산자, 디바이스 내 병렬화로 한 번의 호출이 전체 후보 집합을 처리하여 단위 시간에 더 많은 평가를 완료합니다.
- 제약 조건: 배치 크기, 문제 차원, 평가 함수의 벡터화 가능 정도, 호스트-디바이스 복사 오버헤드, 커널 실행 오버헤드가 모두 최종 가속에 영향을 미칩니다. 배치가 너무 작으면 실행 오버헤드가 이점을 잠식하며, 평가 함수를 벡터화할 수 없다면 배치 처리는 거의 발휘될 수 없습니다.
실습 결론
올바른 순서는 다음과 같습니다:평가 함수를 배치화할 수 있는지 먼저 검증한 후 CPU와 GPU 구현을 비교합니다. 효율 우위는 궁극적으로 '동일한 계산 예산으로 더 많은 세대 또는 더 많은 후보안을 확보하는 것'에 귀결되어야 하며, 이를 근거로 배포 방식과 실험 설계를 결정해야 합니다. 단순히 보기 좋은 가속비 숫자를 좇는 것이 아닙니다.
CPU 순차와 GPU 배치 처리의 효율 비교비교에서 CPU 순차 기준선은 개체를 하나씩 반복 평가하며, 세대마다 N번의 스케줄링과 상태 갱신이 필요하고 인터프리터와 메모리 접근 오버헤드가 유효 연산 능력을 희석시킵니다. GPU 배치 처리는 개체군과 평가 입력을 텐서로 구성하여 한 번의 호출로 전체 후보 집합을 처리합니다. 가속비는 배치 크기, 평가 함수의 벡터화 가능 정도, 호스트-디바이스 복사 오버헤드에 의해 제약받습니다.
CPU 순차와 GPU 배치 처리의 효율 비교
비교에서 CPU 순차 기준선은 개체를 하나씩 반복 평가하며, 세대마다 N번의 스케줄링과 상태 갱신이 필요하고 인터프리터와 메모리 접근 오버헤드가 유효 연산 능력을 희석시킵니다. GPU 배치 처리는 개체군과 평가 입력을 텐서로 구성하여 한 번의 호출로 전체 후보 집합을 처리합니다. 가속비는 배치 크기, 평가 함수의 벡터화 가능 정도, 호스트-디바이스 복사 오버헤드에 의해 제약받습니다.