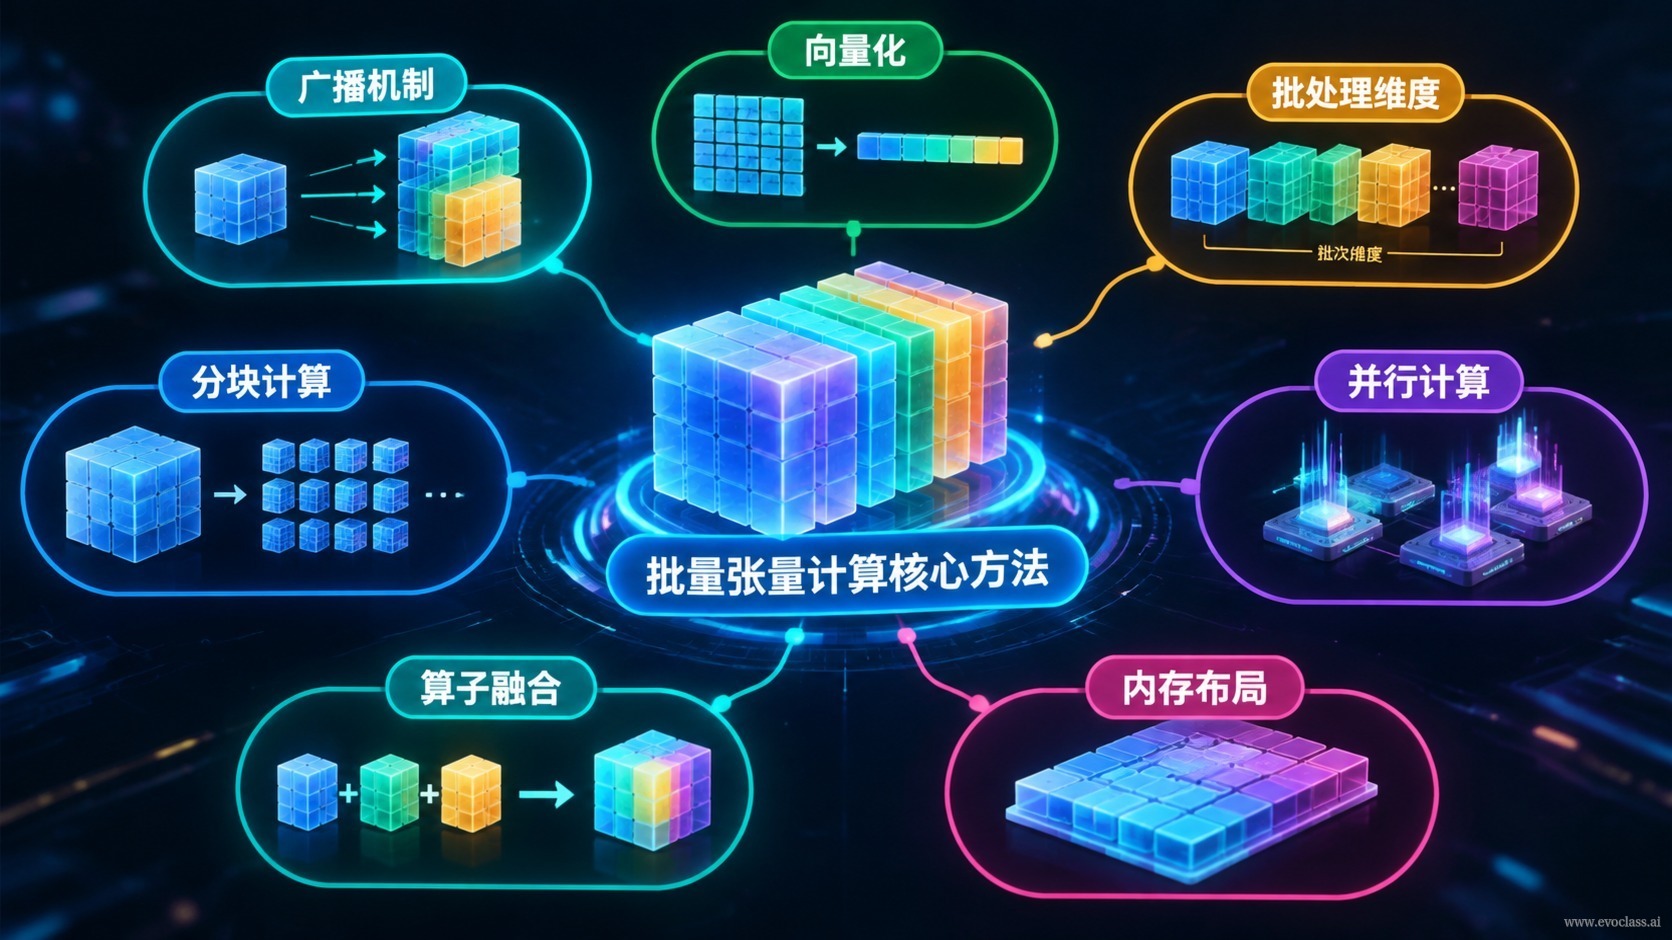
EvoX의 텐서화 기반에서배치 텐서 연산은알고리즘 표현 계층에 위치합니다. 진화 루프의 후보, 평가, 상태를 일괄적으로배치 차원을 가진 텐서로 매핑한 뒤, GPU 친화적인 배치 연산자와 컴파일된 계산 그래프에 전달하여 실행합니다. 목표는 매우 명확합니다. '개별 개체 순차 진화'를 '전체种群 병렬 진화'로 바꿔, 연산 능력이 스케줄링과 커널 실행에 소모되지 않고 탐색 자체에 실제로 작용하도록 하는 것입니다.
一、진화 과정을 텐서로 표현하기
배치 차원 N이 후보(개체) 수를 나타낸다고 약속하면, 진화의 세 가지 핵심 요소를 곧바로 텐서로 표현할 수 있습니다:
- 후보 텐서: 种群 X는 [N × D]로 구성되며, D는 단일 후보의 결정 변수 개수입니다.
- 목표 텐서: 목표 및 제약 F는 [N × M]으로 구성되며, M은 목표/제약 항목 수입니다. 다목표 상황에서 각 목표는 F의 서로 다른 열입니다.
- 상태량: 세대 수, 현재 최적값, 스텝 크기 등은 Python 객체로 개별 개체마다 기록하는 대신 스칼라 또는 소형 텐서 버퍼로 유지합니다.
이렇게 하면 교차, 변이, 선택, 평가가 모두 N 차원 방향으로 배치 처리되어, 진화 루프에서 개별 개체 단위의 분기와 제어 흐름이 사라집니다.
二、배치 연산자: N번의 단일 후보 호출에서 한 번의 배치 연산으로
세 가지 최소한의 대조 가능한 표현식이 배치 연산자의 기본 형태를 보여줍니다:
- 변이: X′ = X + σ·randn(X). 전체 후보가 한 번의 배치 연산에서 각각 무작위 섭동을 받으며, σ가 섭동 강도를 제어합니다.
- 선택: idx = topk(F, k). N개 후보의 적합도에서 한 번에 상위 k개 후보의 인덱스를 선택합니다.
- 평가: Y = fθ(X). 한 번의 배치 순전파 또는 배치 시뮬레이션으로 N번의 단일 후보 호출을 대체합니다.
핵심은 특정 연산자가 아니라 모든 후보가 동일한 텐서 연산 그래프를 공유하는 데 있습니다. 한 번의 배치 호출로 인터프리터 오버헤드와 커널 실행 오버헤드를 줄여, GPU/멀티코어 연산 능력이 진화 탐색에 실제로 작용하도록 합니다. 제약과 범위 초과 처리는 동일 배치 연산 내에서 마스크 텐서로 처리할 수 있으며, 개별 후보를 위해 별도로 분기할 필요가 없습니다.
三、계산 그래프 최적화와 처리량 지표
여러 세대의 진화를 컴파일 가능한 데이터 흐름 그래프로 작성하면 성능을 더 짜낼 수 있습니다:연산자 융합커널 실행 횟수를 줄이고,배치 내 병렬화전체 후보를 동시 실행하며,비동기 실행연산과 데이터 전송을 서로 중첩시키고,메모리 재사용중간 텐서 할당을 줄입니다. 이에 따라 성능 지표도 '단일 단계 지연'에서후보/초 또는 세대/초의 처리량으로 전환해야 합니다. 배치 실행에서는 한 번의 호출이 전체 후보를 처리하므로, 전체 처리량만이 탐색 효율을 실제로 반영합니다.
배치 텐서 연산 핵심 방법 마인드맵마인드맵은 진화 과정을 배치 차원을 가진 텐서로 표현합니다. 种群 X는 N×D, 목표 및 제약 F는 N×M이며, 교차, 변이, 선택, 평가가 모두 N 차원 방향으로 배치 처리됩니다. 변이, topk 선택, 배치 순전파 평가는 한 번의 배치 호출만 필요하며, 성능 지표도 단일 단계 지연에서 후보/초의 처리량으로 전환됩니다.