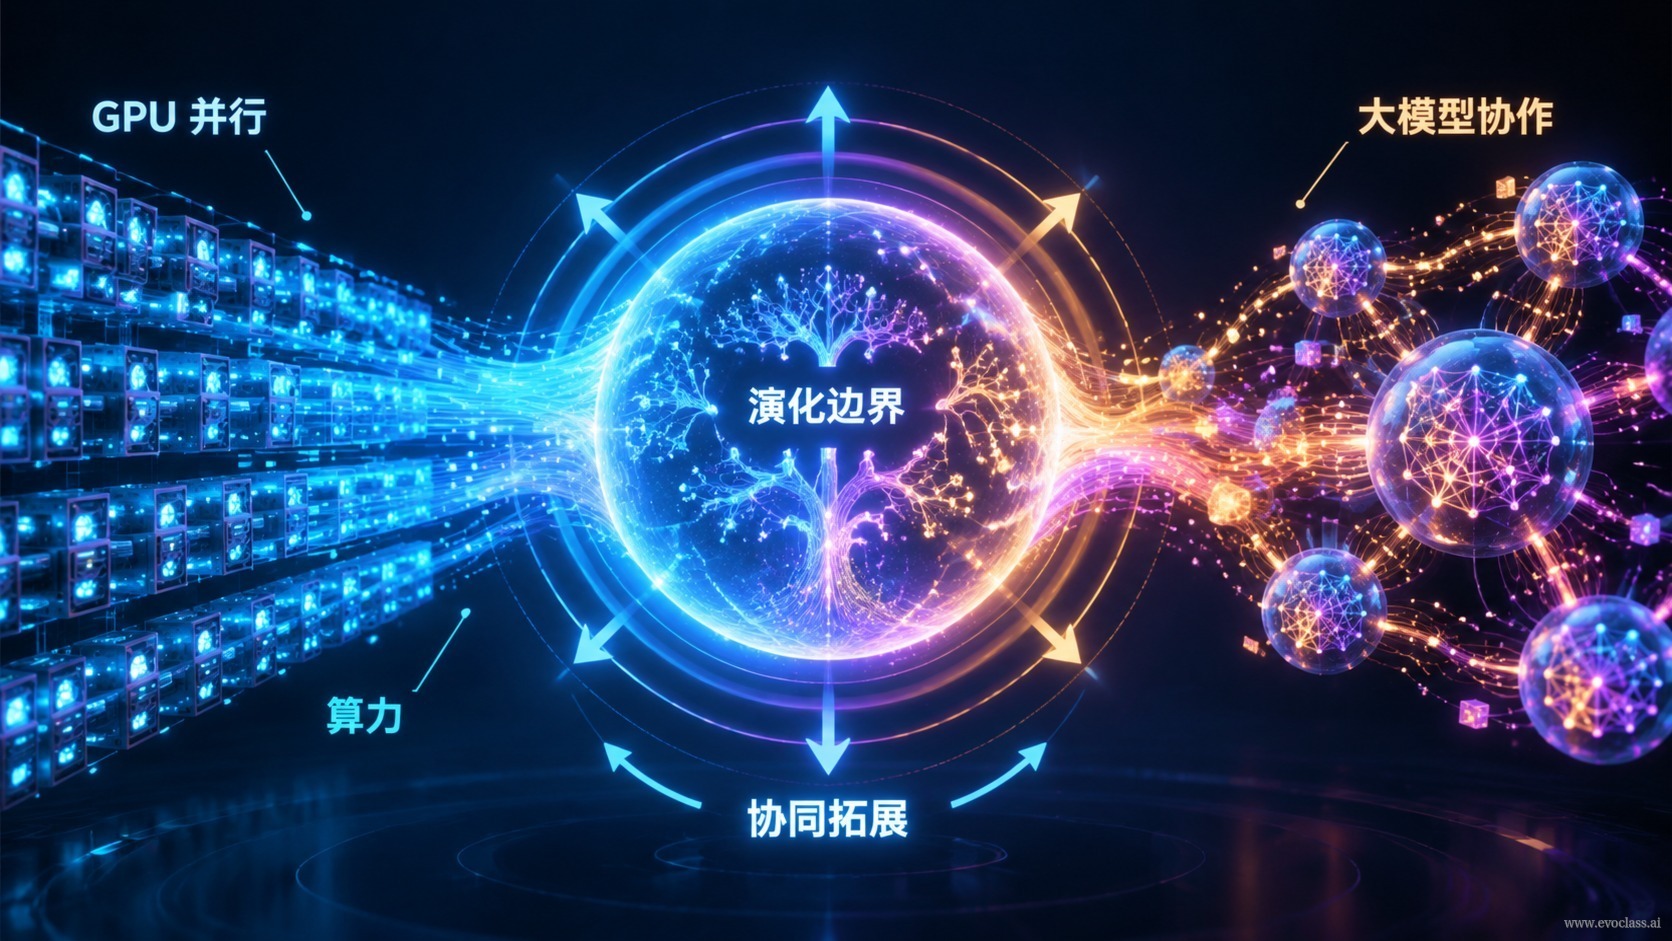
진화 연산은 오랫동안 하나의 현실적인 문제에 발목이 잡혀 있었습니다. 바로 제한된 시간 안에 도대체 얼마나 많은 후보를 평가할 수 있는가 하는 점입니다. 오늘날 이 제약은 두 가지 공학적 힘에 의해 동시에 완화되고 있습니다.GPU 병렬 연산 능력그리고대규모 모델의 의미론적 생성이 둘은 함께 진화 연산의 이중 공학적 토대를 이룹니다.연산 능력은 '한 번에 얼마나 많은 후보를 탐색할 수 있는가'를 결정하고, 대규모 모델은 '어떤 형태의 후보를 탐색할 수 있는가'를 결정합니다.이 둘이 함께 진화 대상의 경계를 수치 파라미터에서 프로그램, 모델 구조, 나아가 알고리즘 메커니즘 자체로 확장합니다.
연산 토대: 후보 공간을 직렬에서 텐서로 옮기다
전통적인 구현에서 개체군 평가는 CPU 상의 직렬 반복문이었습니다. 한 번에 하나의 개체만 처리하며, 스케줄링 오버헤드가 개체군 규모에 따라 누적됩니다. EvoX로 대표되는 오픈소스 토대는 후보, 평가 결과, 알고리즘 상태를 통합적으로전체를 한 번에 계산할 수 있는 텐서로조직합니다. 변이는 전체 개체군에 작용하고, 평가와 상태 업데이트는 선택과 함께 계산 그래프에 들어가 컴파일 최적화를 받습니다. 공학적으로 나타난 직접적인 결과는 '수만 개 규모의 후보를 동시에 탐색'하는 것이 실험실 기법에서 일상적인 관행으로 바뀌었다는 점입니다.
이러한 토대는 시스템을 알고리즘, 문제 모듈, 워크플로, Runtime 스케줄러로 구분합니다. 연구자는 '어떻게 진화시킬 것인가'에만 집중하면 되고, Runtime은 일괄 계산을 GPU, 가속 장치 또는 분산 클러스터로 스케줄링하는 역할을 맡습니다. 분명히 해야 할 점은, 연산 능력이 해결하는 것은처리량이지 '똑똑함'이 아니라는 것입니다. 연산 능력은 후보가 좋은지 판단하지 않고, 전체 개체군의 적합도를 한 번에 계산하는 역할만 합니다. 그것은 후보 공간 확장의기반 지지대이지만 후보가 어떤 모습일지는 결정하지 않습니다.
의미론적 토대: 후보 형태를 수치 벡터에서 구조적 방안으로 끌어올리다
대규모 모델의 기여는 더 빠르게 계산하는 데 있지 않고, 코드와 도메인 지식, 작업 맥락을 이해하여의미론적 수준의 생성 능력을 갖추었다는 데있습니다. 따라서 단순히 수치 벡터 하나를 출력하는 것이 아니라, 바로 호출할 수 있는 해석 코드 한 조각, 대리 모델의 토폴로지 구조와 같이 구조적으로 복잡한 후보를 구성할 수 있습니다. 이로써 후보의 '형태' 공간이 열리게 됩니다.
진화 대상 경계의 3단계 확장
- 수치 파라미터: 고전적인 설정으로, 개체군 구성원은 고정 구조하의 파라미터 값 집합입니다.
- 프로그램 / 모델 구조: 개체군 구성원이 실행 가능한 코드 조각, 또는 네트워크와 대리 모델의 토폴로지 구조로 바뀝니다. 대규모 모델의 생성 능력이 바로 이 단계의 입구입니다.
- 알고리즘 메커니즘: '어떻게 생성하고 어떻게 평가할 것인가'라는 절차 자체도 진화의 대상이 됩니다. 이것이 바로 이후 '진화로 진화를 개선한다'는 접근(예: MetaDE, AutoPSO)이 성립할 수 있는 전제입니다.
익형 최적화를 예로 들어 보겠습니다. 전통적인 방식은 몇 가지 미리 설정된 수치 파라미터에서만 탐색할 수 있었습니다. 대규모 모델이 해석 코드를 읽고 쓸 수 있고 대리 모델 구조를 구성할 수 있으며, GPU가 개체군을 일괄 병렬 평가할 수 있게 되면, 탐색 대상은 '파라미터 값 집합'에서 '생성과 평가 방안 자체'로 상향 이동합니다.
대체가 아닌 상호 보완
둘은 상호 보완 관계입니다. 연산 능력은 탐색의탐색 범위을 넓히고, 대규모 모델은 후보의품질과 형태 복잡도를 높입니다. 어느 한쪽이라도 빠지면 경계 확장은 성립하지 않습니다. 연산 능력만 있고 의미론적 생성이 없다면 탐색 대상은 미리 하드코딩된 인코딩에 여전히 갇혀 있을 것이고, 생성 능력만 있고 일괄 평가가 없다면 수많은 후보를 용인할 수 있는 시간 안에 선별할 수 없습니다.
경계 확장의 대가
경계 확장은 동시에 새로운 제약을 도입합니다. 첫째,평가 비용 상승으로, 단일 평가가 밀리초 수준에서 분 수준으로 늘어날 수 있습니다. 둘째,정확성 검증의 어려움으로, 생성된 코드가 컴파일되지 않거나 물리적·공학적 제약을 충족하지 못할 수 있습니다. 셋째,'사용 가능한 답'의 판정 기준이 더 모호해짐으로, 다목표 트레이드오프와 전문가 의사 결정 등의 단계와 연계해야 합니다.
GPU 병렬 처리와 대규모 모델 협업을 통한 진화 경계 확장 흐름도图示说明演化边界外扩依赖双重底座:GPU 与张量化 Runtime 把种群评价从串行循环搬到批量并行,决定一次能探索多少候选;大模型提供语义级生成,决定能构造何种形态的候选。两者互补后,演化对象可从数值参数扩展到程序/模型结构,再进一步到算法机制,但也会带来评价成本、正确性验证与答案判定标准等新约束。