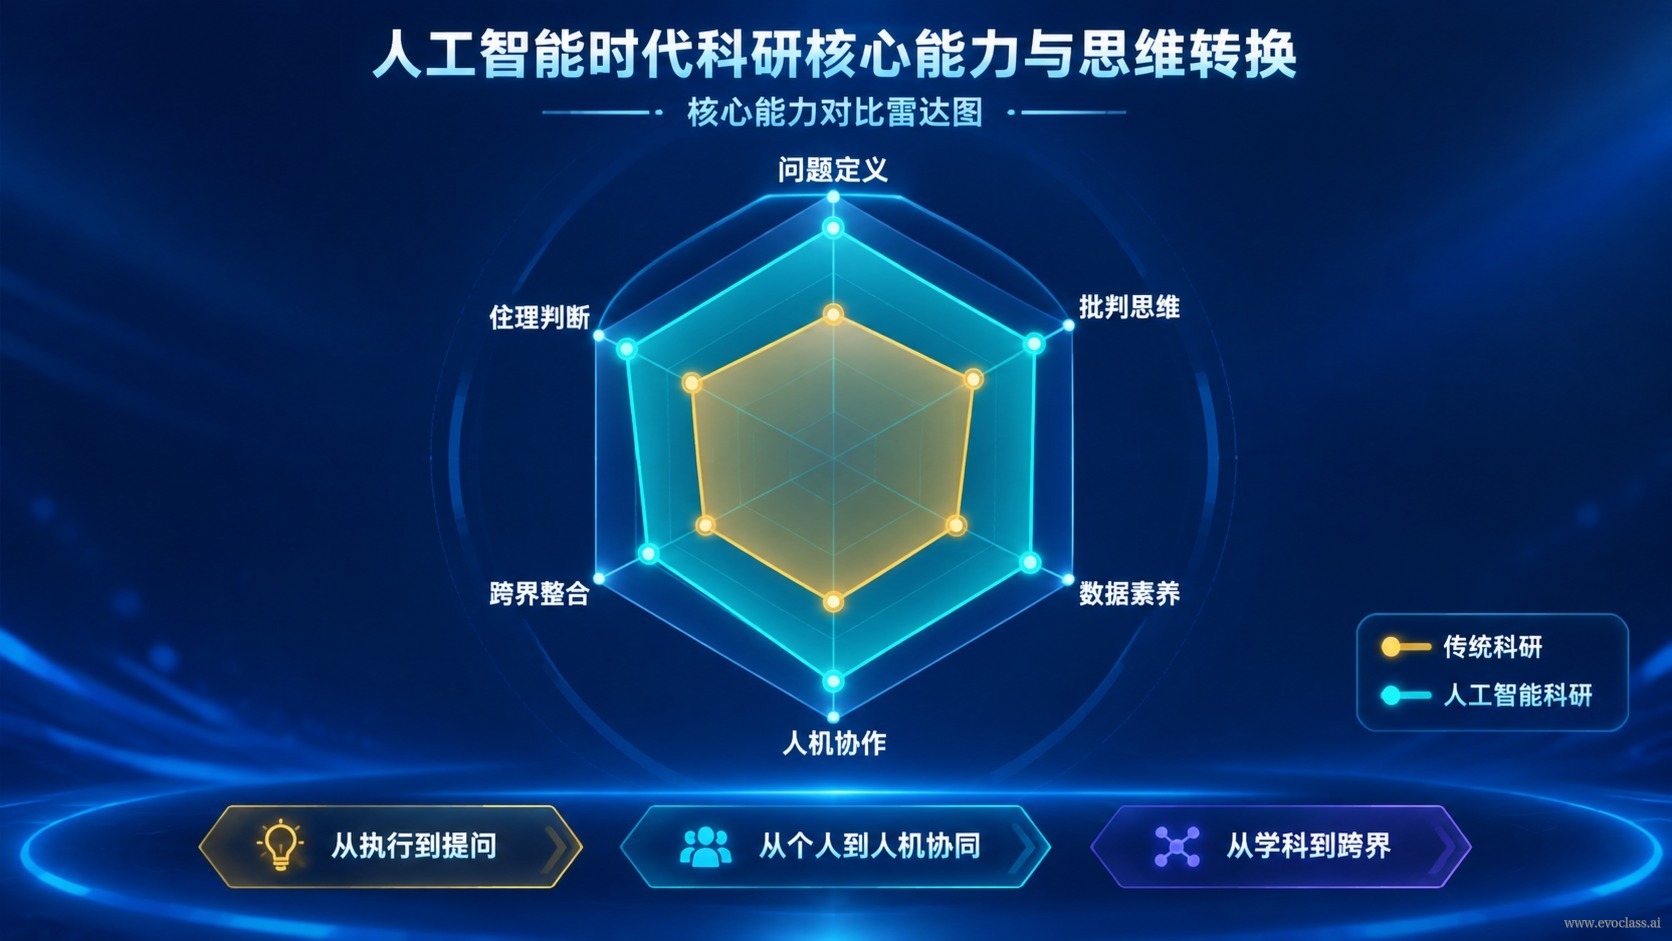
AI 보조 연구 환경에서 연구자의 핵심 역량은 지금 한 차례사고 전환을 겪고 있습니다. 과거에는 '직접 구현 코드를 작성할 수 있는가'로 역량을 평가했지만, 이제 코드와 실험 스크립트는 AI가 빠르게 생성할 수 있습니다. 진정으로 희소한 것은 핵심 질문을 던지고, 평가 기준과 공정한 비교 기준을 정의하며, AI가 산출한 증거를 비판적으로 판단하는 능력입니다.
역할 이동: 구현자에서 증거 중재자로
구현 비용이 크게 낮아지면서 연구자의 역할은 '구현자'에서문제 정의자, 실험 설계자, 증거 중재자로 상향 이동합니다. AI는 아이디어를 실행 가능한 답으로 바꾸는 역할을 담당하지만, '어떤 문제가 답할 가치가 있고 어떤 증거를 신뢰할 수 있는가'는 여전히 연구자가 결정합니다.
- 문제 정의자: 어떤 문제가 과학적 가치를 지니는지 판단하며, 어떤 문제가 결과를 내기 가장 쉬운지가 아닙니다.
- 实验设计者: 모호한 아이디어를 실행 가능하고 재현 가능하며 비교 가능한 실험 프로토콜로 전환합니다.
- 증거 중재자: AI가 제시한 곡선, 지표, 결론에 대해 의문을 품고 그 신뢰 경계와 실패 조건을 캐묻습니다.
인간이 반드시 답해야 할 세 가지 핵심 질문
- 변경 대상: 이번에 바꿀 것은 최적화 파라미터, 프로그램 구현, 알고리즘 구조, 아니면 연구 프로세스 자체입니까? 변경이 이루어지는 층위가 다르면 결론의 의미도 완전히 달라집니다.
- 평가 피드백: 어떤 지표로 관측할지, 어떤 대리 신호로 실제 목표를 근사할지, 합격 기준선을 어디에 둘지, 어떤 상황을 실패로 판정할지—이 네 가지는 하나도 빠뜨릴 수 없습니다.
- 공정 비교: 베이스라인, 예산, 무작위성, 연산 자원 조건, 통계적 검정이 정렬되어 있는지 확인해야 합니다. 정렬되지 않은 비교는 무작위 변동이나 연산 자원 우위를 알고리즘 발전으로 오독하기 쉽습니다.
为什么「品味」至关重要
AI는 '실행되는' 해법을 대량으로 생성할 수 있지만, 실행 가능하다고 해서 가치가 있는 것은 아닙니다.Taste matters: 수많은 실행 가능한 해법 중에서 어떤 문제, 어떤 가설, 어떤 증거가 진정한 과학적 가치를 지니는지 판단하는 것—이것이 바로 인간 연구자의 핵심 가치입니다. 이에 따라 역량의 중심은 단순한 코딩 속도에서 비판적 사고, 시스템 추상화, 도메인 판단, 인간-AI 분업으로 이동합니다.
사례: EvoX / MetaDE 유형 과제
AI는 하루 만에 수십 개의 변이 연산자 변형과 그에 딸린 실험 스크립트를 생성할 수 있습니다. 하지만 연구자는 변이 연산자를 개선할지, 평가 프로세스를 최적화할지, 아니면 탐색 공간을 재구성할지를 결정해야 합니다. 그리고 이에 따라 다목표 지표와 공정한 베이스라인을 설정해야 합니다. 그렇지 않으면 얻는 것은 '실행되는' 결과일 뿐, 신뢰할 수 있는 지식이 아닙니다.
핵심 역량의 이동이 그림은 역량 비교를 통해 AI 시대 연구 역량의 중심 이동을 보여줍니다. 구현이 빠르게 산출될 수 있게 되면서, 연구자의 더 결정적인 가치는 핵심 질문을 던지고, 재현 가능한 실험을 설계하고, 증거의 경계를 판단하며, 베이스라인·예산·통계적 검정의 공정한 정렬을 보장하는 것으로 이동합니다.
핵심 역량의 이동
이 그림은 역량 비교를 통해 AI 시대 연구 역량의 중심 이동을 보여줍니다. 구현이 빠르게 산출될 수 있게 되면서, 연구자의 더 결정적인 가치는 핵심 질문을 던지고, 재현 가능한 실험을 설계하고, 증거의 경계를 판단하며, 베이스라인·예산·통계적 검정의 공정한 정렬을 보장하는 것으로 이동합니다.