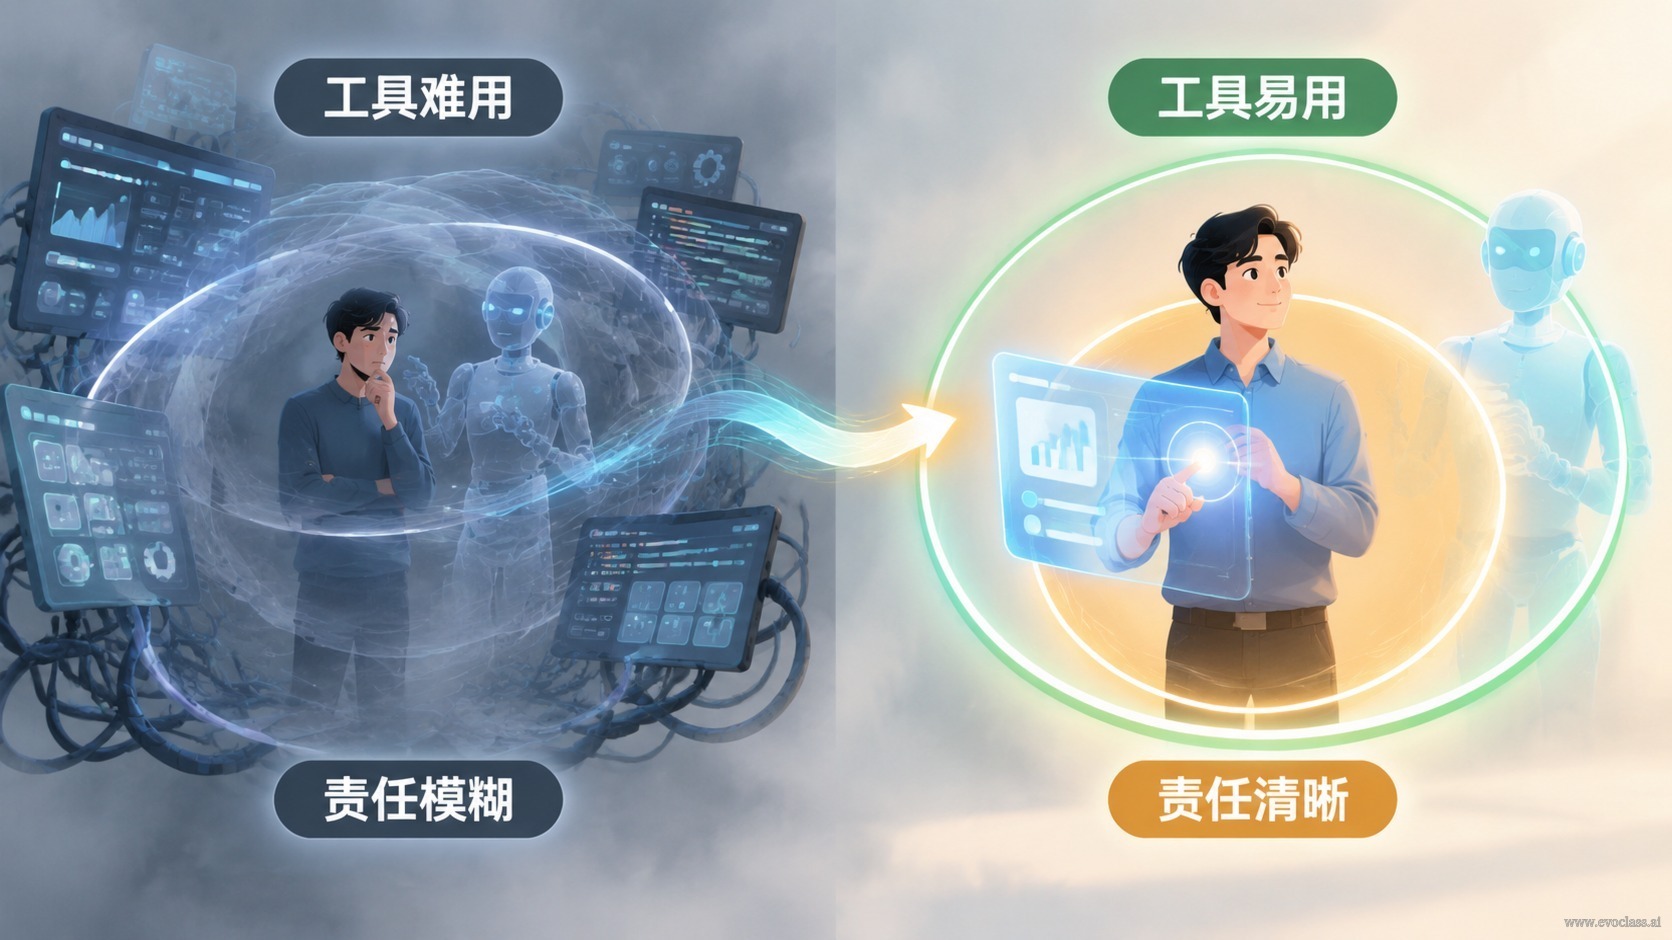
AI와 EvoX가 '아이디어 → 코드 → 실험'의 실행 비용을 극도로 낮출 때 가장 흔히 생기는 착각은 판단까지도 값싸졌다는 것입니다. 그러나 사실은 정반대입니다——도구가 사용하기 쉬울수록 사람의 책임은 더 명확해진다. 모델은 아이디어를 신속하게 실행 가능한 후보 구현으로 바꿀 수 있지만, 연구자를 대신해 이 아이디어가 연구할 가치가 있는지, 목표가 정확한지, 비교가 공정한지를 결정할 수는 없습니다.
책임의 상향 이동: 구현에서 정의와 판단으로
- 실행 비용 감소 ≠ 판단 비용 소멸: AI와 EvoX는 코드 생성과 실험 루프를 가속하지만, 문제 선택, 목표 정의, 평가 기준은 여전히 사람이 담당합니다. 실행이 된다는 것은 하나의 후보 수정일 뿐, 과학적 결론이 성립함을 의미하지 않습니다.
- 외주화할 수 없는 세 가지 판단: 문제가 연구할 가치가 있는지, 목표가 정확한지, 비교가 공정한지입니다. 이 세 가지는 과학적 타당성의 전제 조건이며, 자동화 시스템이 대체할 수 없는 판단 지점입니다.
- 자동화에 따라 드러나는 책임의 경계: 도구가 강력할수록 어떤 결정을 Agent가 제안하고, 어떤 것을 사람이 반드시 승인해야 하며, 어떤 검수 기준이 타협 불가인지를 명확히 해야 합니다. Genesis의 검수 게이트웨이는 이 경계를 공학적으로 구현했습니다——후보 수정은 컴파일, 테스트, 동작 검사와 상위 검수를 통과해야만 프로젝트 이력에 들어갈 수 있습니다.
실행 성공보다 결과의 유효성이 우선
다목표 EvoX 실험에서 Agent는 후보 방안을 신속하게 생성하고, 일괄로 파라미터를 조정하며, 멋진 수렴 곡선을 그릴 수 있습니다. 그러나 '목적 함수가 실제 요구를 대표하는지, 후보 다양성이 단일 지표에 가려지지 않았는지, 실패 모드가 선택적으로만 제시되지 않았는지'는 연구자가 하나하나 검토해야 합니다. 도구의 진정한 가치는 저가치 구현을 더 빠르게 도태시키고, 고가치 판단을 더 일찍 병목으로 만드는 것이며——바로 이 지점이 연구자의 전문성이 발휘되는 곳입니다.
튜링 팁
앞으로 완수해야 할 일이 많습니다. 코드는 저렴하고, 안목이 중요합니다. 핵심 역량은 핵심 질문을 던지고 재현 가능한 방식으로 결론의 유효성을 관리하는 것입니다——연구자의 안목이 기술적 편의가 궁극적으로 어떤 과학적 가치로 전환될지를 결정합니다.
인간-AI 협업의 책임 경계이 그림은 인간-AI 협업의 책임 경계를 보여줍니다. AI와 EvoX가 압축하는 것은 아이디어에서 코드로, 다시 실험으로 이어지는 실행 비용이며, 문제가 연구할 가치가 있는지, 목표가 정확한지, 비교가 공정한지는 여전히 사람이 판단합니다. 후보 수정은 컴파일, 테스트, 동작 검사와 상위 검수의 게이트웨이를 통과해야만 프로젝트 이력에 들어갈 수 있으며, 실행 성공보다 결과의 유효성이 우선합니다.
인간-AI 협업의 책임 경계
이 그림은 인간-AI 협업의 책임 경계를 보여줍니다. AI와 EvoX가 압축하는 것은 아이디어에서 코드로, 다시 실험으로 이어지는 실행 비용이며, 문제가 연구할 가치가 있는지, 목표가 정확한지, 비교가 공정한지는 여전히 사람이 판단합니다. 후보 수정은 컴파일, 테스트, 동작 검사와 상위 검수의 게이트웨이를 통과해야만 프로젝트 이력에 들어갈 수 있으며, 실행 성공보다 결과의 유효성이 우선합니다.