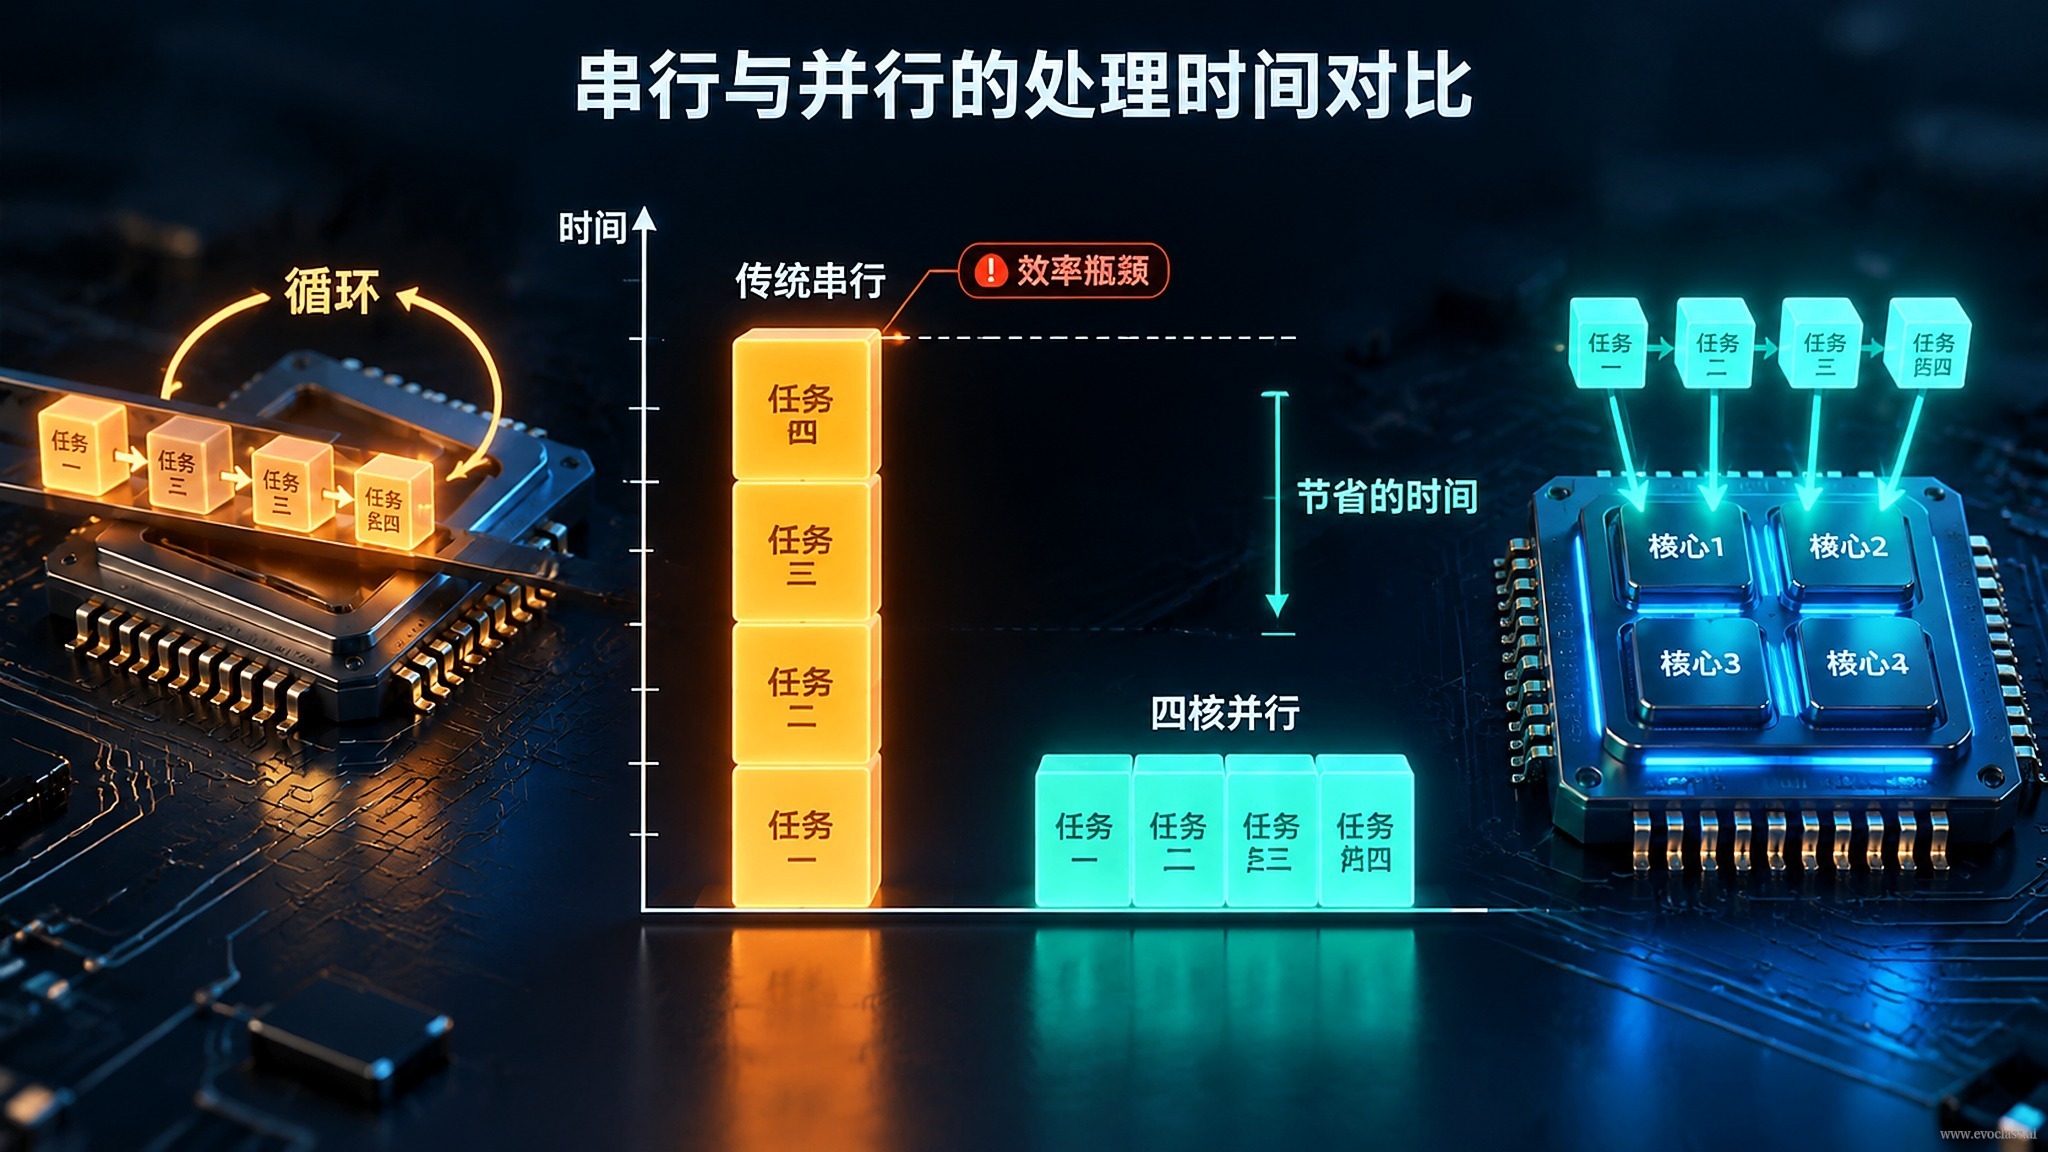
O processo evolutivo depende da diversidade da população, e diversidade significa crescimento exponencial do tamanho da população e do número de avaliações. Quando as avaliações de candidatos chegam à casa das dezenas de milhares,o laço sequencial tradicional de CPUtorna-se o trecho mais estreito de toda a linha de produção: ele processa apenas um indivíduo por vez, deixando a capacidade paralela do hardware praticamente ociosa.
Um de cada vez: o modelo de execução do laço sequencial
A implementação mais simples trata toda a população como uma lista e percorre os indivíduos um a um em um laço: obter indivíduo → decodificar em parâmetros concretos → chamar a função de avaliação → escrever o fitness de volta. Iterações adjacentes dificilmente se sobrepõem: enquanto o resultado da avaliação não retorna, a escrita não avança; enquanto a escrita não termina, o próximo indivíduo não tem onde depositar seu resultado. Assim, unidades paralelas como múltiplos núcleos, SIMD e GPU passam a maior parte do tempo ociosas, apenas observando um único indivíduo percorrer toda a linha de produção.
De onde vem exatamente a sobrecarga
- Número de avaliações com crescimento linear: o número total de avaliações é aproximadamente o tamanho da população × o número de gerações; ao atingir a ordem de 10⁵, o tempo de relógio de parede sequencial cresce de forma quase linear.
- Execução individual no nível do interpretador: laços por indivíduo, verificação de limites e despacho de tipos geram uma sobrecarga constante, fixa porém elevada.
- Acesso não contíguo à memória e movimentação de dados: os indivíduos acessados um a um costumam ser não contíguos na memória, a taxa de acertos de cache é baixa e o custo de movimentação é pago repetidas vezes.
- Sincronização e escalonamento: para buscar o próximo indivíduo, o fluxo de execução precisa parar e retomar repetidamente.
Convertendo escala em tempo
Tomando como exemplo uma população de 1000 e 100 gerações, há cerca de 100 mil avaliações de candidatos. Se cada avaliação levar em média 1 ms, apenas a etapa de avaliação em série exigirá cerca de 100 segundos, sem contar a sobrecarga de cálculo dos operadores e de escalonamento; se, para manter a diversidade, o número de reinicializações aumentar de 1 para 5, o custo sobe de forma quase linear para cerca de 500 segundos. Para a mesma carga de trabalho organizada em lotes e processada por hardware paralelo, o tempo de relógio de parede é determinado principalmente pelo número de lotes, e não pelo número de indivíduos.
Quando esse gargalo se estreita
As condições de contorno também são importantes: quando cada avaliação é extremamente barata (na casa dos microssegundos) ou a população é muito pequena (abaixo da centena), a sobrecarga de escalonamento e de memória pode superar o custo de cálculo, a diferença entre sequencial e paralelo diminui sensivelmente, o ganho marginal da tensorização diminui e o gargalo se desloca para a granularidade do escalonamento e a largura de banda da memória. Portanto, se vale a pena reformular o modelo de execução deve ser avaliado em conjunto com o custo de avaliação e a escala.
Comparação de tempo entre sequencial e paraleloTomando como exemplo uma população de 1000 e 100 gerações, há cerca de 100 mil avaliações de candidatos; com cada avaliação levando 1 milissegundo, a etapa de avaliação em série sozinha exige cerca de 100 segundos, e com 5 reinicializações esse valor cresce de forma quase linear para cerca de 500 segundos. Ao organizar por lotes e entregar a hardware paralelo, o tempo de relógio de parede passa a ser determinado principalmente pelo número de lotes, e não pelo número de indivíduos.