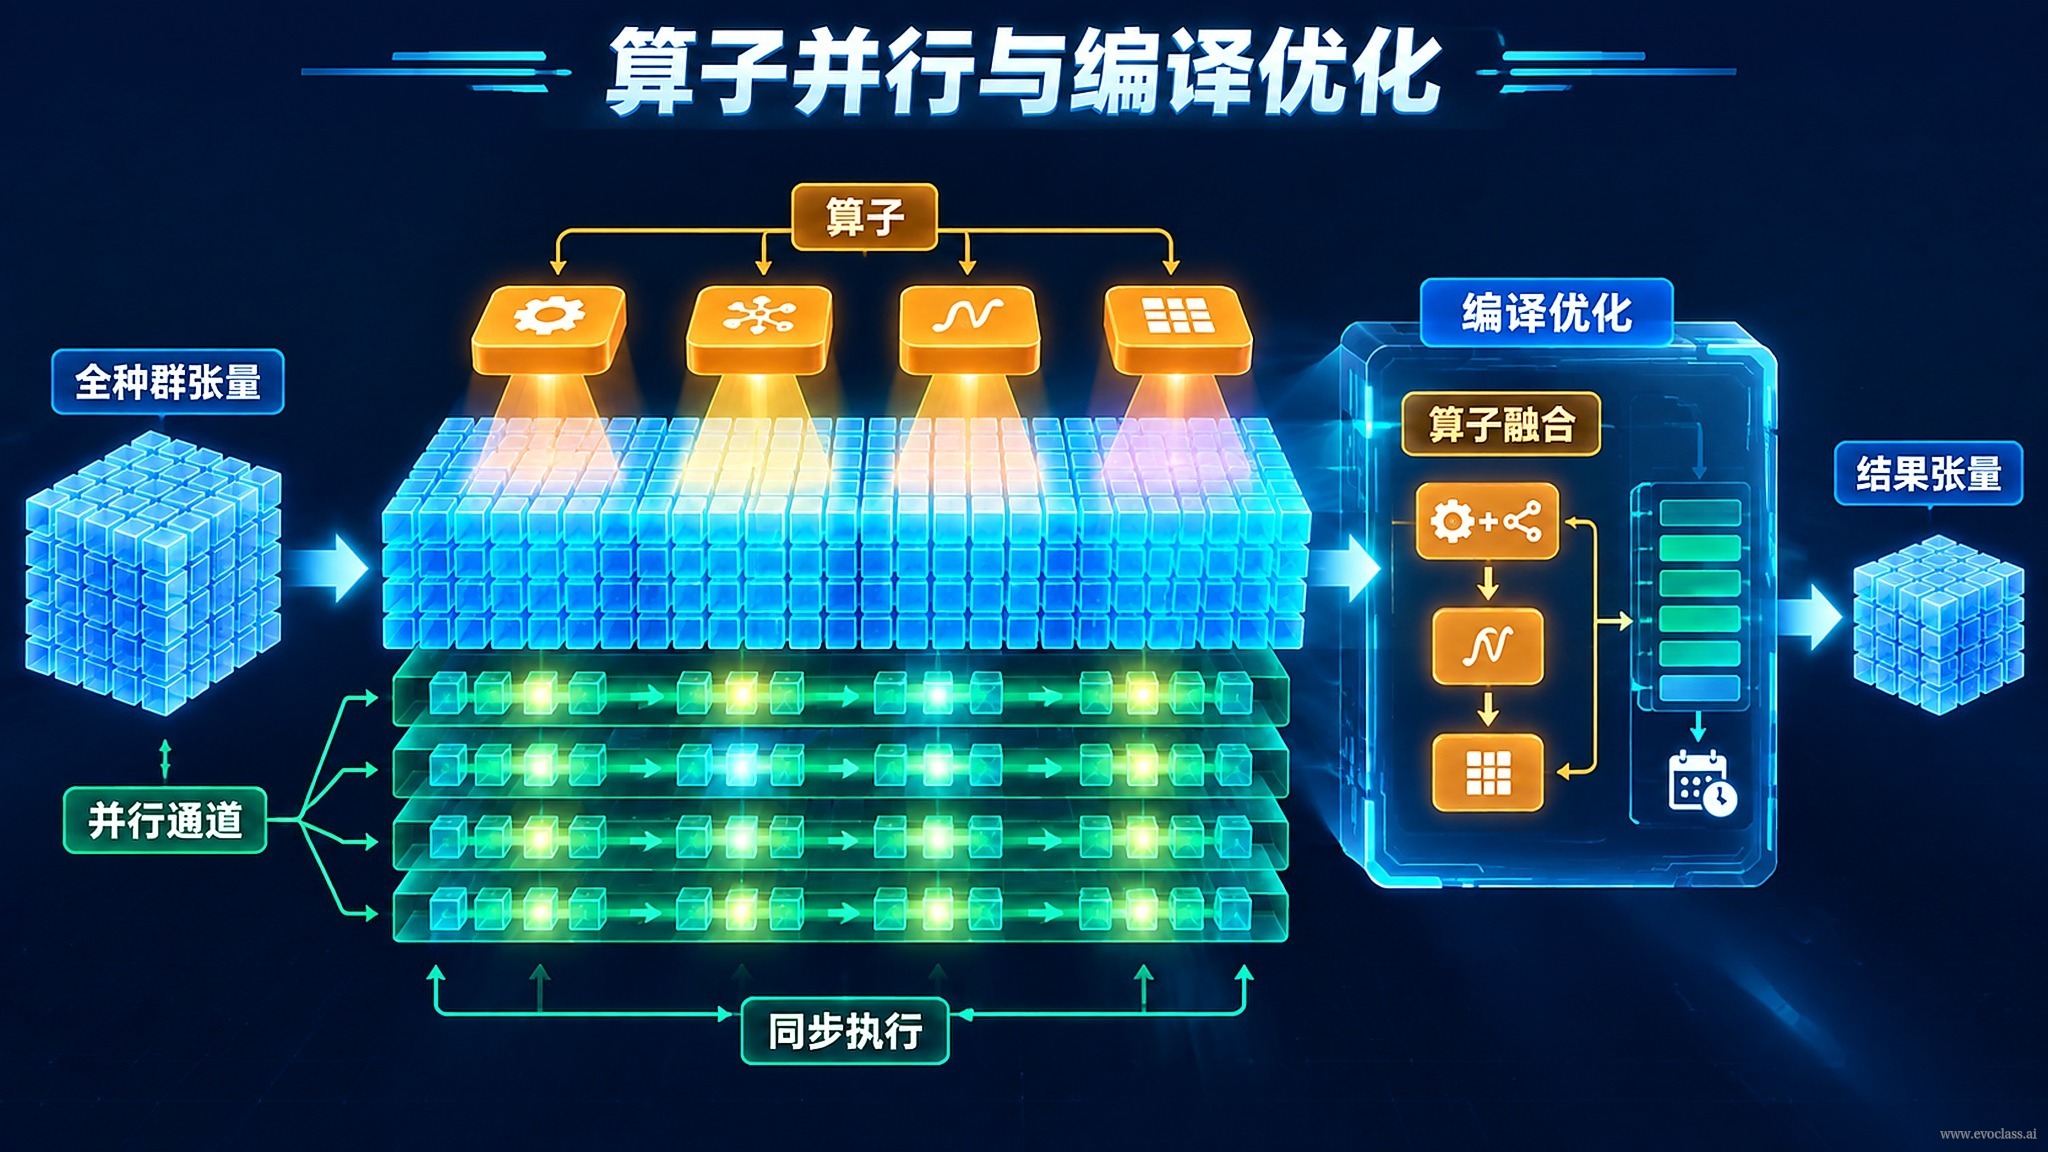
No EvoX , a unidade mínima de execução dos operadores evolutivos não é mais o "indivíduo", mas sim todo otensor de população: operadores como mutação, cruzamento e seleção cobrem todos os indivíduos em uma única chamada; sobre isso,a compilação de grafos computacionaisorganiza a sequência de operadores em um plano de execução otimizável, aumentando a eficiência de execução sem alterar a semântica do algoritmo.
Paralelismo de operadores: evolução em lote por tensores
- Operadores em nível de tensor: mutação, cruzamento e seleção podem atuar diretamente sobre o tensor de população de formato [N, D] (N é o tamanho da população e D é a dimensão das variáveis de decisão); uma única chamada do operador cobre todos os N indivíduos.
- Eliminação do loop por indivíduo: não é mais necessário escrever
for ind in population: ind = mutate(ind)esse tipo de loop serial em Python/CPU, reduzindo a sobrecarga frequente de agendamento de funções e de chamadas ao framework. - Trocar dimensão de lote por throughput: quando a dimensão dos indivíduos atua como dimensão de lote, os operadores são executados no dispositivo de forma massivamente paralela, e o throughput da evolução em lote cresce com o tamanho da população.
Compilação de grafos computacionais: da sequência de operadores ao plano de execução
Organizando as dependências entre os operadores "mutação → cruzamento → seleção" em umgrafo computacional, o compilador pode realizar otimizações globais sobre todo o grafo, em vez de apenas chamar implementações prontas operador por operador:
- Fusão de operadores: combina várias operações elemento a elemento (element-wise) em um único kernel, reduzindo a criação de tensores intermediários e as leituras e gravações repetidas.
- Geração e escalonamento de kernels: gera kernels eficientes para o subgrafo fundido, concluindo a evolução de uma geração inteira com menos lançamentos de kernel.
- Reúso de memória: planeja previamente os buffers para os resultados intermediários, reduzindo a sobrecarga adicional de alocação de memória de vídeo e movimentação de dados.
A eficiência mudou, a semântica não
É preciso distinguir"como calcular"de"o que calcular". O paralelismo de operadores e a otimização de compilação alteram apenas o modo de execução — número de kernels, escala dos tensores intermediários, estratégias de memória e escalonamento — sem mudar o significado lógico de mutação, cruzamento e seleção. A camada do algoritmo continua combinando os operadores conforme a semântica evolutiva; portanto, com a mesma semente aleatória, a trajetória evolutiva e os resultados antes e depois da otimização devem ser idênticos. Em resumo: a tensorização resolve "quão rápido o lote é calculado", a compilação de grafos computacionais resolve "quão otimizado é o escalonamento dos kernels", e "o que é calculado" permanece inalterado.
Fluxo paralelo dos operadores sobre o tensor de toda a populaçãoMutação, cruzamento e seleção não fazem mais loop por indivíduo; cada um cobre todo o tensor de população [N, D] em uma única chamada, e a dimensão dos indivíduos atua como dimensão de lote para ampliar o throughput; depois que esses operadores formam um grafo computacional segundo suas dependências, o compilador pode realizar fusão de operadores, geração de kernels e reúso de memória, alterando apenas o modo de execução — a semântica do algoritmo e a trajetória evolutiva com a mesma semente aleatória permanecem inalteradas.