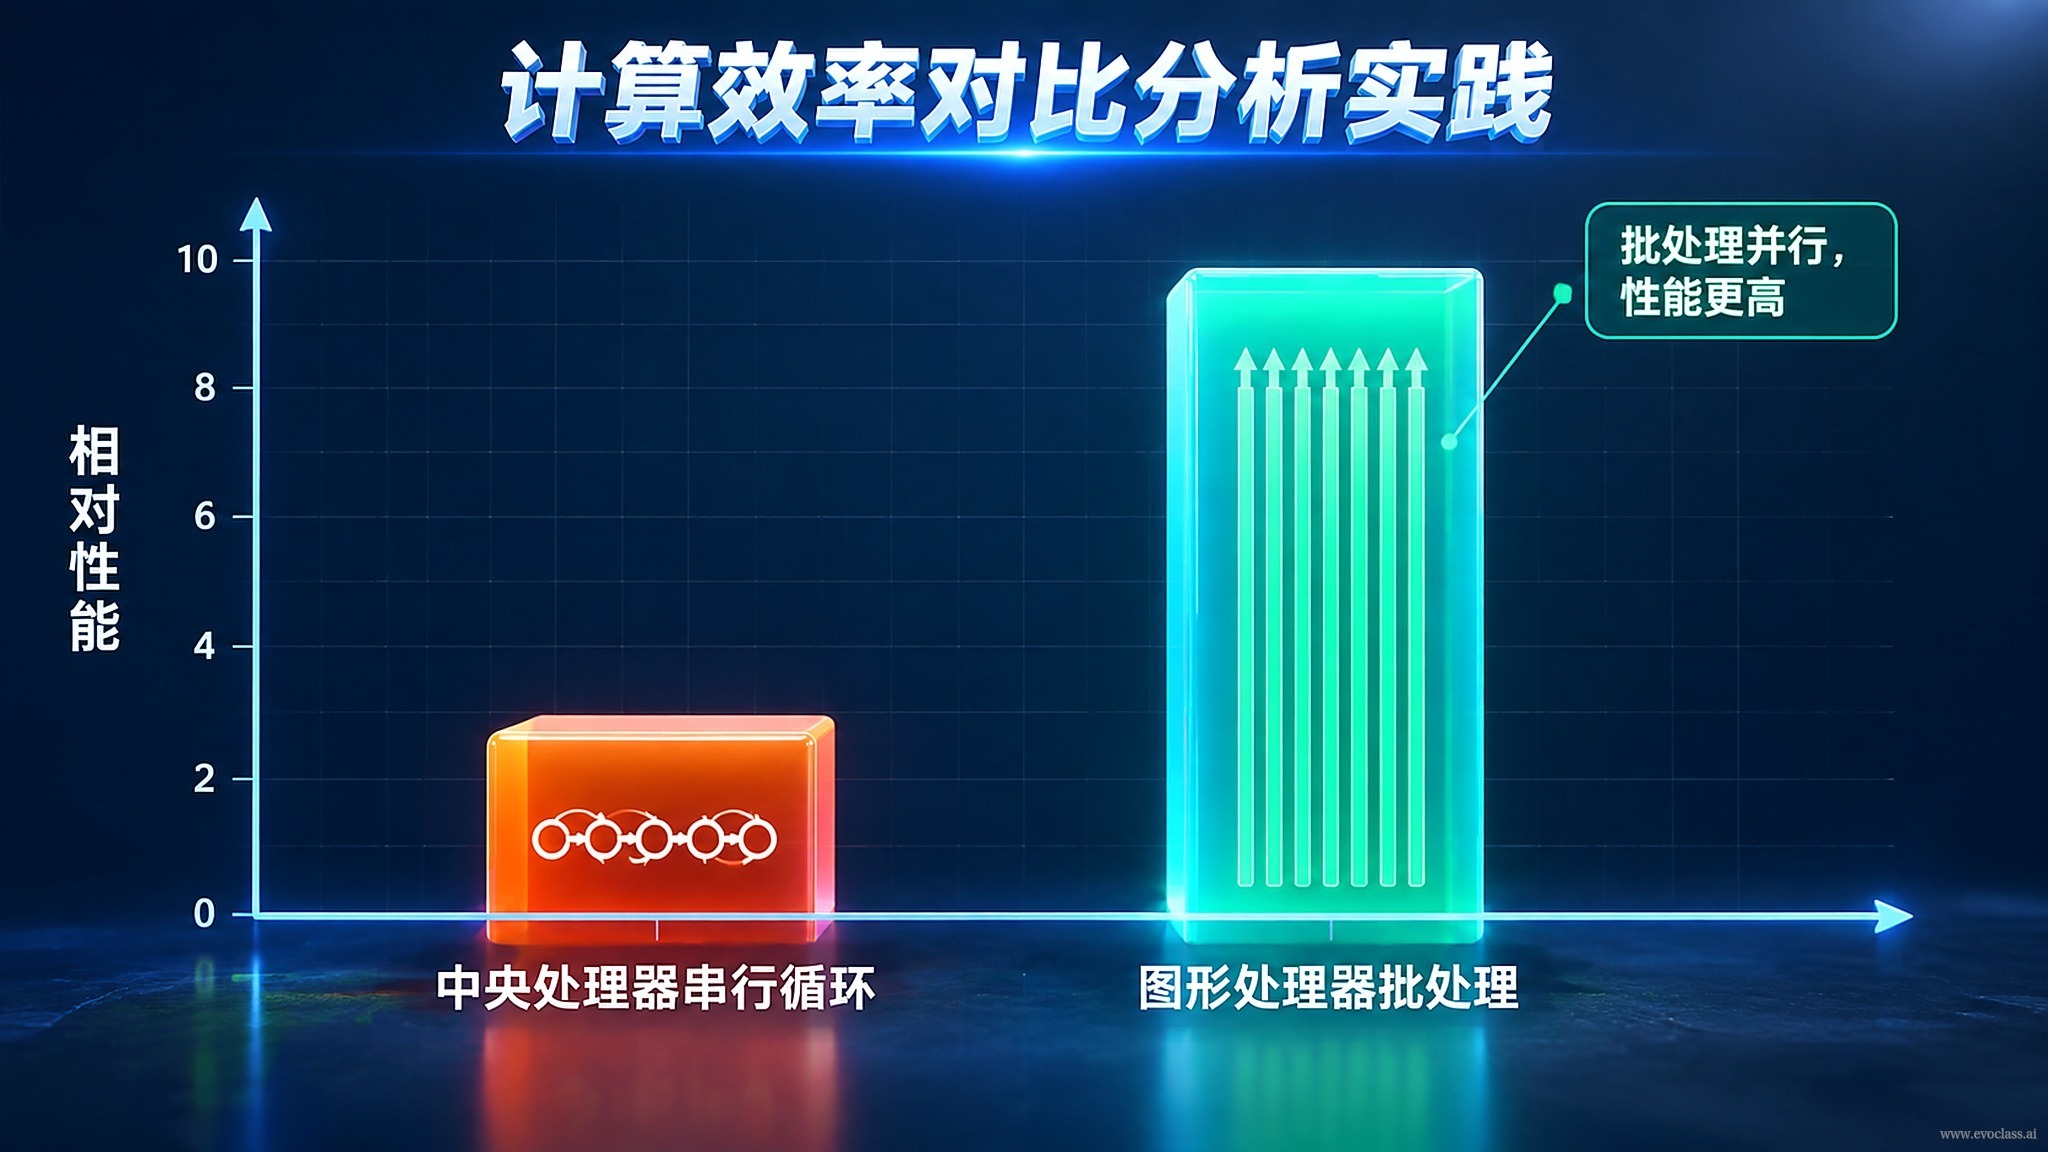
Esta página põe a «comparação de eficiência computacional» em prática de forma reproduzível:comparar, numa mesma tarefa evolutiva, a eficiência ponta a ponta da iteração serial indivíduo a indivíduo em CPU tradicional com o processamento em lote tensorial na GPU via EvoX. O objetivo não é memorizar a conclusão de que «a GPU é mais rápida», mas compreender de onde vem exatamente o ganho de velocidade trazido pelo paralelismo tensorial, qual é o seu custo e onde estão os seus limites.
Duas linhas de base, uma mesma tarefa
- Linha de base serial em CPU: utiliza um laço para chamar a função de avaliação indivíduo a indivíduo, exigindo N agendamentos independentes, atualizações de estado e agregação de resultados por geração. O controle do laço, a sobrecarga do interpretador e os acessos dispersos à memória diluem o poder computacional efetivo; quanto mais indivíduos, maior a proporção desses custos «não computacionais».
- Implementação de comparação com tensores na GPU: o EvoX organiza a população, as entradas de avaliação e o estado de execução como tensores, executando avaliações e operadores em lote na GPU, de modo que uma única chamada cobre todo o conjunto de candidatos, reduzindo drasticamente os laços seriais e o número de agendamentos.
Protocolo de medição: tornar a comparação reproduzível
Uma comparação reproduzível devefixar o problema, o tamanho da população, o número de gerações e a semente aleatória, e então registrar: o tempo real (wall-clock) por geração, o tempo total, a taxa de transferência (avaliações/segundo), a aceleração, além da utilização da GPU e do uso de memória de vídeo. Antes de cronometrar, é necessárioaquecimentopara eliminar o efeito da primeira compilação e da alocação de memória de vídeo, e realizar, nos pontos de medição,sincronização do dispositivo, contabilizando separadamente o tempo de computação e o tempo de transferência de dados entre host e dispositivo. A ausência de qualquer uma dessas etapas pode distorcer a aceleração obtida.
De onde vem a diferença e a que restrições está sujeita
- Origem dos ganhos: o paralelismo em lote, os operadores tensoriais e o paralelismo no dispositivo permitem que uma única chamada processe todo o conjunto de candidatos, concluindo mais avaliações por unidade de tempo.
- Condições restritivas: o tamanho do lote, a dimensionalidade do problema, o grau de vetorização da função de avaliação, o custo de cópia host–dispositivo e o custo de lançamento de kernels afetam todos a aceleração final. Lotes muito pequenos têm os ganhos consumidos pelo custo de lançamento; se a função de avaliação não puder ser vetorizada, o processamento em lote dificilmente terá efeito.
Conclusões práticas
A ordem correta é:primeiro verificar se a função de avaliação pode ser processada em lote e só depois comparar as implementações em CPU e GPU. A vantagem de eficiência deve, em última análise, traduzir-se em «obter mais gerações ou mais soluções candidatas com o mesmo orçamento computacional», e, com base nisso, decidir a forma de implantação e o desenho experimental, em vez de simplesmente perseguir um número de aceleração vistoso.
Comparação de eficiência entre CPU serial e processamento em lote na GPUNa comparação, a linha de base serial em CPU avalia indivíduo a indivíduo num laço, exigindo N agendamentos e atualizações de estado por geração, com a sobrecarga do interpretador e dos acessos à memória diluindo o poder computacional efetivo; o processamento em lote na GPU organiza a população e as entradas de avaliação como tensores, cobrindo todo o conjunto de candidatos numa única chamada. A aceleração está sujeita ao tamanho do lote, ao grau de vetorização da função de avaliação e ao custo de cópia host–dispositivo.