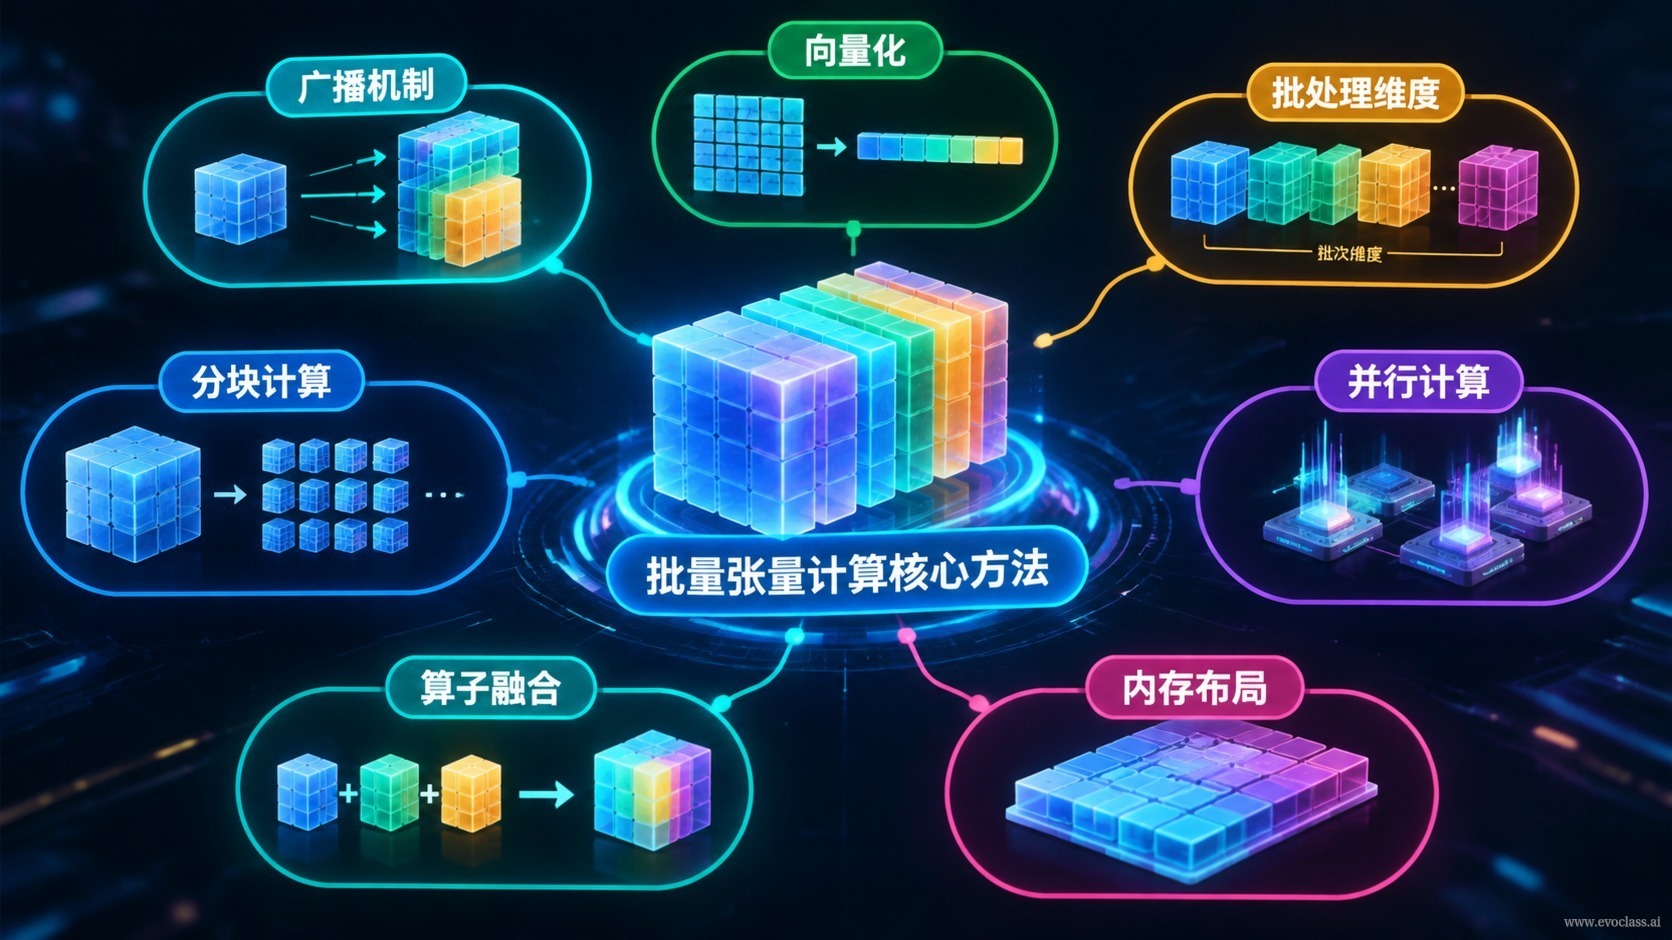
Na base de tensorização do EvoX,a computação tensorial em lotesitua-se na camada de expressão algorítmica: ela mapeia de forma unificada os candidatos, as avaliações e os estados do ciclo evolutivo comotensores com dimensão de lote, e então os entrega a operadores em lote compatíveis com GPU e a grafos computacionais compilados para execução. O objetivo é bem claro — transformar a “evolução serial indivíduo por indivíduo” em “evolução paralela de toda a população”, fazendo com que o poder computacional atue de fato sobre a própria busca, em vez de ser consumido em agendamento e inicialização.
I. Expressar o processo evolutivo como tensores
Convencionando que a dimensão de lote N representa o número de candidatos (indivíduos), os três elementos da evolução podem ser diretamente expressos como tensores:
- Tensor de candidatos: a população X é organizada como [N × D], onde D é o número de variáveis de decisão de um único candidato.
- Tensor de objetivos: os objetivos e restrições F são organizados como [N × M], onde M é o número de termos de objetivo/restrição; em cenários multiobjetivo, cada objetivo corresponde a uma coluna diferente de F.
- Variáveis de estado: geração, melhor valor atual, tamanho do passo etc. são mantidos em buffers escalares ou de pequenos tensores, em vez de serem registrados indivíduo por indivíduo com objetos Python.
Assim, cruzamento, mutação, seleção e avaliação são todos processados em lote ao longo da dimensão N, e o ciclo evolutivo deixa de conter ramificações e fluxos de controle indivíduo por indivíduo.
II. Operadores em lote: de N chamadas por candidato a uma única operação em lote
Três expressões mínimas de referência delineiam a forma básica dos operadores em lote:
- Mutação: X′ = X + σ·randn(X), todo o lote de candidatos recebe perturbações aleatórias individuais em uma única operação em lote, e σ controla a intensidade da perturbação.
- Seleção: idx = topk(F, k), seleciona de uma só vez os índices dos k melhores candidatos entre as aptidões dos N candidatos.
- Avaliação: Y = fθ(X), substituindo N chamadas por candidato por uma única passagem direta em lote ou simulação em lote.
O ponto-chave não está em um operador específico, mas no fato de que todos os candidatos compartilham o mesmo grafo de operações tensoriais: uma única chamada em lote reduz o custo do interpretador e a sobrecarga de inicialização de kernels, fazendo com que o poder da GPU/multinúcleo atue de fato sobre a busca evolutiva. O tratamento de restrições e violações de limites também pode ser feito com tensores de máscara dentro da mesma operação em lote, sem necessidade de ramificações separadas para candidatos individuais.
III. Otimização de grafos computacionais e métricas de throughput
Escrever várias gerações de evolução como um grafo de fluxo de dados compilável permite extrair ainda mais desempenho:Fusão de operadoresreduz o número de inicializações de kernel,Paralelismo dentro do lotefaz todos os candidatos executarem simultaneamente,Execução assíncronafaz a computação e a transferência de dados se sobreporem,Reutilização de memóriae reduz a alocação de tensores intermediários. Consequentemente, as métricas de desempenho também devem migrar da “latência por passo” paracandidatos/s ou gerações/sde throughput — na execução em lote, uma única chamada processa todo o lote de candidatos, e somente o throughput global reflete de forma fiel a eficiência da busca.
Mapa mental dos métodos essenciais de computação tensorial em loteO mapa mental expressa o processo evolutivo como tensores com dimensão de lote: a população X é N×D, os objetivos e restrições F são N×M, e cruzamento, mutação, seleção e avaliação são todos processados em lote ao longo da dimensão N. Mutação, seleção topk e avaliação por passagem direta em lote exigem apenas uma chamada em lote, e as métricas de desempenho migram da latência por passo para o throughput em candidatos/s.