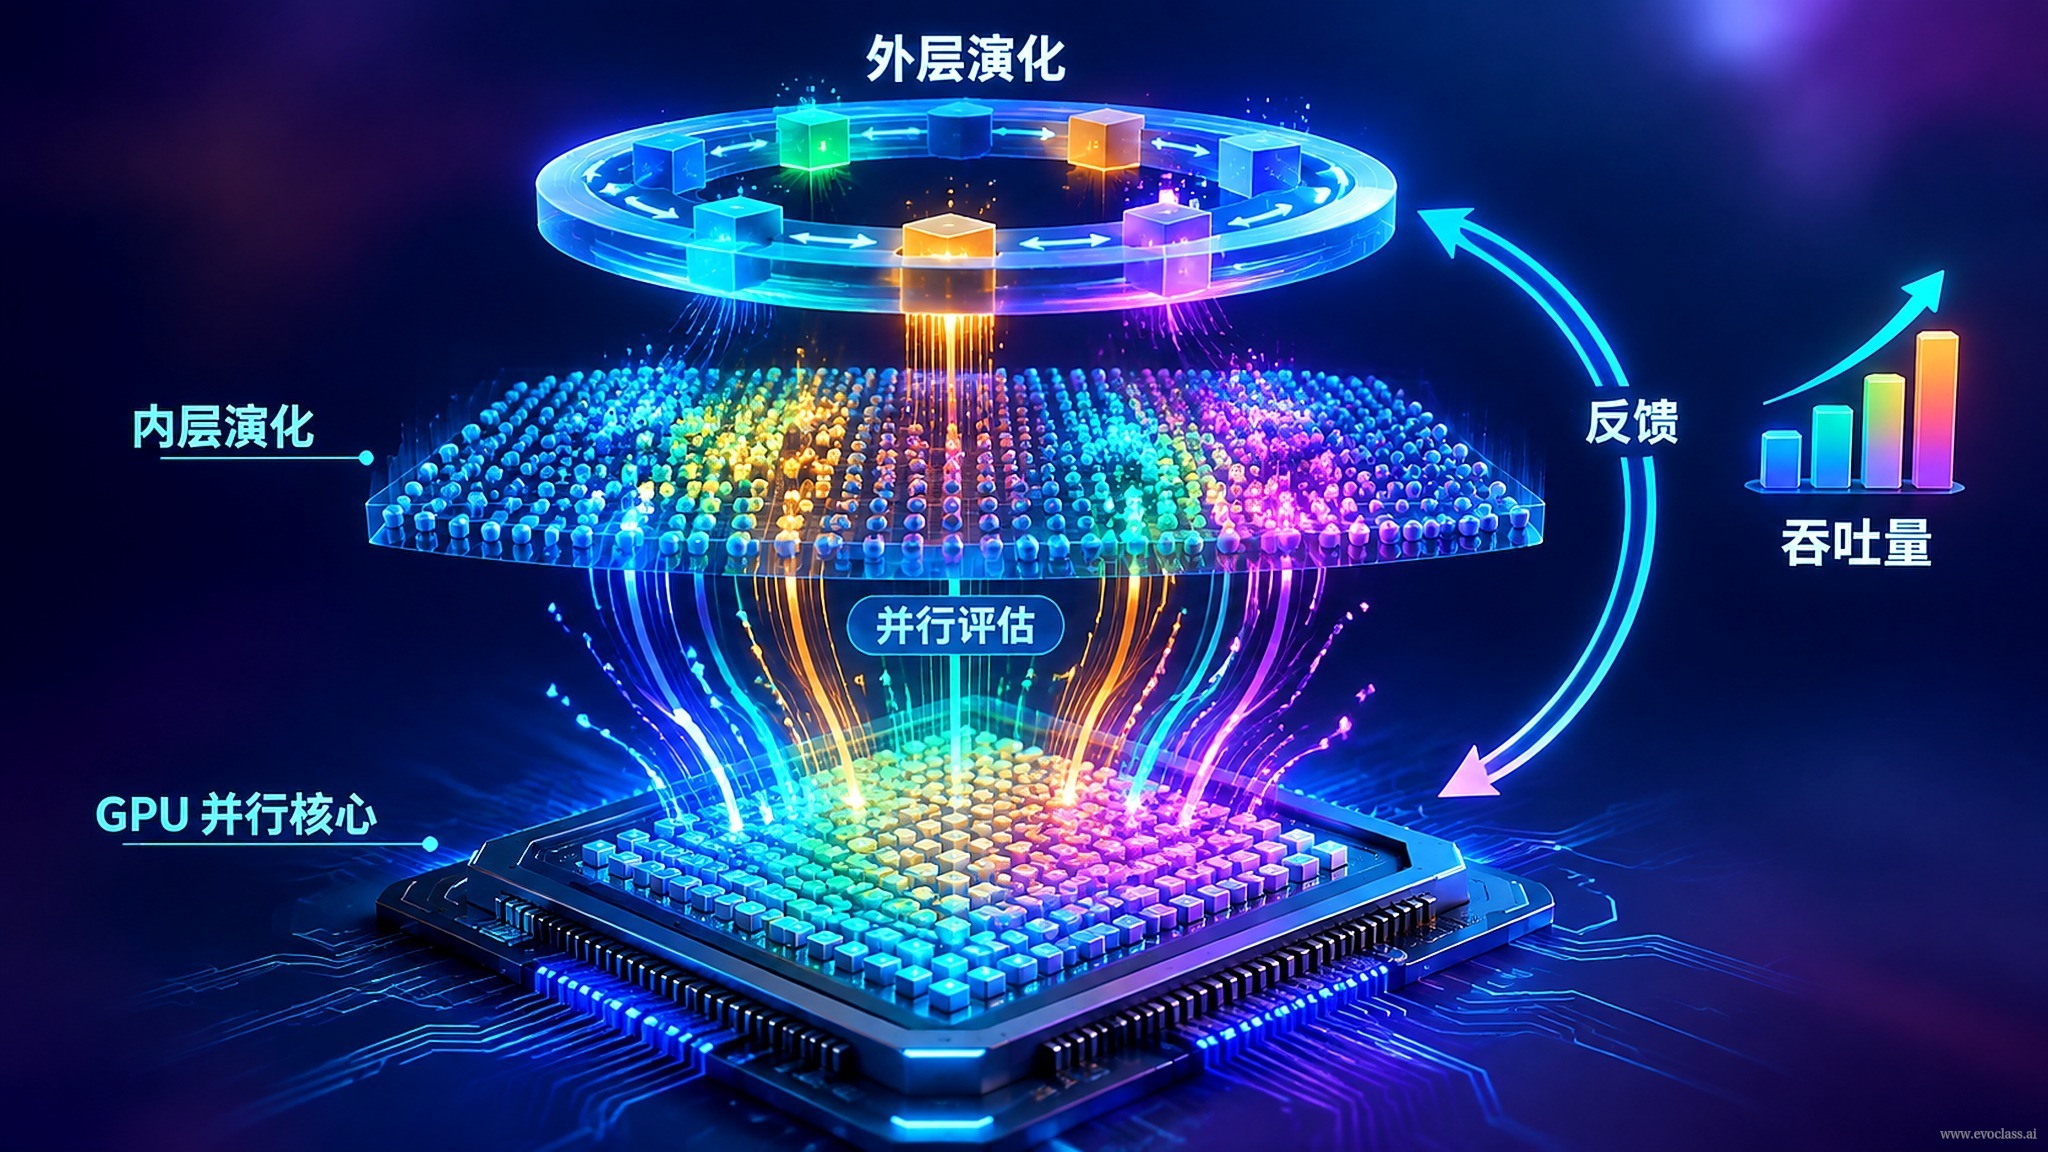
Quando algoritmos evolutivos são usados paramelhorar os próprios algoritmos evolutivos, o sistema passa a ter duas camadas de computação simultâneas: a camada interna executa e avalia um grande número de configurações de algoritmo em inúmeras instâncias de tarefas, enquanto a camada externa seleciona, muta e atualiza configurações com base nesses resultados. Sem uma base de paralelismo robusta, a evolução externa se torna um gargalo, arrastada pela avaliação serial da camada interna.O paralelismo em GPUé justamente a chave para transformar o “uso da evolução para melhorar a evolução” de uma ideia teórica em um processo executável de alto rendimento: as tarefas internas rodam em lote e em paralelo, produzindo continuamente dados de desempenho, e a evolução externa usa esses dados como feedback para selecionar continuamente configurações de algoritmo melhores.
Cada camada com sua função
- Camada interna (execução e avaliação): executa em lote, na GPU, um grande número de configurações candidatas de algoritmo (diferentes hiperparâmetros, operadores ou estratégias de busca), realizando a execução e a pontuação em cada instância de tarefa. As tarefas têm granularidade fina e são numerosas, o que combina perfeitamente com a característica de rendimento em lote da GPU.
- Camada intermediária (agregação de feedback): agrega o desempenho bruto do grande volume de tarefas internas em indicadores estatísticos, estimando a qualidade de cada configuração em toda a distribuição de tarefas e formando a aptidão utilizada pela camada externa.
- Camada externa (seleção de configuração): usa o feedback estatístico como entrada para realizar seleção, mutação ou atualização, gerando a próxima geração de configurações e devolvendo-a à camada interna, fechando o ciclo.
Por que o paralelismo em GPU é insubstituível
Em um laço serial tradicional, o tempo de relógio de uma única rodada de iteração é determinado conjuntamente por “número de configurações candidatas × número de amostras de tarefas”; com um tamanho um pouco maior, ele já se torna insuportável, e o laço serial passa a ser o principal gargalo que limita a escala das configurações candidatas e das amostras de tarefas. O paralelismo em GPU permite que um grande número de algoritmos internos rode simultaneamente, reduzindo o laço serial de “principal gargalo” a “custo de processamento em lote aceitável”, ampliando ao mesmo tempo o espaço de configurações explorável e o volume de amostras de tarefas.
Mecanismo central: um ciclo fechado
Todo o sistema pode ser resumido como “rendimento paralelo das tarefas internas → agregação do feedback de desempenho → seleção de configurações na camada externa” : quanto maior o grau de paralelismo, mais abundantes são as amostras de feedback, mais estável é a estimativa de aptidão da camada externa e mais confiável é a direção de melhoria das configurações; as configurações aprimoradas são então devolvidas à camada inferior, entrando na próxima rodada de rendimento paralelo. É justamente esse ciclo fechado que confere aos algoritmos a capacidade de auto-otimização contínua e transforma o “uso da evolução para melhorar a evolução” de uma ideia teórica em um processo altamente eficiente e executável.
Arquitetura de rendimento da evolução em duas camadas com paralelismo em GPUA figura mostra um ciclo fechado: a camada interna executa em lote, na GPU, um grande número de configurações candidatas de algoritmo e conclui suas pontuações; a camada intermediária agrega o enorme volume de desempenho interno em indicadores estatísticos e forma a aptidão; com base nisso, a camada externa seleciona, muta e gera a próxima geração de configurações, devolvendo-a à camada interna. Quanto maior o grau de paralelismo, mais densas são as amostras de feedback e mais estável é a estimativa da camada externa sobre a qualidade das configurações, fazendo com que o gargalo da avaliação serial seja reduzido a um custo de processamento em lote aceitável.