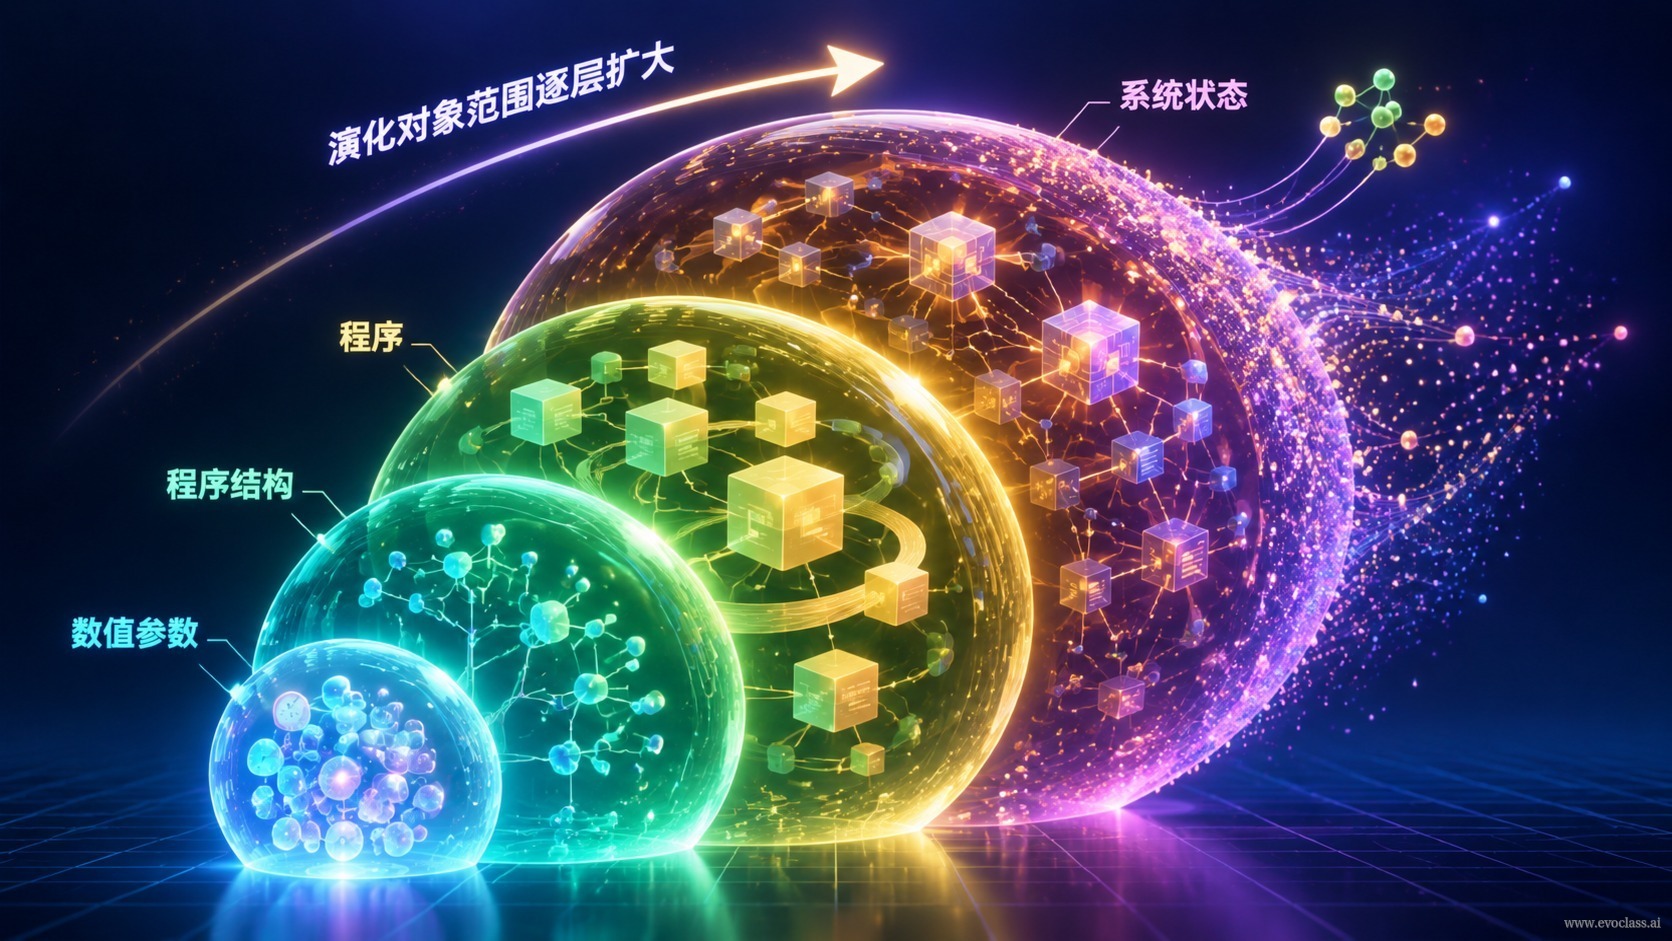
A computação evolutiva tradicional tem como objeto principal vetores de parâmetros numéricos de baixa dimensão e predefinidos, como hiperparâmetros, pesos e variáveis contínuas, cujo espaço de busca é delimitado por estruturas e codificações estabelecidas manualmente. Com a ampliação da escala computacional e da base de engenharia, a busca por objetos de alta dimensão, discretos e estruturados deixou de ser inviável e passou a ser tratável, expandindo-se o limite de busca em sincronia com o poder computacional e a cadeia de ferramentas.
Sobre essa base, os grandes modelos possuem capacidade de compreensão de código, raciocínio contextual e geração de candidatos, podendo construir, modificar e avaliar diretamente objetos em nível de programa, reduzindo a dependência de codificações e operadores de mutação projetados manualmente. Uma vez ampliada a escala de poder computacional, se o método de geração de candidatos permanecer fixado manualmente, o sistema apenas repetirá padrões preestabelecidos; incorporar o próprio método de geração de candidatos ao objeto de evolução (por exemplo, a estratégia de mutação e a configuração de parâmetros da evolução diferencial) é o reflexo direto dessa expansão de limites no plano metodológico.
A figura abaixo apresenta a estrutura dessa expansão em camadas.
Assim, os objetos de evolução apresentam uma expansão em camadas: parâmetros numéricos → estrutura do modelo → mecanismo do algoritmo → estado do programa e da engenharia de software. Quanto mais alta a camada, mais fortes as restrições semânticas e mais longa a cadeia de avaliação: os candidatos devem ser executáveis e verificáveis, e a avaliação de aptidão passa de uma função escalar para um julgamento conjunto de resultados de execução e restrições de engenharia. Essa expansão não substitui a otimização de parâmetros, mas a incorpora a um ciclo maior de evolução de programas e sistemas, formando um espectro contínuo que vai do ajuste local de parâmetros à melhoria em nível de sistema.
Diagrama em camadas da expansão dos objetos de evolução de parâmetros numéricos para sistemas de softwareA figura mostra, de baixo para cima, a expansão em camadas dos objetos de evolução: parâmetros numéricos, estrutura do modelo, mecanismo do algoritmo, até o estado do programa e da engenharia de software. Quanto mais alta a camada, mais fortes as restrições semânticas e mais longa a cadeia de avaliação; os candidatos devem ser executáveis e verificáveis, e a aptidão passa de uma função escalar para um julgamento conjunto de resultados de execução e restrições de engenharia, incorporando a otimização de parâmetros a um ciclo maior de evolução de programas.