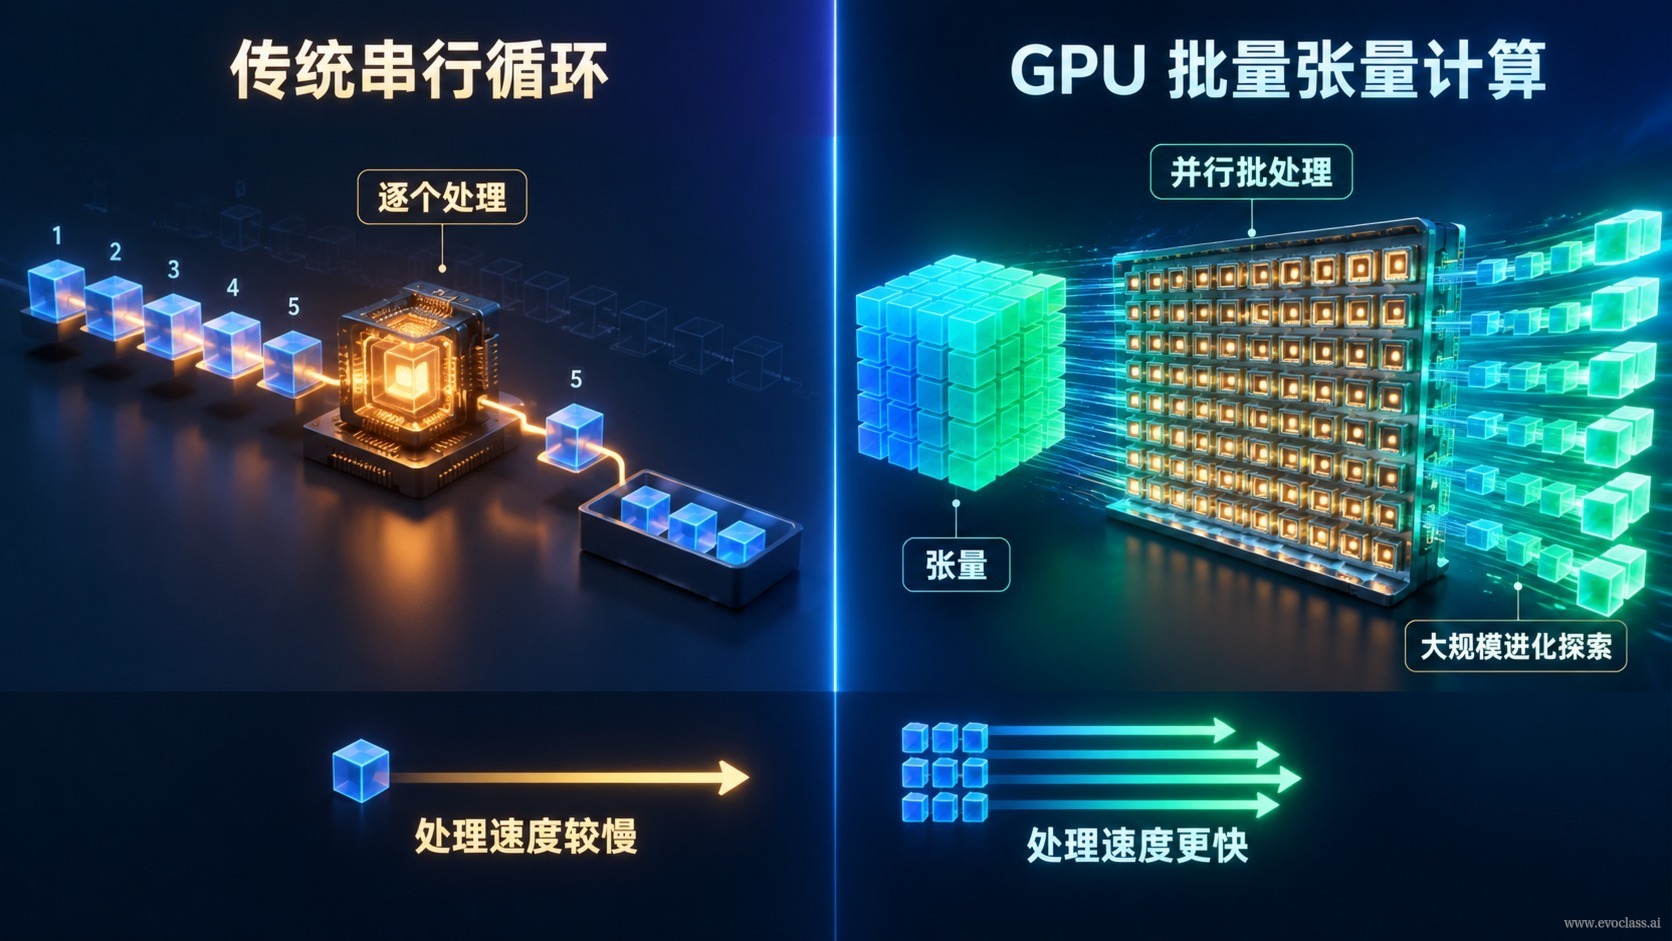
Quando o tamanho da população passa de algumas dezenas para milhares,a computação evolutivao verdadeiro gargalo deixa de ser "é possível encontrar boas soluções" e passa a ser "é possível avaliar candidatos suficientes dentro de um tempo limitado". A resposta de engenharia do EvoX são duas linhas principais que se sustentam mutuamente:a computação tensorialreescreve o loop serial indivíduo por indivíduo como operações tensoriais em lote,a arquitetura unificadadesacopla algoritmos, problemas, fluxos de trabalho e o agendamento do Runtime, permitindo que esse mecanismo paralelo seja reutilizado em diferentes algoritmos evolutivos e tarefas.
Por que a diversidade exige throughput
A busca evolutiva depende da diversidade da população: quanto mais dispersos os candidatos, maior a probabilidade de escapar de ótimos locais. Mas "manter a diversidade" é, na essência, uma questão de poder computacional — exige que cada geração consiga avaliar e atualizar o estado de um grande número de candidatos. Se o método de geração de candidatos continuar fixado manualmente e a avaliação continuar sendo feita indivíduo por indivíduo, o sistema ficará preso a sempre repetir o mesmo padrão, e os ganhos da diversidade serão anulados pelo gargalo de throughput computacional.
Evolução de métodos: colocar o "método que gera candidatos" também sob evolução
Quando a escala de poder computacional se abre, o EvoX eleva o objeto de otimização em um nível: em vez de apenas resolver o problema, coloca o próprio método que gera soluções candidatas como objeto de evolução — é aevolução de métodos. Tomando o MetaDE como exemplo, o algoritmo interno resolve tarefas reais, enquanto o algoritmo externo evolui as configurações e estratégias do algoritmo interno (por exemplo, as estratégias de mutação e hiperparâmetros da evolução diferencial), executando em paralelo na GPU um grande número de tarefas internas, com o desempenho dessas tarefas orientando a escolha das configurações externas;AutoPSO e EvoGO vão além, combinando componentes de enxame de partículas e usando feedback histórico para aprender a forma de gerar candidatos, dando o salto de "mudar parâmetros" para "mudar a estrutura do algoritmo". Essa evolução em dois níveis, interno e externo, exige naturalmente que uma grande quantidade de tarefas internas seja avaliada e atualizada em lote na mesma geração — ou até no mesmo instante —, impondo exigências ainda maiores de throughput computacional e capacidade de paralelismo.
Grafo de computação tensorial: substituir loops por tensores em lote
O loop serial tradicional na CPU costuma executar "avaliar — registrar — atualizar" indivíduo por indivíduo, disparando apenas operadores de pequena escala a cada vez, o que gera três tipos de custo:alto custo de agendamento,fragmentação de operadores,baixa utilização da GPU. A abordagem do grafo de computação tensorial é organizara manutenção da população, a avaliação em lote e a atualização de estadocomo um todo em operações tensoriais em lote, fazendo com que candidatos da mesma geração — ou até de várias gerações — sejam calculados em paralelo. Por exemplo: quando uma geração contém N soluções candidatas, a implementação serial faz um loop indivíduo por indivíduo, enquanto a implementação tensorial organiza a população em um único tensor, realizando de uma só vez a avaliação em lote e a atualização de estado paralela, reduzindo significativamente o custo de agendamento e elevando a taxa de ocupação da GPU.
Arquitetura unificada: tornar o mecanismo paralelo reutilizável
Apenas reescrever loops como tensores não basta — se algoritmo, problema e lógica de agendamento estiverem acoplados entre si, trocar de algoritmo evolutivo ou de tipo de tarefa exigirá reescrever tudo. A arquitetura unificada, ao desacoplaralgoritmo, problema, fluxo de trabalho e agendamento do Runtimee outros módulos, permite que o mecanismo paralelo tensorial seja reutilizado em diferentes algoritmos evolutivos e tarefas (como os cenários de evolução de métodos MetaDE e AutoPSO); combinada com oagendamento de poder computacional heterogêneo, possibilita o gerenciamento em nível de tarefas em lote de recursos como CPU e GPU, sustentando uma exploração paralela componível e escalável.
Por que esta é uma capacidade de nível "base"
A base de engenharia trazida pela GPU e pelos grandes modelos faz com que a computação tensorial em lote deixe de ser uma otimização local e se torne uma capacidade fundamental que sustenta a exploração evolutiva em nível de sistema. Em outras palavras, a computação tensorial resolve o "rodar rápido", enquanto a arquitetura unificada, aberta e desacoplada resolve o "trocar sem dificuldade": a primeira oferece throughput, a segunda oferece fronteiras de reutilização componíveis e escaláveis. Só a combinação das duas faz com que a exploração evolutiva paralela, de alta intensidade e alta diversidade, se torne de fato uma capacidade de engenharia.
Comparação entre o loop serial e a arquitetura de computação tensorial em lote na GPUÀ esquerda, o loop serial tradicional na CPU executa "avaliar — registrar — atualizar" indivíduo por indivíduo, disparando apenas operadores de pequena escala, o que gera alto custo de agendamento, fragmentação de operadores e baixa utilização da GPU; à direita, a manutenção da população, a avaliação em lote e a atualização de estado são organizadas como um todo em operações tensoriais, realizando de uma só vez o cálculo de candidatos da mesma geração ou até de várias gerações e desacoplando-se do agendamento do Runtime, de modo que o mecanismo paralelo possa ser reutilizado em diferentes algoritmos e tarefas.