Эволюционный процесс опирается на разнообразие популяции, а разнообразие означает многократный рост размера популяции и числа оценок. Когда число оценок кандидатов достигает десятков тысяч,традиционный последовательный цикл CPU就成了整条流水线上最窄的一段:它一次只处理一个个体,硬件的并行能力几乎被闲置。
По одной за раз: модель выполнения последовательного цикла
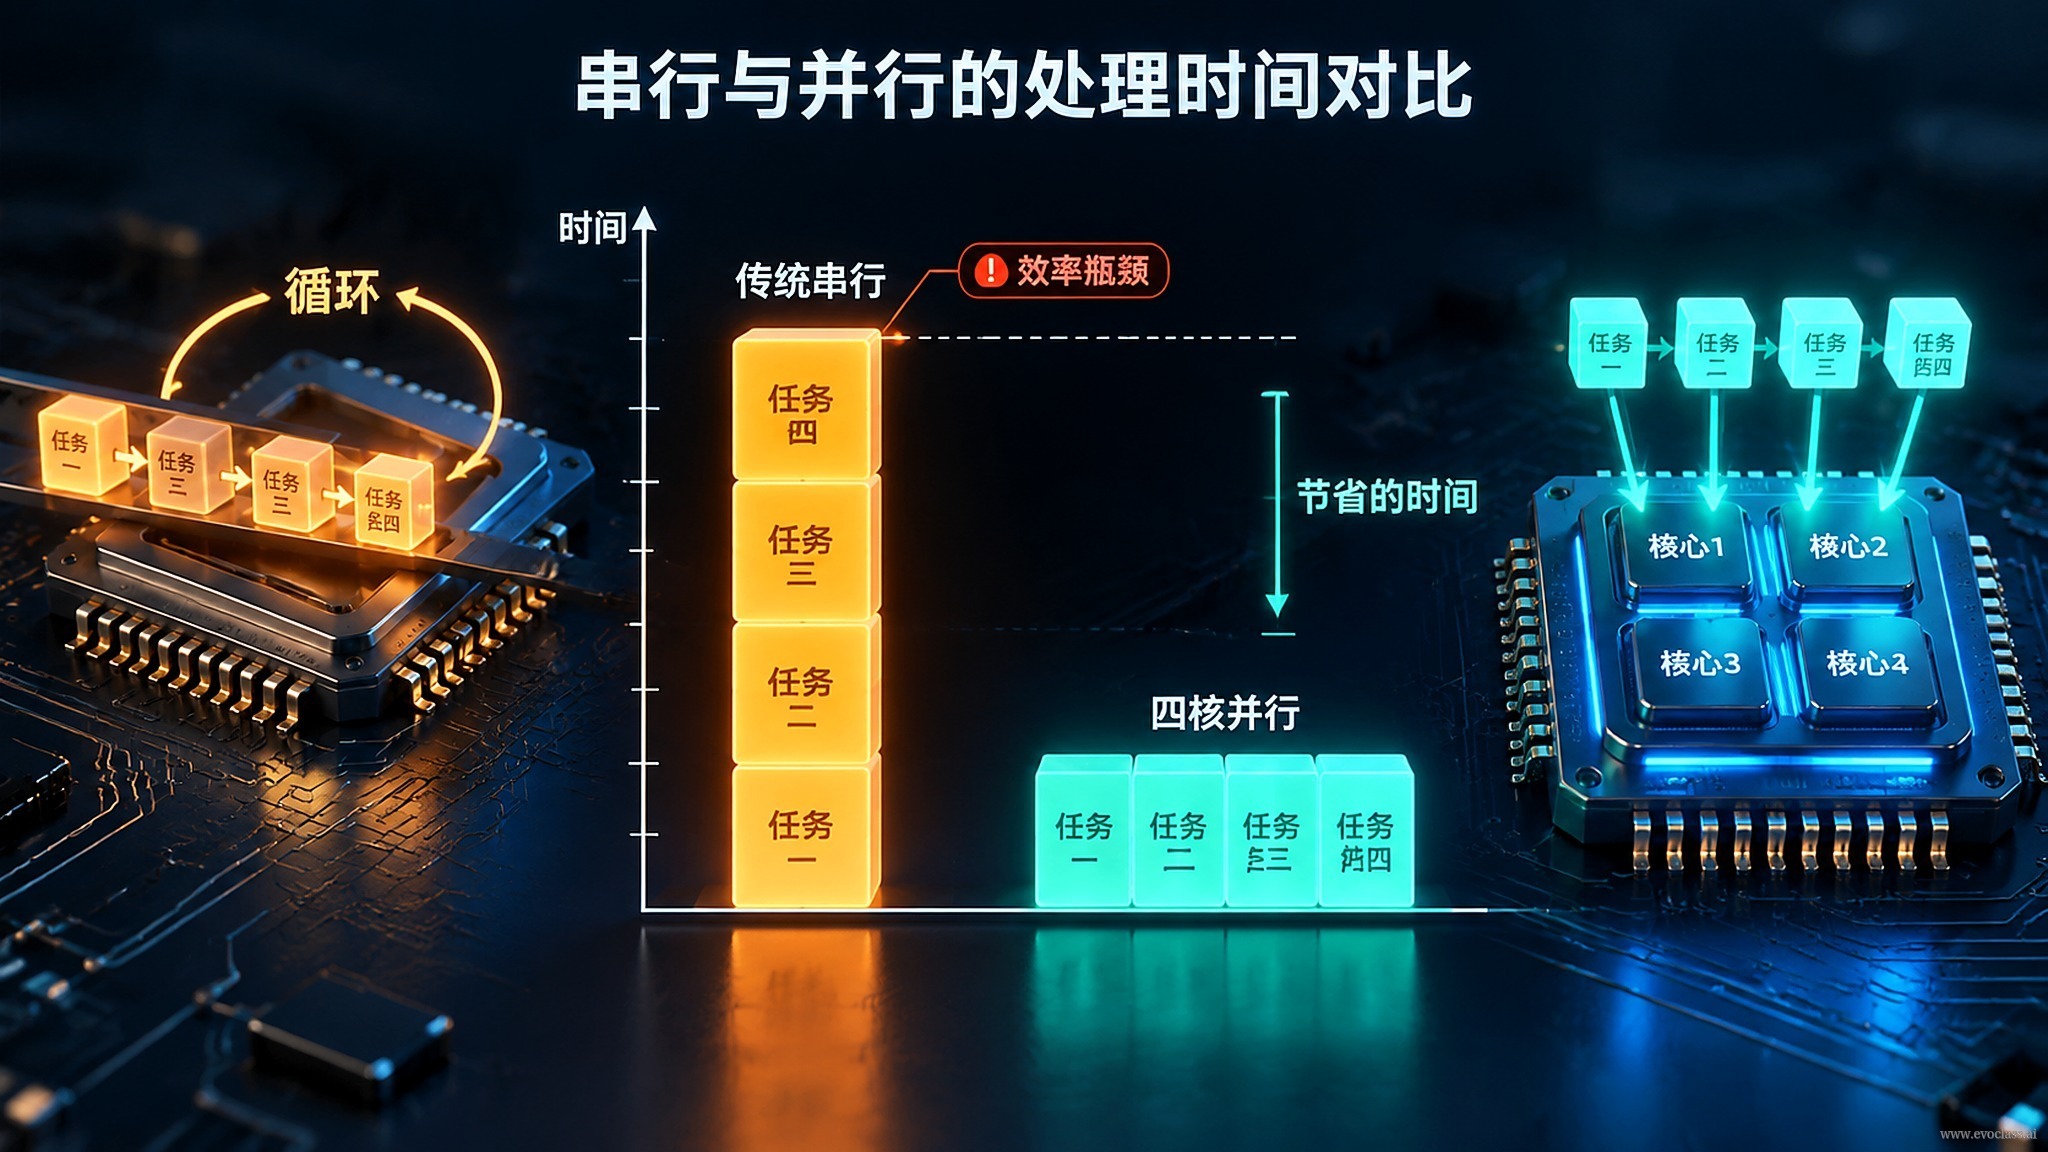
Самая простая реализация рассматривает всю популяцию как список и в цикле поочерёдно извлекает особей: взять особь → декодировать в конкретные параметры → вызвать функцию оценки → записать приспособленность обратно. Соседние итерации почти не перекрываются: пока результат оценки не вернулся, запись не может продвинуться; пока запись не завершена, следующей особи некуда поместить результат. В итоге многоядерные, SIMD- и GPU-блоки большую часть времени простаивают, наблюдая, как одна особь проходит конвейер до конца.
Откуда же берутся накладные расходы
- Линейно растущее число оценок: общее число оценок примерно равно размеру популяции × числу поколений; при достижении порядка 10⁵ время последовательного выполнения по часам растёт почти линейно.
- Поштучное выполнение на уровне интерпретатора: поочерёдный цикл по особям, проверка границ и диспетчеризация типов дают фиксированные, но высокие постоянные накладные расходы.
- Несогласованный доступ к памяти и пересылка данных: извлекаемые по одной особи часто расположены в памяти несогласованно, доля попаданий в кэш низкая, а затраты на пересылку оплачиваются снова и снова.
- Синхронизация и планирование: чтобы получить следующую особь, поток выполнения вынужден снова и снова останавливаться и возобновляться.
Переводим масштаб во время
Возьмём популяцию из 1000 особей и 100 поколений — всего около 100 тысяч оценок кандидатов. Если одна оценка занимает в среднем 1 мс, только этап оценки последовательно потребует около 100 секунд, не считая затрат на вычисления операторов и планирование; если для поддержания разнообразия увеличить число перезапусков с 1 до 5, затраты почти линейно вырастут до примерно 500 секунд. Если тот же объём работы организовать по пакетам и передать параллельной аппаратуре, время по часам будет определяться главным образом числом пакетов, а не числом особей.
Когда это узкое место сужается
Граничные условия не менее важны: когда одна оценка крайне дешева (микросекунды) или популяция очень мала (порядка сотен), накладные расходы на планирование и память могут превысить вычислительные, разрыв между последовательным и параллельным выполнением заметно сокращается, предельная отдача от тензоризации падает, а узкое место смещается к гранулярности планирования и пропускной способности памяти. Поэтому целесообразность переработки модели выполнения нужно оценивать совместно с учётом стоимости оценки и масштаба.
Сравнение времени последовательного и параллельного выполненияВозьмём популяцию 1000 особей и 100 поколений — всего около 100 тысяч оценок кандидатов; при 1 мс на оценку последовательно только этап оценки займёт около 100 секунд, а при 5 перезапусках почти линейно вырастет примерно до 500 секунд. После перехода к пакетной организации и передачи параллельной аппаратуре время по часам определяется главным образом числом пакетов, а не числом особей.