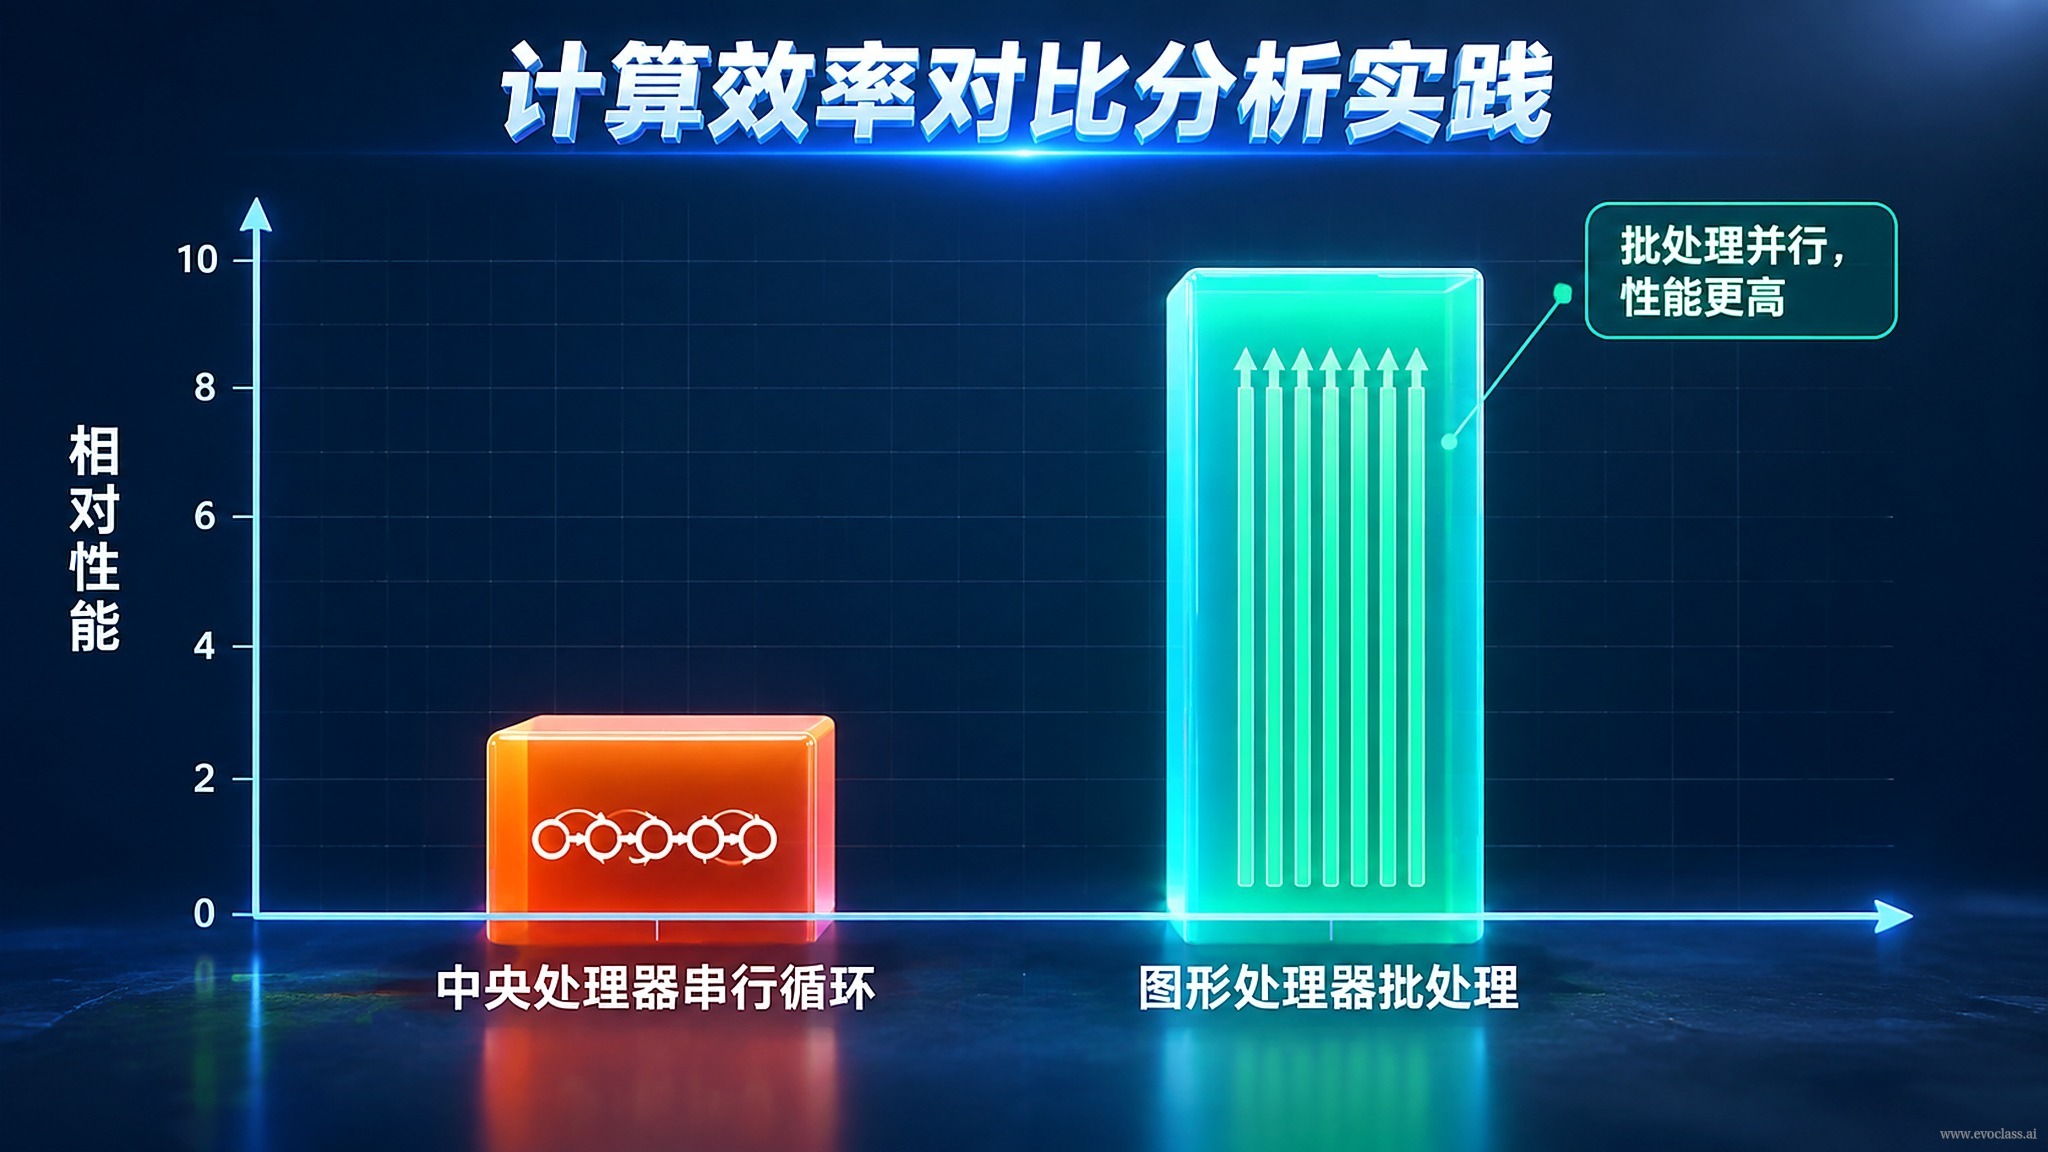
На этой странице «сравнение вычислительной эффективности» превращается в воспроизводимый практический эксперимент:на одной и той же эволюционной задаче сравнивается сквозная эффективность традиционного последовательного перебора особей на CPU и тензорной пакетной обработки EvoX на GPU. Цель — не запомнить вывод «GPU быстрее», а понять, откуда именно берётся ускорение от тензорного параллелизма, какова его цена и где проходят границы применимости.
Две базовые линии, одна задача
- Последовательная базовая линия на CPU: в цикле по одному вызывается функция оценки для каждой особи; каждое поколение требует N независимых вызовов, обновлений состояния и сбора результатов. Управление циклом, накладные расходы интерпретатора и разрозненные обращения к памяти размывают эффективную вычислительную мощность — чем больше особей, тем выше доля этих «невычислительных» затрат.
- Тензорная реализация на GPU для сравнения: EvoX организует популяцию, входные данные оценки и состояние выполнения в виде тензоров и выполняет оценку и операторы пакетно на GPU, охватывая весь набор кандидатов одним вызовом, что радикально сокращает число последовательных циклов и переключений.
Протокол измерений: как сделать сравнение воспроизводимым
Воспроизводимое сравнение требуетфиксировать задачу, размер популяции, число поколений и случайное зерно, после чего фиксировать: реальное время на поколение, общее время, пропускную способность (оценок/с), ускорение, а также загрузку GPU и объём видеопамяти. Перед замером необходимпрогрев, чтобы исключить влияние первой компиляции и выделения видеопамяти, а в точках замера выполнятьсинхронизацию устройства, а также учитывать время вычислений и время передачи данных между хостом и устройством раздельно. Без любого из этих шагов полученное ускорение может оказаться недостоверным.
Откуда берётся разница и чем она ограничена
- Источники выгоды: пакетный параллелизм, тензорные операторы и внутриустройственный параллелизм позволяют обрабатывать весь набор кандидатов за один вызов, выполняя больше оценок в единицу времени.
- Ограничения: на итоговое ускорение влияют размер пакета, размерность задачи, степень векторизуемости функции оценки, затраты на копирование между хостом и устройством и затраты на запуск ядер. При слишком малом пакете выгоду съедают затраты на запуск; если функция оценки не векторизуется, пакетная обработка почти не даёт эффекта.
Практический вывод
Правильная последовательность действий такова:сначала убедитесь, что функция оценки поддаётся пакетированию, и лишь затем сравнивайте реализации на CPU и GPU. Преимущество в эффективности в конечном счёте должно выражаться в том, что «при том же вычислительном бюджете удаётся выполнить больше поколений или оценить больше вариантов-кандидатов», и именно на этом основании следует выбирать способ развёртывания и схему эксперимента, а не гнаться за красивой цифрой ускорения.
Сравнение эффективности последовательной обработки на CPU и пакетной на GPUВ сравнении последовательная базовая линия на CPU оценивает особей по одной в цикле, и каждое поколение требует N переключений и обновлений состояния, а накладные расходы интерпретатора и обращений к памяти размывают эффективную вычислительную мощность; пакетная обработка на GPU организует популяцию и входные данные оценки в виде тензоров, охватывая весь набор кандидатов одним вызовом. Ускорение ограничено размером пакета, степенью векторизуемости функции оценки и затратами на копирование между хостом и устройством.