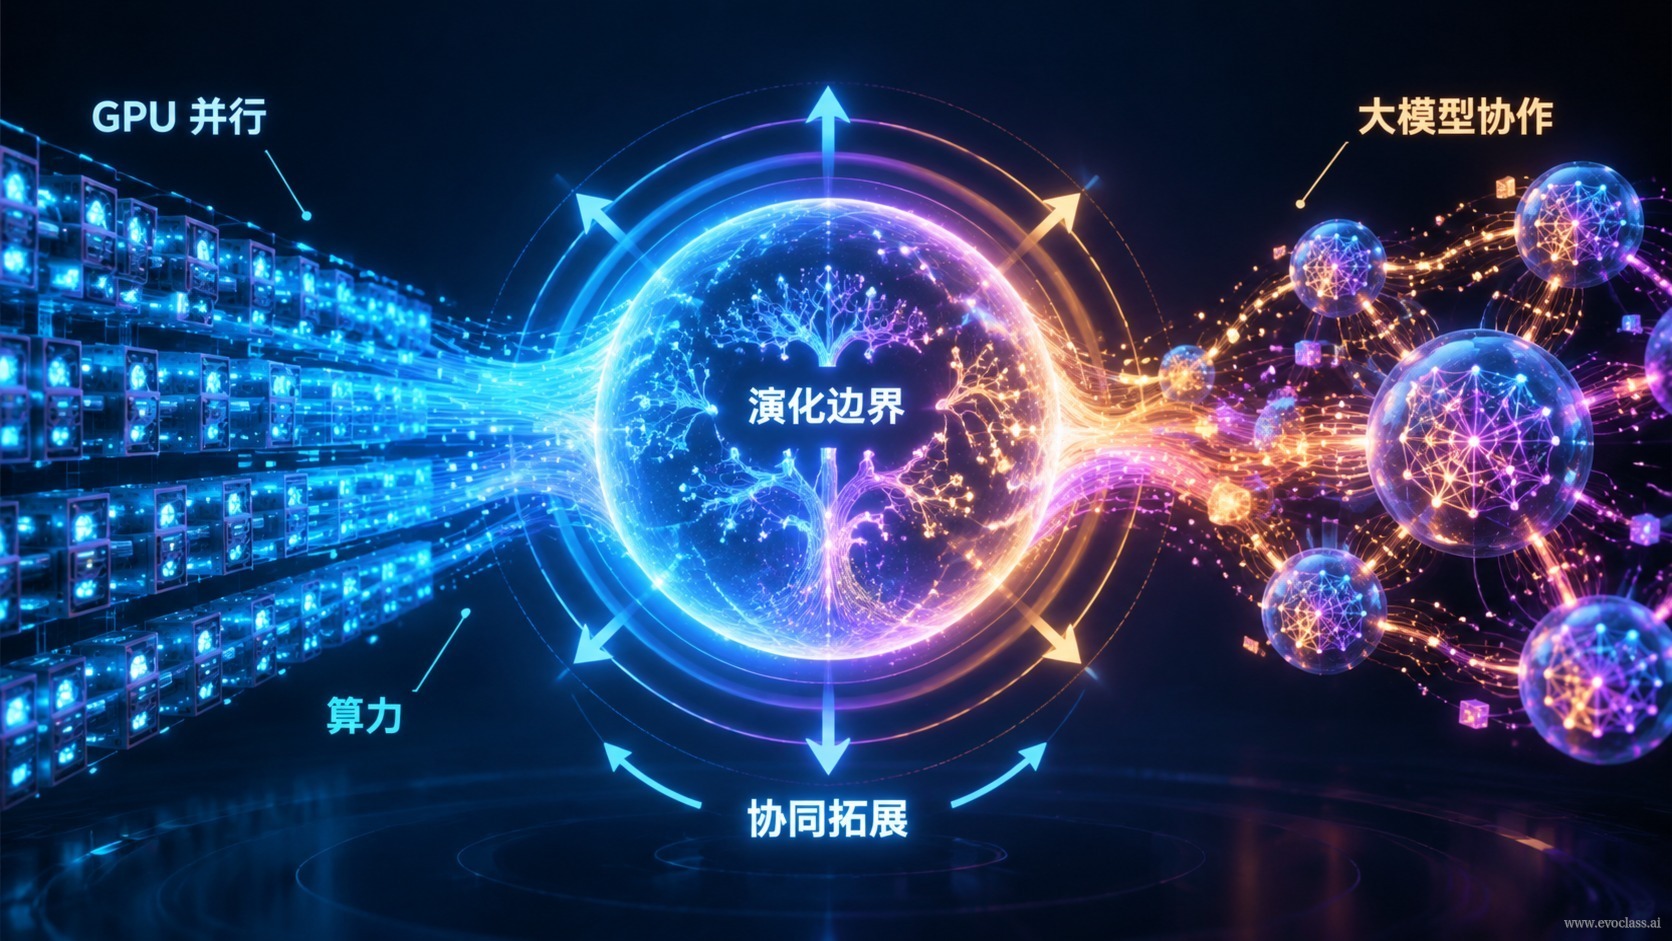
Эволюционные вычисления долго были скованы одной практической проблемой: сколько кандидатов вообще можно оценить за отведённое время. Сегодня это ограничение ослабляется сразу двумя инженерными силами —параллельные вычисления на GPUисемантическая генерация большими моделями. Вместе они образуют двойной инженерный фундамент эволюционных вычислений:вычислительная мощность определяет, «сколько кандидатов можно исследовать за раз», а большая модель — «кандидатов какой формы можно исследовать», и вдвоём они расширяют границы объекта эволюции от числовых параметров до программ, архитектур моделей и самих алгоритмических механизмов.
Вычислительный фундамент: перенос пространства кандидатов из последовательного режима в тензорный
В традиционной реализации оценка популяции — это последовательный цикл на CPU: за раз обрабатывается лишь одна особь, а накладные расходы на планирование накапливаются с ростом популяции. Открытые платформы вроде EvoX унифицированно организуют кандидатов, результаты оценки и состояние алгоритма в видетензоров, вычислимых целиком: мутация применяется ко всей популяции, а оценка и обновление состояния вместе с отбором попадают в вычислительный граф и подвергаются компиляционной оптимизации. Прямой инженерный результат — «одновременное исследование десятков тысяч кандидатов» превращается из лабораторного приёма в рутинную практику.
Такие платформы разделяют систему на алгоритмы, проблемные модули, рабочие процессы и Runtime-планировщик: исследователю достаточно сосредоточиться на том, «как эволюционировать», а Runtime берёт на себя распределение пакетных вычислений между GPU, ускорителями или распределённым кластером. Важно понимать: вычислительная мощность решает задачупропускной способности, а не «сообразительности». Она не судит, хорош ли кандидат, а лишь рассчитывает приспособленность всей популяции за один проход. Этобазовая опорарасширения пространства кандидатов, но она не решает, как эти кандидаты выглядят.
Семантический фундамент: подъём формы кандидатов от числовых векторов до структурных решений
Вклад больших моделей не в том, что они считают быстрее, а в том, что они понимают код, предметные знания и контекст задачи, обладаяспособностью к семантической генерации. Поэтому они способны конструировать структурно сложных кандидатов — фрагмент решающего кода, готовый к непосредственному вызову, или топологию суррогатной модели, — а не просто выдавать числовой вектор. Так открывается пространство «форм» кандидатов.
Трёхуровневое расширение границ объекта эволюции
- Числовые параметры: классическая постановка, где особь популяции — это набор значений параметров при фиксированной структуре.
- Программа / архитектура модели: особь популяции становится исполняемым фрагментом кода или топологией сети и суррогатной модели. Генеративная способность больших моделей — как раз вход на этот уровень.
- Алгоритмический механизм: сам процесс «как генерировать и как оценивать» тоже становится объектом эволюции. Именно это — предпосылка последующих подходов «улучшения эволюции эволюцией» (например, MetaDE, AutoPSO).
Возьмём оптимизацию профиля крыла: традиционный подход позволял искать лишь по нескольким заранее заданным числовым параметрам; когда большая модель может читать и писать решающий код, конструировать архитектуру суррогатной модели, а GPU способен параллельно оценивать целую популяцию пакетами, объект поиска поднимается с «набора значений параметров» до «самого комплекса генерации и оценки».
Взаимодополнение, а не замена
Это отношения взаимодополнения: вычислительная мощность расширяетШиротапоиска, а большая модель повышаеткачество и сложность формы кандидатов; без любой из сторон расширение границ невозможно. С одной лишь вычислительной мощностью, но без семантической генерации объект поиска остаётся заперт в жёстко заданном кодировании; с одной лишь генеративной способностью, но без пакетной оценки, огромное множество кандидатов невозможно отобрать за приемлемое время.
Цена расширения границ
Расширение границ привносит и новые ограничения: во-первых,растёт стоимость оценки— единичная оценка может превратиться из миллисекунд в минуты; во-вторых,усложняется проверка корректности— сгенерированный код может не компилироваться или не удовлетворять физическим и инженерным ограничениям; в-третьих,размывается критерий «пригодного ответа», и требуется сопряжение с многокритериальным балансом, экспертными решениями и другими этапами.
Схема расширения границ эволюции при совместной работе параллельных GPU и больших моделейСхема показывает, что расширение границ эволюции опирается на двойной фундамент: GPU и тензоризованный Runtime переносят оценку популяции из последовательного цикла в пакетный параллелизм и определяют, сколько кандидатов можно исследовать за раз; большая модель обеспечивает семантическую генерацию и определяет, какой формы кандидатов можно конструировать. После их объединения объект эволюции может расшириться от числовых параметров до программы/архитектуры модели, а затем и до алгоритмического механизма, но это приносит и новые ограничения: стоимость оценки, проверку корректности и критерии判定 пригодного ответа.