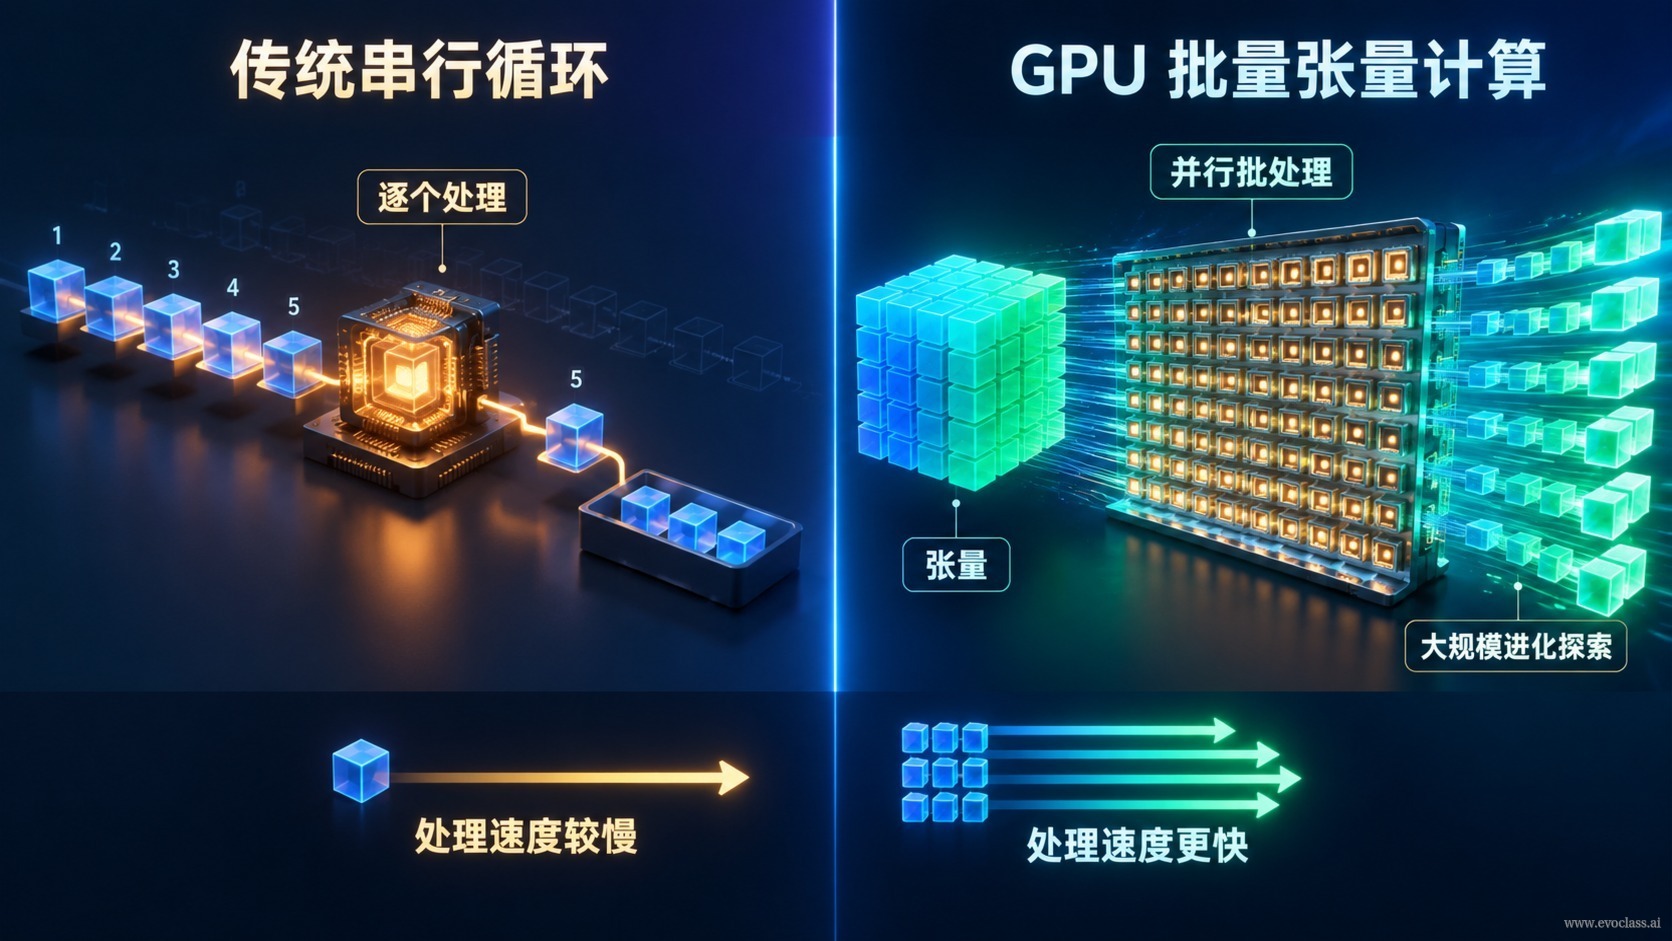
Когда размер популяции растёт с десятков до тысяч,эволюционные вычисленияуже упираются не в вопрос «можно ли найти хорошее решение», а в вопрос «можно ли за ограниченное время оценить достаточно много кандидатов». EvoX предлагает инженерный ответ в виде двух взаимодополняющих линий:тензорные вычисленияпереписывают последовательный цикл по отдельным особям в пакетные тензорные операции,унифицированная архитектураразвязывает алгоритм, задачу, рабочий процесс и Runtime-планирование, благодаря чему этот механизм параллелизма можно переиспользовать в разных эволюционных алгоритмах и задачах.
Почему разнообразие требует пропускной способности
Эволюционный поиск опирается на разнообразие популяции: чем более разбросаны кандидаты, тем выше вероятность выйти из локального оптимума. Но «поддержание разнообразия» по сути является задачей о вычислительной мощности — оно требует, чтобы в каждом поколении выполнялась оценка и обновление состояния большого числа кандидатов. Если способы порождения кандидатов по-прежнему жёстко заданы человеком, а оценка по-прежнему выполняется по одной особи за раз, система будет лишь повторять заложенную схему, и выгода от разнообразия будет нивелирована узким местом вычислительной пропускной способности.
Эволюция методов: включаем в эволюцию и «метод порождения кандидатов»
Когда масштаб вычислительных ресурсов раскрывается, EvoX поднимает объект оптимизации на уровень выше: теперь эволюционирует не только решение задачи, но и сам метод порождения кандидатов — это и естьэволюция методов. На примере MetaDE внутренний алгоритм решает практические задачи, а внешний эволюционирует конфигурацию и стратегию внутреннего алгоритма (например, стратегию мутации и гиперпараметры дифференциальной эволюции) и параллельно запускает на GPU множество внутренних задач, так что их результаты, в свою очередь, направляют выбор конфигурации внешнего уровня;AutoPSO а AutoPSO и EvoGO идут дальше: комбинируя компоненты роя частиц и используя историческую обратную связь для обучения способу порождения кандидатов, они совершают переход от «изменения параметров» к «изменению структуры алгоритма». Такая двухуровневая эволюция — внутренняя и внешняя — естественно требует, чтобы в одном поколении и даже в один момент времени множество внутренних задач массово оценивались и обновлялись, что предъявляет более высокие требования к вычислительной пропускной способности и возможностям параллелизма.
Тензорный вычислительный граф: заменяем цикл пакетными тензорами
Традиционный последовательный цикл на CPU обычно выполняет для каждой особи «оценку — запись — обновление», каждый раз запуская лишь мелкомасштабные операторы, что влечёт три вида издержек:высокие накладные расходы на планирование,фрагментация операторов,недостаточная загрузка GPU. Тензорный вычислительный граф подходит к этому так: он объединяетподдержание популяции, пакетную оценку и обновление состоянияв единые пакетные тензорные операции, позволяя вычислять параллельно кандидатов одного и даже нескольких поколений. Например: когда одно поколение содержит N кандидатных решений, последовательная реализация перебирает их по одной особи, а тензорная реализация организует популяцию в один тензор и за один проход выполняет пакетную оценку и параллельное обновление состояния, что заметно снижает накладные расходы на планирование и повышает загрузку GPU.
Унифицированная архитектура: делаем механизм параллелизма переиспользуемым
Просто переписать цикл в тензоры недостаточно — если алгоритм, задача и логика планирования связаны друг с другом, то при смене эволюционного алгоритма или типа задачи всё придётся писать заново. Унифицированная архитектура, развязываяалгоритм, задачу, рабочий процесс и Runtime-планированиеи другие модули, позволяет переиспользовать механизм тензорного параллелизма в разных эволюционных алгоритмах и задачах (например, в сценариях эволюции методов, таких как MetaDE и AutoPSO); вместе спланированием гетерогенных вычислительных ресурсовэто даёт управление ресурсами CPU, GPU и других на уровне пакетных задач, поддерживая композируемый и масштабируемый параллельный поиск.
Почему это способность уровня «основы»
Инженерная основа, которую дают GPU и большие модели, поднимает тензорные пакетные вычисления от локальной оптимизации до базовой способности, поддерживающей эволюционный поиск на уровне системы. Иными словами, тензоризация решает задачу «работать быстро», а открытая развязанная унифицированная архитектура — задачу «легко заменяться»: первая обеспечивает пропускную способность, вторая — композируемые и масштабируемые границы переиспользования. Лишь вместе они превращают интенсивный, высокоразнообразный параллельный эволюционный поиск в реальную инженерную возможность.
Сравнение архитектур: последовательный цикл и пакетные тензорные вычисления на GPUСлева традиционный последовательный CPU-подход выполняет «оценку — запись — обновление» по отдельным особям, запуская лишь мелкомасштабные операторы, что ведёт к высоким накладным расходам на планирование, фрагментации операторов и недостаточной загрузке GPU; справа поддержание популяции, пакетная оценка и обновление состояния объединены в тензорные операции, за один проход вычисляются кандидаты одного и даже нескольких поколений, а механизм развязан с Runtime-планированием, что позволяет переиспользовать параллелизм в разных алгоритмах и задачах.