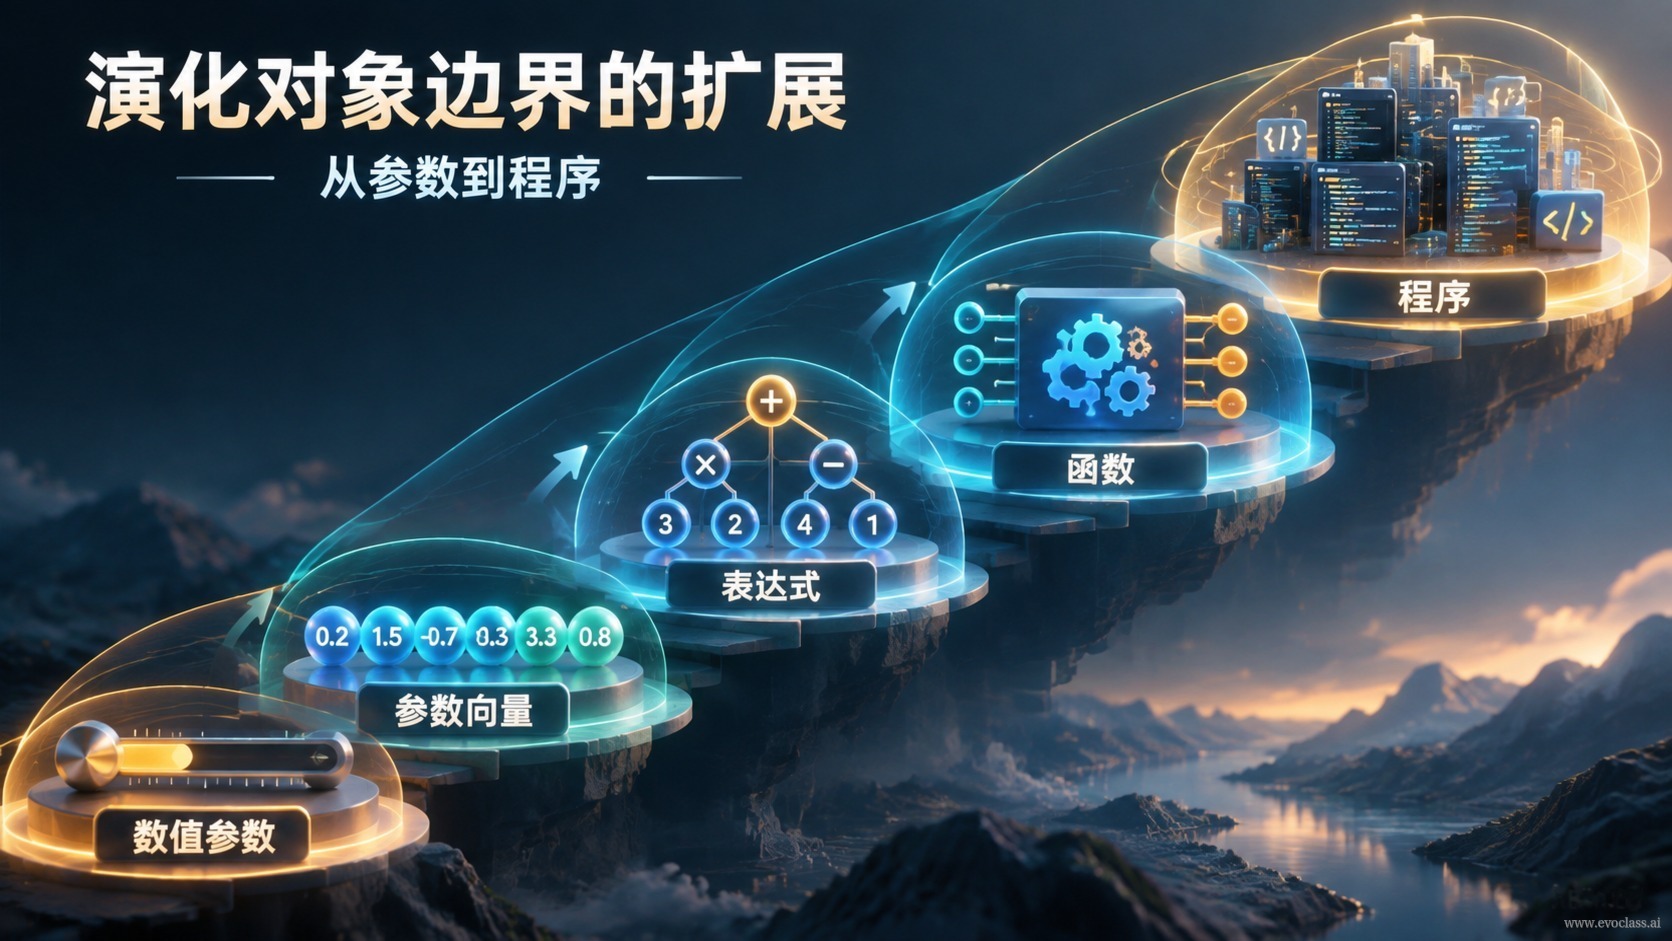
วัตถุวิวัฒนาการหมายถึงส่วนของเนื้อหาในระบบวิวัฒนาการที่ถูกเข้ารหัส กลายพันธุ์ ประเมิน และคัดเลือกจริง อัลกอริทึมวิวัฒนาการแบบคลาสสิกถือว่าวัตถุนี้เป็นเพียงชุดพารามิเตอร์เชิงตัวเลข แต่บนฐานรากสมัยใหม่ที่เกิดจาก GPU และโมเดลขนาดใหญ่ร่วมกัน ขอบเขตนี้กำลังขยายออกไป: จากพารามิเตอร์เชิงตัวเลข ไปสู่ไฮเปอร์พารามิเตอร์และโครงสร้างโมเดล ต่อไปยังกลไกอัลกอริทึมและตัวดำเนินการ และสุดท้ายไปสู่โปรแกรมและสถานะวิศวกรรมซอฟต์แวร์ที่ดำเนินอยู่ต่อเนื่อง
กุญแจสำคัญในการเข้าใจบันไดขั้นนี้ คือการจับสามสิ่งพร้อมกัน: วัตถุถูกแสดงอย่างไรอยู่ภายใต้ข้อจำกัดใดและใช้สัญญาณใดในการประเมินเมื่อวัตถุเลื่อนขึ้นหนึ่งชั้น ทั้งสามสิ่งนี้จะเปลี่ยนแปลงไปพร้อมกัน
- ชั้นพารามิเตอร์เชิงตัวเลข: วัตถุคือเวกเตอร์จำนวนจริงต่อเนื่อง θ \in \mathbb{R}^dเช่น อัตราการเรียนรู้ น้ำหนัก หรือปัจจัยการกลายพันธุ์ของ Differential Evolution ข้อจำกัดหลักคือช่วงค่าที่อนุญาต การประเมินมักเป็นเป้าหมายสเกลาร์เดียว f(θ)。
- ชั้นไฮเปอร์พารามิเตอร์และโครงสร้างโมเดล: วัตถุประกอบด้วยตัวเลือกแบบไม่ต่อเนื่อง เช่น จำนวนชั้น ความกว้าง วิธีการเชื่อมต่อ และกลยุทธ์การเพิ่มข้อมูล พื้นที่การค้นหากลายเป็นแบบผสมและขยายตัวแบบเชิง組合อย่างรวดเร็ว การประเมินต้องให้ความสำคัญเพิ่มเติมกับความสามารถในการวางนัยทั่วไปและการโอเวอร์ฟิต
- ชั้นกลไกอัลกอริทึมและตัวดำเนินการ: วัตถุเองคือกลไกที่จะถูกนำไปดำเนินการ เช่น กลยุทธ์การกลายพันธุ์ของ Differential Evolution วิธีการ组合ค่าสัมประสิทธิ์ความเฉื่อยใน Particle Swarm รูปแบบเฉพาะของฟังก์ชันขาดทุน ผู้สมัครต้องเป็นไปตามข้อจำกัดทางไวยากรณ์และความหมาย การประเมินเปลี่ยนจาก "ใครได้คะแนนสูงกว่า" ไปสู่ความทนทาน ความเสถียร และการ权衡หลายเป้าหมาย
- ชั้นโปรแกรมและสถานะวิศวกรรม: วัตถุกลายเป็นสคริปต์การฝึก การตั้งค่าไปป์ไลน์ ความสัมพันธ์ของ dependencies และสถานะโปรเจกต์ ผู้สมัครจะถือว่าใช้ได้ก็ต่อเมื่อผ่านการคอมไพล์ การทดสอบ และการตรวจรับ การประเมินยกระดับเป็นผลตอบกลับระดับระบบ: ความแม่นยำเพิ่มขึ้นเท่าใด ต้นทุนทรัพยากรยอมรับได้หรือไม่ ผลลัพธ์ทำซ้ำได้หรือไม่
ทำไมขอบเขตจึงขยายออกไป
มีสองพลังผลักดันร่วมกัน ประการแรก ขนาดของพลังประมวลผลเปิดความเป็นไปได้ของการสำรวจแบบขนาน: ลูปแบบอนุกรมที่เคยเขียนขึ้นรอบผู้สมัครรายตัว ถูกแทนที่ด้วยการทำ tensorization และการขนานแบบเป็นชุด ประชากรทั้งหมดสามารถสร้างขึ้นและประเมินได้ในครั้งเดียว ประการที่สอง โมเดลขนาดใหญ่สามารถเข้าใจภาษาธรรมชาติ โค้ด และบริบทของโดเมน ทำให้ระบบสามารถสร้างผู้สมัครที่มีโครงสร้างซับซ้อนได้——วิธีการเข้ารหัสและการกลายพันธุ์ที่เคยต้องออกแบบด้วยมือ บัดนี้โมเดลสามารถมีส่วนร่วมในการสร้างได้
เมื่อ "วิธีการสร้างผู้สมัคร" เองก็สามารถถูกแสดงและประเมินได้ คำถามธรรมชาติก็เกิดขึ้น: ในเมื่อคำตอบผู้สมัครสามารถถูกวิวัฒน์ได้ แล้ววิธีการสร้างคำตอบผู้สมัครก็สามารถเป็นวัตถุวิวัฒนาการได้เช่นกันหรือไม่? นี่คือบันไดขั้นนั้นที่ก้าวจาก "การหาคำตอบที่ดีที่สุด" ไปสู่ "การหาอัลกอริทึมที่ดีที่สุดในตัวเอง"
สัญญาณการประเมินต้องยกระดับไปพร้อมกับวัตถุ
ในชั้นพารามิเตอร์ เป้าหมายสเกลาร์เดียวก็เพียงพอที่จะขับเคลื่อนการค้นหา เช่น \min f(θ)แต่เมื่อถึงชั้นโปรแกรม ไม่มีสเกลาร์ใดที่จะสรุปได้ว่า "โค้ด這段นี้ควรค่าแก่การเก็บไว้หรือไม่": การประเมินกลายเป็นการ权衡หลายเป้าหมายภายใต้ข้อจำกัด ต้องพิจารณาความแม่นยำพร้อมกัน f1ต้นทุนการประเมิน f2 และความเสถียร f3และภายใต้ข้อจำกัด C(x) ≤ 0 เพื่อค้นหากลุ่มผู้สมัครที่ไม่ถูกครอบงำซึ่งกันและกัน รายการตรวจสอบที่ใช้กันทั่วไปในงานวิศวกรรมประกอบด้วย: การคอมไพล์ผ่านหรือไม่ การทดสอบครอบคลุมหรือไม่ ค่ามาตรฐานดีขึ้นหรือไม่ ต้นทุนทรัพยากรยอมรับได้หรือไม่ ผลลัพธ์ทำซ้ำได้หรือไม่
ความเข้าใจผิดที่พบบ่อย: การขยายไม่ได้หมายความว่าสร้างได้ตามอำเภอใจ
การผลักขอบเขตของวัตถุออกไป ไม่ได้หมายความว่าสามารถสร้างโค้ดได้ตามอำเภอใจ ยิ่งวัตถุมีอิสระมาก ข้อจำกัดก็ไม่ได้หายไป เพียงแต่ย้ายจาก "ช่วงค่าที่อนุญาต" ไปสู่ "ไวยากรณ์ อินเทอร์เฟซ และความสามารถในการรัน" ความรับผิดชอบในการตรวจสอบก็ไม่ได้ลดลง แต่กลับเพิ่มขึ้น ทีมที่เปิดการวิวัฒนาการระดับสคริปต์มักจะชนกับปัญหาจริงสองข้อก่อน: พื้นที่การค้นหาขยายตัวขึ้นอย่างรวดเร็ว และผู้สมัครจำนวนมากที่ "รันผ่านแต่ไม่มีผลตอบแทน" กินงบประมาณการประเมิน
ดังนั้นแนวทางที่稳妥กว่า คือการเปิดแบบเป็นชั้น: ขยายขอบเขตที่อนุญาตให้เปลี่ยนแปลงทีละชั้น ใช้การคัดกรองต้นทุนต่ำหรือโมเดลตัวแทนเพื่อกำจัดผู้สมัครที่เห็นได้ชัดว่าไม่มีประสิทธิผลก่อน แล้วจึงเก็บการประเมินความแม่นยำสูงไว้สำหรับตัวเลือกที่มีแนวโน้มไม่กี่ตัว และ权衡ระหว่างความแม่นยำกับต้นทุนอย่างชัดเจน
แผนภาพลำดับชั้นการวิวัฒน์ของวัตถุวิวัฒนาการจากพารามิเตอร์เชิงตัวเลขไปสู่โครงสร้างโค้ดที่ซับซ้อนสังเกตแผนภาพลำดับชั้นการวิวัฒน์ของวัตถุวิวัฒนาการจากพารามิเตอร์เชิงตัวเลขไปสู่โครงสร้างโค้ดที่ซับซ้อนในภาพ แล้วลองคิดว่ามันมีความสัมพันธ์อย่างไรกับ "การขยายวัตถุวิวัฒนาการจากพารามิเตอร์ไปสู่โปรแกรม โครงสร้างโมเดล กลไกอัลกอริทึม และสถานะวิศวกรรมซอฟต์แวร์"