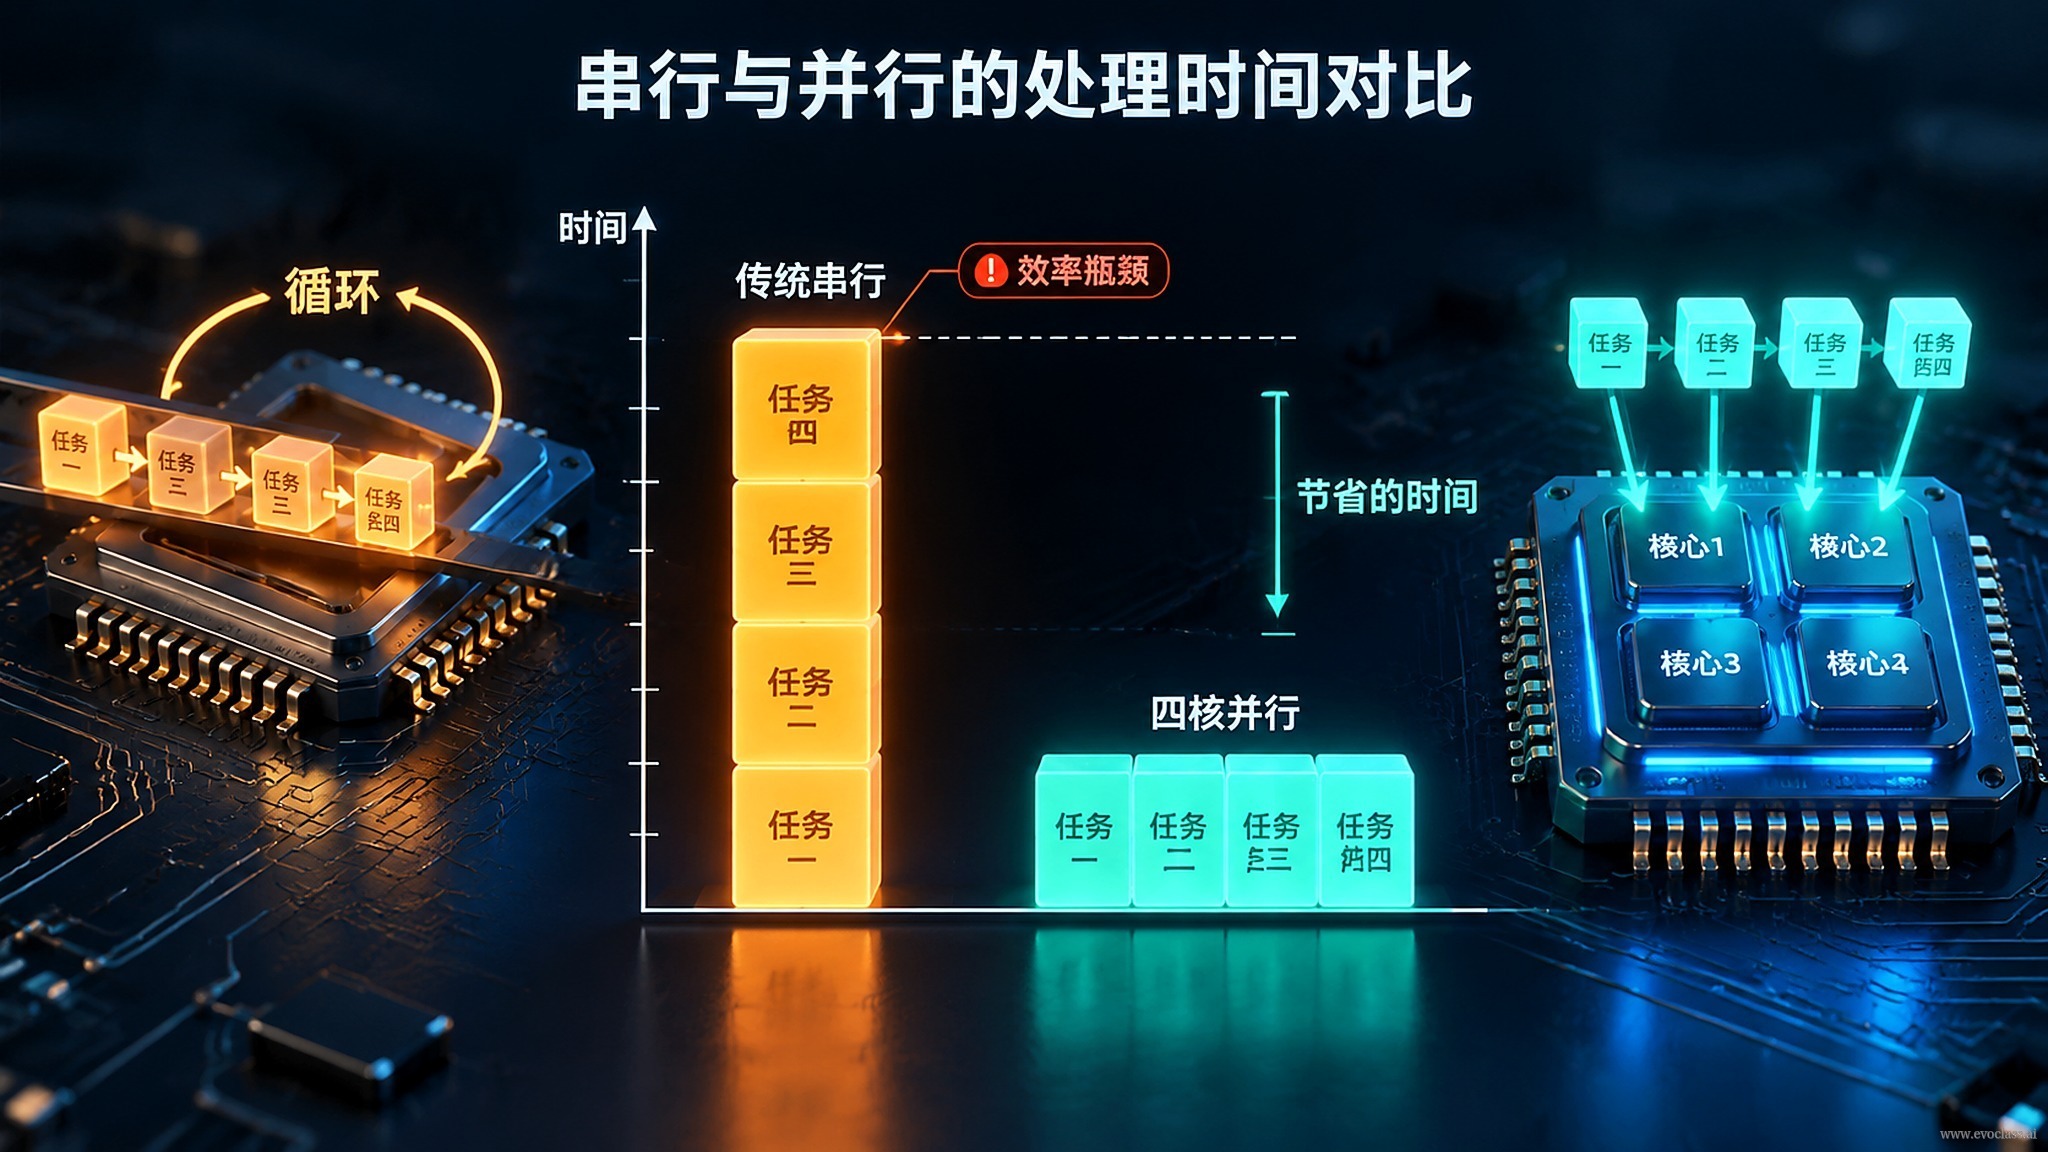
กระบวนการวิวัฒนาการต้องอาศัยความหลากหลายของประชากร และความหลากหลายหมายถึงขนาดประชากรและจำนวนครั้งในการประเมินที่เพิ่มขึ้นเป็นทวีคูณ เมื่อการประเมินผู้สมัครสูงถึงระดับหลายหมื่นครั้งลูป CPU แบบอนุกรมดั้งเดิมก็กลายเป็นส่วนที่แคบที่สุดของทั้งไปป์ไลน์ เพราะมันประมวลผลทีละหนึ่งตัวเท่านั้น ทำให้ความสามารถในการประมวลผลแบบขนานของฮาร์ดแวร์แทบไม่ถูกใช้งานเลย
ทีละตัว: โมเดลการทำงานของลูปแบบอนุกรม
วิธีที่ตรงไปตรงมาที่สุดคือการมองประชากรทั้งหมดเป็นรายการเดียว แล้วใช้ลูปดึง个体ออกมาทีละตัว: ดึง个体 → ถอดรหัสเป็นพารามิเตอร์จริง → เรียกใช้ฟังก์ชันประเมิน → เขียนค่าความเหมาะสมกลับ การทำซ้ำที่อยู่ติดกันแทบไม่สามารถทับซ้อนกันได้: ถ้าผลการประเมินไม่กลับมา การเขียนกลับก็ไม่อาจดำเนินต่อได้; ถ้าการเขียนกลับไม่เสร็จ 个体ตัวถัดไปก็ไม่มีที่เก็บผลลัพธ์ ดังนั้นหน่วยประมวลผลแบบขนานอย่างมัลติคอร์ SIMD และ GPU จึงว่างงานเสียส่วนใหญ่ ได้แต่เฝ้ามอง个体ตัวเดียววิ่งจนครบไปป์ไลน์
ค่าใช้จ่ายมาจากไหนกันแน่
- จำนวนครั้งในการประเมินที่เพิ่มขึ้นเป็นเส้นตรง: จำนวนครั้งในการประเมินทั้งหมดประมาณขนาดประชากร × จำนวนรุ่น เมื่อถึงระดับ 10⁵ เวลาตามนาฬิกาจริงแบบอนุกรมจะเพิ่มขึ้นเกือบเป็นเส้นตรง
- การทำงานทีละตัวในระดับอินเทอร์พรีเตอร์: การวนลูปทีละ个体 การตรวจสอบขอบเขต และการกระจายตามชนิดข้อมูล ทำให้เกิดค่าใช้จ่ายคงที่ที่สูง
- การเข้าถึงหน่วยความจำแบบไม่ต่อเนื่องและการเคลื่อนย้ายข้อมูล: 个体ที่ดึงมาใช้งานทีละตัวมักไม่ต่อเนื่องกันในหน่วยความจำ อัตราการเข้าถึงแคชต่ำ ต้นทุนการเคลื่อนย้ายข้อมูลจึงถูกจ่ายซ้ำแล้วซ้ำเล่า
- การซิงโครไนซ์และการจัดตาราง: เพื่อดึง个体ตัวถัดไป สายธารการทำงานต้องหยุดชะงักและเริ่มใหม่ซ้ำแล้วซ้ำเล่า
แปลงขนาดให้เป็นเวลา
ตัวอย่างเช่น ประชากร 1000 ตัว วนซ้ำ 100 รุ่น จะมีการประเมินผู้สมัครรวมประมาณ 100,000 ครั้ง หากการประเมินแต่ละครั้งใช้เวลาเฉลี่ย 1 ms เพียงแค่ขั้นตอนการประเมินแบบอนุกรมก็ต้องใช้เวลาประมาณ 100 วินาที โดยยังไม่นับค่าใช้จ่ายในการคำนวณตัวดำเนินการและการจัดตาราง หากเพิ่มจำนวนการเริ่มใหม่จาก 1 ครั้งเป็น 5 ครั้งเพื่อรักษาความหลากหลาย ต้นทุนจะเพิ่มขึ้นเกือบเป็นเส้นตรงเป็นประมาณ 500 วินาที หากจัดปริมาณงานที่เท่ากันเป็นชุดและมอบให้ฮาร์ดแวร์แบบขนานประมวลผล เวลาตามนาฬิกาจริงจะขึ้นอยู่กับจำนวนชุดเป็นหลัก ไม่ใช่จำนวน个体
เมื่อใดที่คอขวดนี้จะแคบลง
เงื่อนไขขอบเขตก็สำคัญเช่นกัน: เมื่อการประเมินแต่ละครั้งมีต้นทุนต่ำมาก (ระดับไมโครวินาที) หรือประชากรมีขนาดเล็กมาก (ต่ำกว่าระดับร้อย) ค่าใช้จ่ายในการจัดตารางและหน่วยความจำอาจสูงกว่าค่าใช้จ่ายในการคำนวณ ช่องว่างระหว่างแบบอนุกรมและแบบขนานจะแคบลงอย่างชัดเจน ผลตอบแทนส่วนเพิ่มจากการทำเป็นเทนเซอร์จะลดลง และคอขวดจะย้ายไปที่ความละเอียดของการจัดตารางและแบนด์วิดท์หน่วยความจำ ดังนั้นการจะปรับเปลี่ยนโมเดลการทำงานหรือไม่นั้น จำเป็นต้องประเมินร่วมกับต้นทุนการประเมินและขนาด
การเปรียบเทียบเวลาที่ใช้ระหว่างแบบอนุกรมและแบบขนานตัวอย่างเช่น ประชากร 1000 ตัว วนซ้ำ 100 รุ่น จะมีการประเมินผู้สมัครรวมประมาณ 100,000 ครั้ง เมื่อการประเมินแต่ละครั้งใช้เวลา 1 มิลลิวินาที เพียงแค่ขั้นตอนการประเมินแบบอนุกรมก็ต้องใช้เวลาประมาณ 100 วินาที หากเริ่มใหม่ 5 ครั้งจะเพิ่มขึ้นเกือบเป็นเส้นตรงเป็นประมาณ 500 วินาที เมื่อเปลี่ยนมาจัดเป็นชุดและมอบให้ฮาร์ดแวร์แบบขนาน เวลาตามนาฬิกาจริงจะขึ้นอยู่กับจำนวนชุดเป็นหลัก ไม่ใช่จำนวน个体