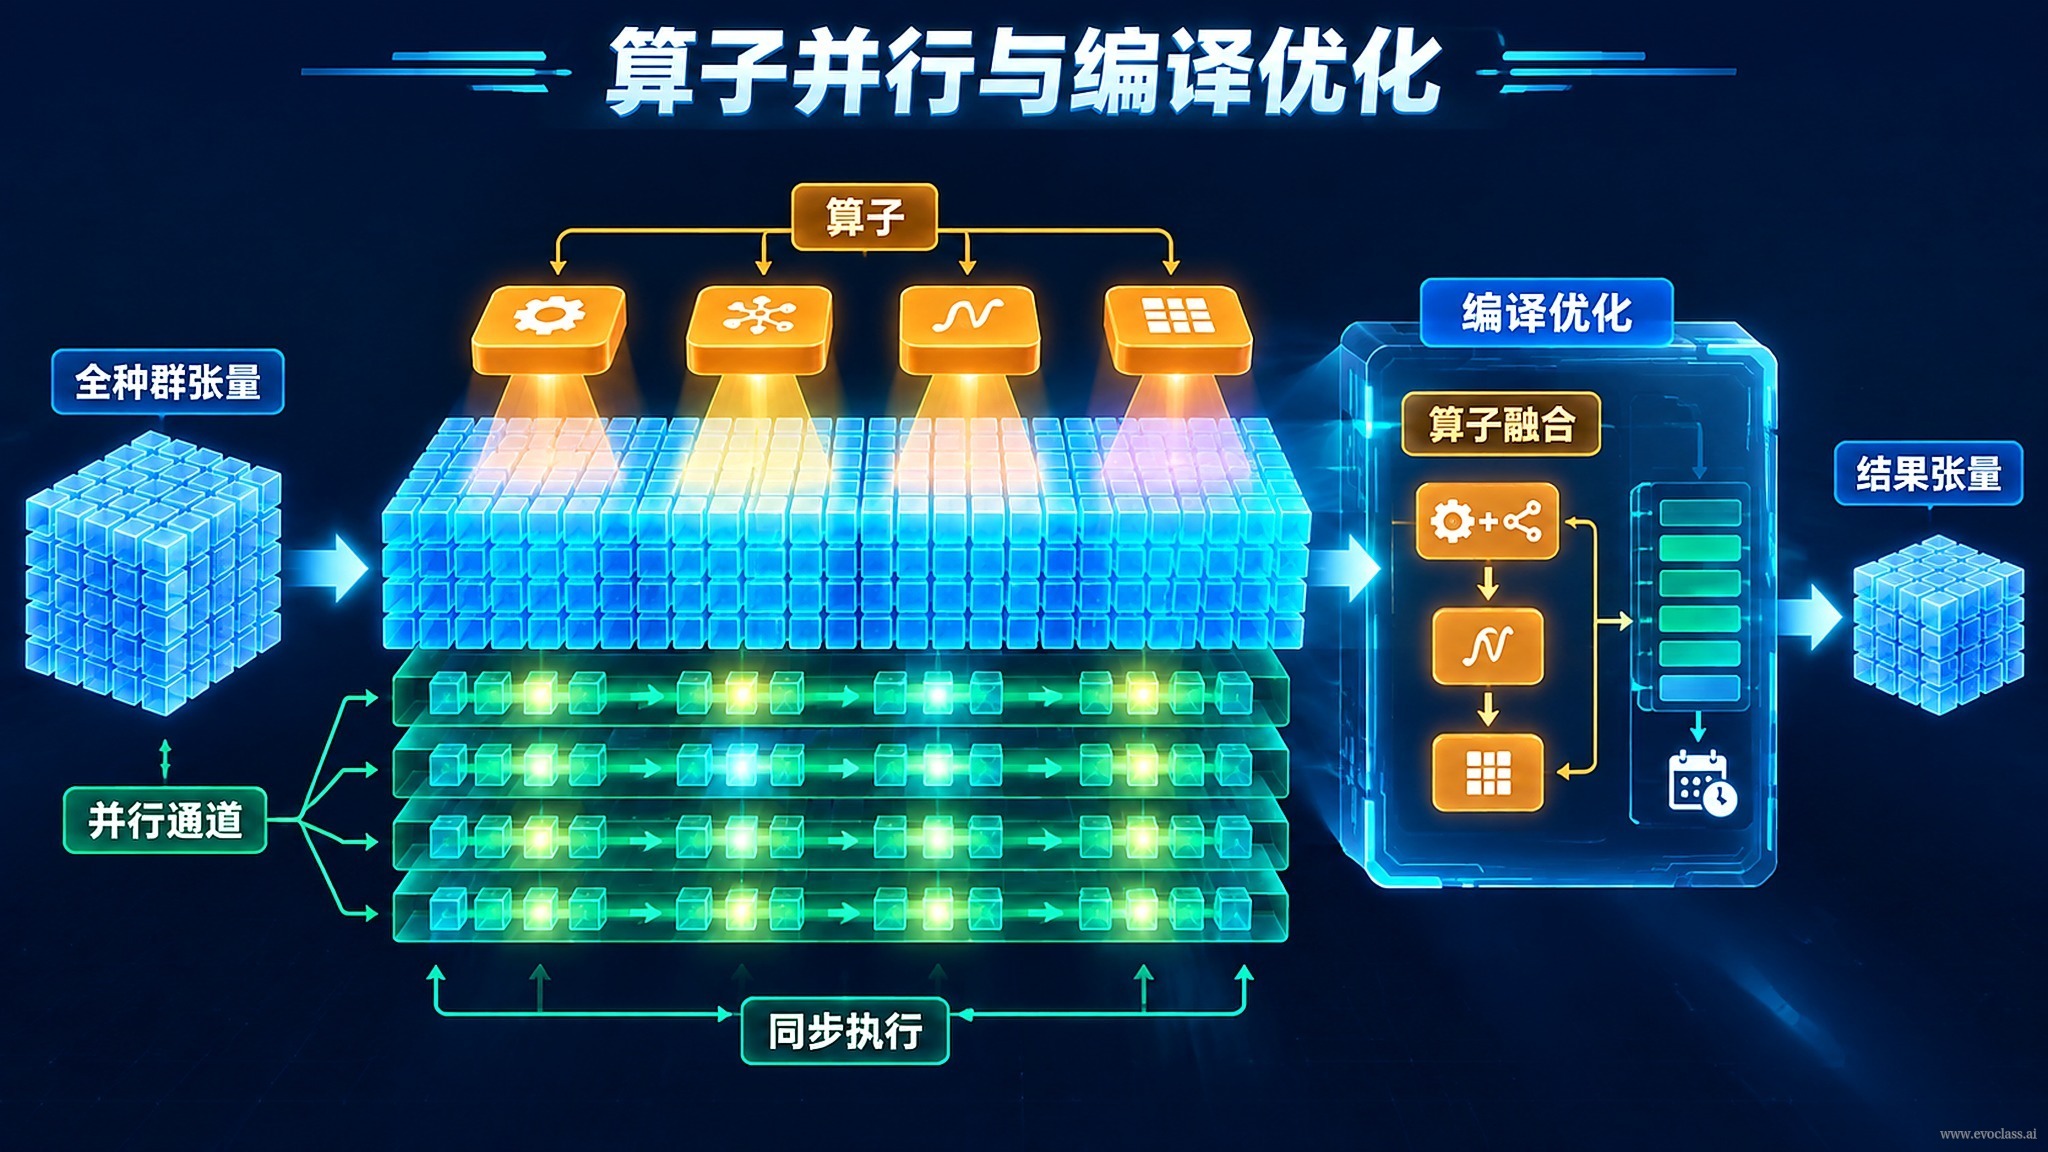
在 EvoX 的现代计算底座中,演化算子的最小执行单元不再是“个体”,而是整个种群张量:变异、交叉、选择等算子一次调用即可覆盖全部个体;在此之上,计算图编译把算子序列组织成可优化的执行计划,在保持算法语义不变的前提下提升执行效率。
算子并行:以张量为单位的批量演化
- 张量级算子:变异、交叉、选择可直接作用于形状为 [N, D] 的种群张量(N 为种群规模,D 为决策变量维度),一次算子调用覆盖全部 N 个个体。
- 消除逐个体循环:不必再写
for ind in population: ind = mutate(ind)这样的 Python/CPU 串行循环,从而减少频繁的函数调度与框架调用开销。 - 用批量维度换吞吐:个体维度充当批量维度后,算子在设备上以大规模并行方式执行,批量演化的吞吐随种群规模放大。
计算图编译:从算子序列到执行计划
把“变异 → 交叉 → 选择”的算子依赖关系组织成一张计算图,编译器就能在整张图上做全局优化,而不只是逐个算子地调用现成实现:
- 算子融合:把多个逐元素(element-wise)运算合并成一个内核,减少中间张量的产生与反复读写。
- 内核生成与调度:为融合后的子图生成高效内核,用更少的 kernel 启动次数完成整代演化。
- 内存复用:为中间结果预先规划缓冲区,降低显存分配与数据搬运带来的额外开销。
效率变了,语义没变
需要区分“怎么算”与“算什么”。算子并行与编译优化只改变执行方式——内核数量、中间张量规模、内存与调度策略——而不改变变异、交叉、选择本身的逻辑含义。算法层仍然按演化语义组合算子,因此在相同随机种子下,优化前后的演化轨迹与结果应当一致。一句话概括:张量化解决“批量算得快不快”,计算图编译解决“内核调度得优不优”,而“算的是什么”保持不变。
常见误区
把“张量化”误认为“换了一种演化算法”。张量化只是把同一个算子作用到整个种群张量上,个体之间的更新规则没有改变;编译优化同样不会让算法“变得更聪明”。真正需要警惕的是优化之后不做回归验证,把实现差异误当成算法改进。
算子在全种群张量上的并行流程变异、交叉、选择不再逐个个体循环,而是各自一次调用覆盖整个[N, D]种群张量,个体维度充当批量维度以放大吞吐;这些算子按依赖关系组成计算图后,编译器可做算子融合、内核生成与内存复用,只改变执行方式,算法语义与随机种子下的演化轨迹不变。
算子在全种群张量上的并行流程
变异、交叉、选择不再逐个个体循环,而是各自一次调用覆盖整个[N, D]种群张量,个体维度充当批量维度以放大吞吐;这些算子按依赖关系组成计算图后,编译器可做算子融合、内核生成与内存复用,只改变执行方式,算法语义与随机种子下的演化轨迹不变。