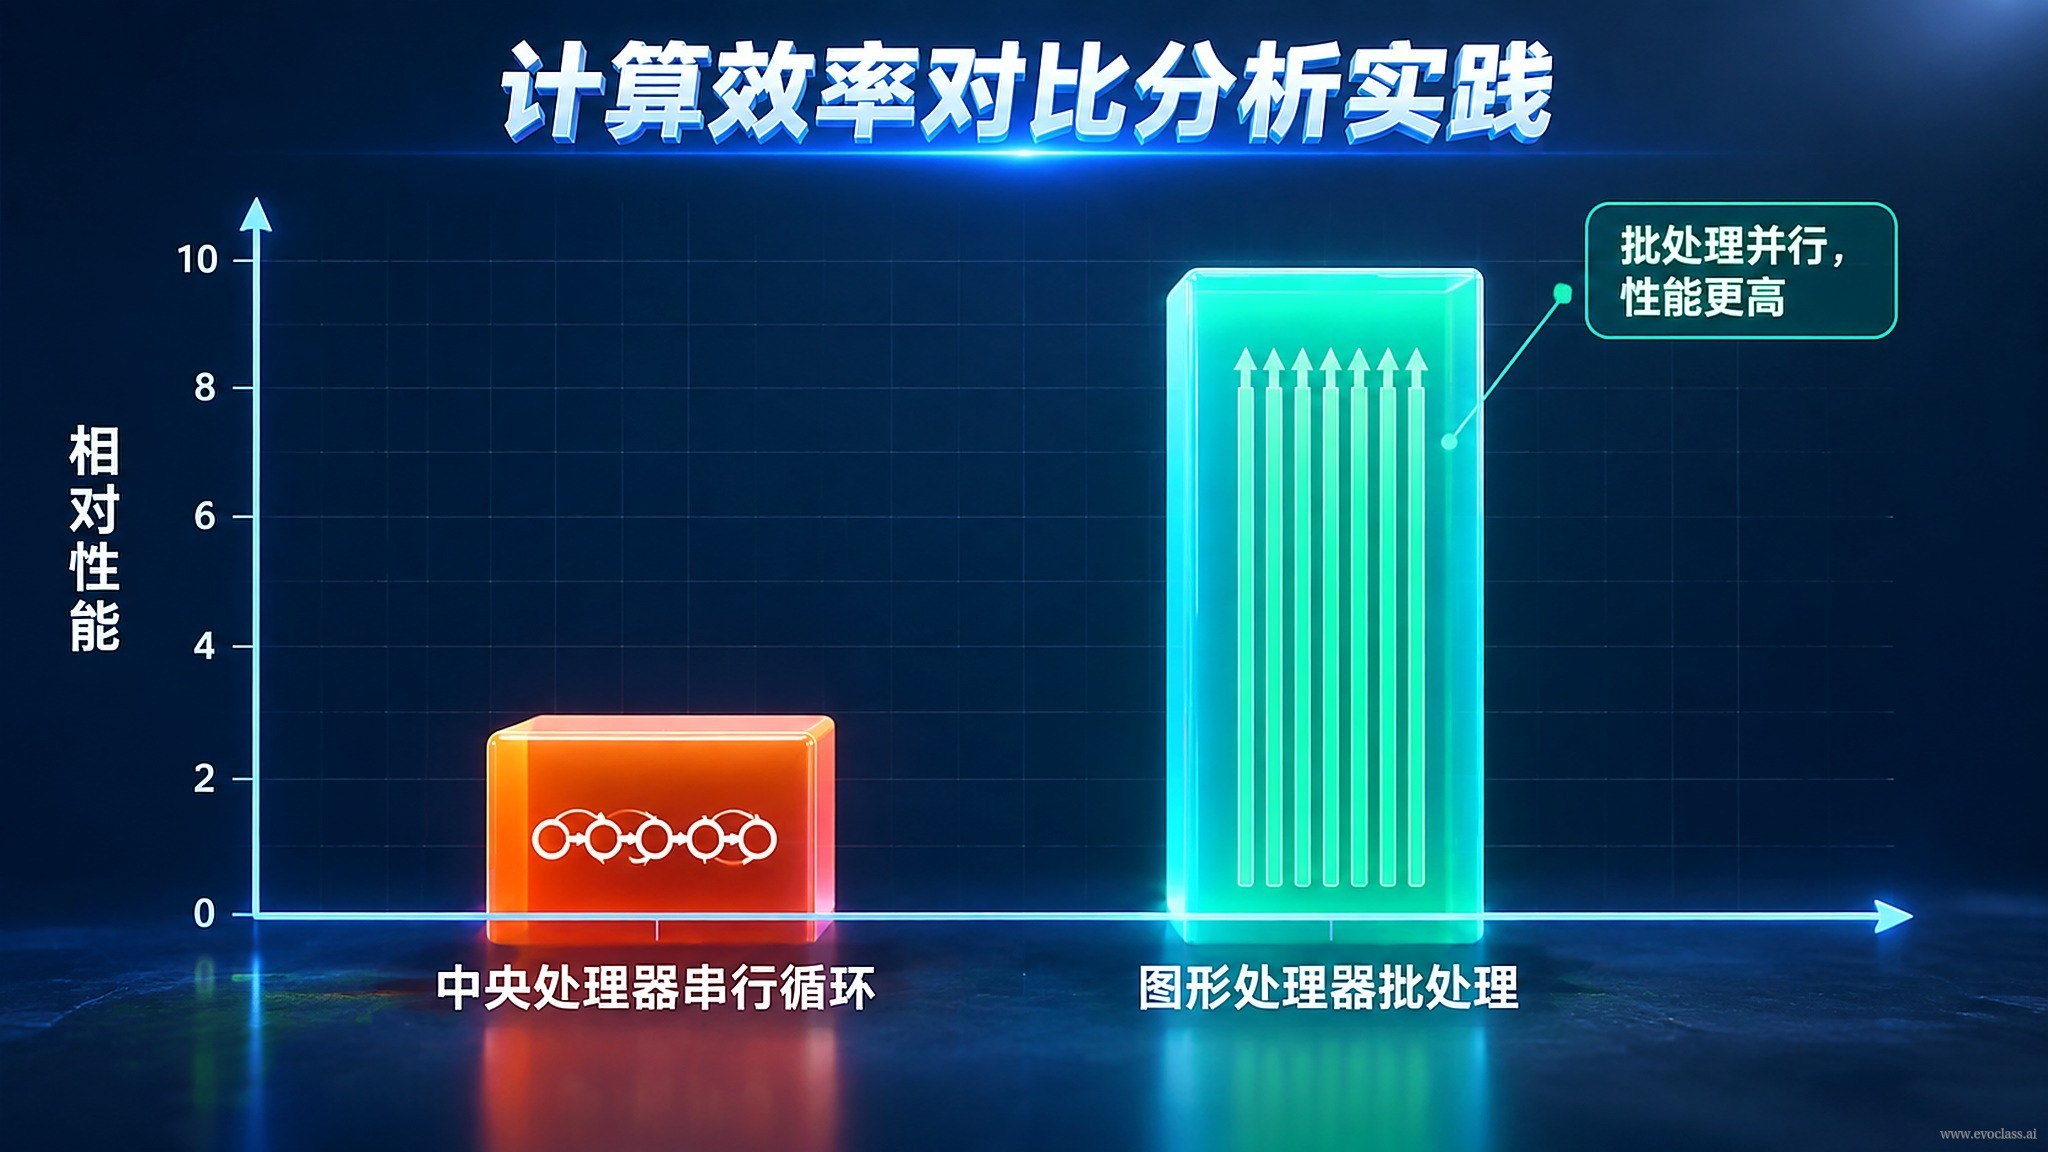
หน้านี้จะนำ «การเปรียบเทียบประสิทธิภาพการคำนวณ» มาสู่การปฏิบัติจริงที่ทำซ้ำได้:บนงานวิวัฒนาการเดียวกัน เปรียบเทียบประสิทธิภาพแบบ end-to-end ระหว่างการวนซ้ำแบบอนุกรมบน CPU แบบดั้งเดิม กับการประมวลผลแบบแบตช์เทนเซอร์บน GPU ด้วย EvoXเป้าหมายไม่ใช่การจำข้อสรุปว่า «GPU เร็วกว่า» แต่เป็นการเข้าใจว่าการเร่งความเร็วที่เกิดจากความขนานแบบเทนเซอร์นั้นมาจากไหน มีต้นทุนอะไร และมีขีดจำกัดตรงไหน
สองเส้นฐาน งานเดียวกัน
- เส้นฐานแบบอนุกรมบน CPU: ใช้วงลูปเรียกฟังก์ชันประเมินทีละตัว แต่ละรุ่นต้องมีการจัดตาราง อัปเดตสถานะ และรวบรวมผลลัพธ์แยกกัน N ครั้ง การควบคุมวงลูป ภาระของอินเทอร์พรีเตอร์ และการเข้าถึงหน่วยความจำที่กระจัดกระจาย จะเจือจางกำลังการคำนวณที่มีประสิทธิภาพ ยิ่งมีตัวมาก สัดส่วนต้นทุน «ที่ไม่ใช่การคำนวณ» เหล่านี้ก็ยิ่งสูง
- การใช้งานเทียบเคียงแบบเทนเซอร์บน GPU: EvoX จัดระเบียบประชากร อินพุตการประเมิน และสถานะการทำงานให้เป็นเทนเซอร์ แล้วประมวลผลการประเมินและตัวดำเนินการแบบแบตช์บน GPU การเรียกครั้งเดียวครอบคลุมชุดผู้สมัครทั้งหมด จึงลดวงลูปแบบอนุกรมและจำนวนครั้งในการจัดตารางลงอย่างมาก
โปรโตคอลการวัด: ทำให้การเปรียบเทียบทำซ้ำได้
การเปรียบเทียบที่ทำซ้ำได้ต้องกำหนดปัญหาคงที่ ขนาดประชากร จำนวนรุ่น และสุ่มเมล็ดพันธุ์จากนั้นบันทึก: เวลา wall-clock ต่อรุ่น เวลารวมทั้งหมด อัตราการประมวลผล (การประเมิน/วินาที) อัตราเร่งความเร็ว รวมถึงอัตราการใช้งาน GPU และการใช้หน่วยความจำการ์ดจอ ก่อนจับเวลาจำเป็นต้องอุ่นเครื่องเพื่อกำจัดผลกระทบจากการคอมไพล์ครั้งแรกและการจัดสรรหน่วยความจำการ์ดจอ และทำการซิงค์อุปกรณ์ที่จุดจับเวลา พร้อมทั้งแยกสถิติเวลาที่ใช้คำนวณกับเวลาที่ใช้ส่งข้อมูลระหว่างโฮสต์กับอุปกรณ์ออกจากกัน หากขาดขั้นตอนใดขั้นตอนหนึ่ง อัตราเร่งความเร็วที่ได้อาจคลาดเคลื่อน
ความแตกต่างมาจากไหน และถูกจำกัดด้วยอะไร
- ที่มาของผลประโยชน์: ความขนานแบบแบตช์ ตัวดำเนินการเทนเซอร์ และความขนานภายในอุปกรณ์ ทำให้การเรียกครั้งเดียวประมวลผลชุดผู้สมัครทั้งหมด และประเมินได้มากขึ้นต่อหน่วยเวลา
- เงื่อนไขข้อจำกัด: ขนาดแบตช์ มิติของปัญหา ระดับที่ฟังก์ชันประเมินสามารถแปลงเป็นเวกเตอร์ได้ ภาระการคัดลอกระหว่างโฮสต์กับอุปกรณ์ และภาระการเริ่มต้นเคอร์เนล ล้วนส่งผลต่อความเร็วสุดท้าย แบตช์ที่เล็กเกินไปจะทำให้ภาระการเริ่มต้นกัดกินผลประโยชน์ หากฟังก์ชันประเมินไม่สามารถแปลงเป็นเวกเตอร์ได้ การประมวลผลแบบแบตช์แทบจะใช้งานไม่ได้เลย
ข้อสรุปจากการปฏิบัติ
ลำดับที่ถูกต้องคือ:ตรวจสอบก่อนว่าฟังก์ชันประเมินสามารถทำเป็นแบตช์ได้หรือไม่ แล้วจึงเปรียบเทียบการใช้งานบน CPU กับ GPUข้อได้เปรียบด้านประสิทธิภาพในท้ายที่สุดควรมุ่งไปที่ «การได้รุ่นเพิ่มขึ้นหรือได้ทางเลือกผู้สมัครมากขึ้นภายใต้งบประมาณการคำนวณที่เท่ากัน» และนำไปใช้ตัดสินใจรูปแบบการติดตั้งใช้งานและการออกแบบการทดลอง แทนที่จะมุ่งแค่ได้ตัวเลขอัตราเร่งความเร็วที่สวยงามเพียงอย่างเดียว
การเปรียบเทียบประสิทธิภาพระหว่าง CPU แบบอนุกรมกับ GPU แบบแบตช์ในการเปรียบเทียบนี้ เส้นฐานแบบอนุกรมบน CPU จะประเมินทีละตัวด้วยวงลูป แต่ละรุ่นต้องจัดตารางและอัปเดตสถานะ N ครั้ง ภาระของอินเทอร์พรีเตอร์และการเข้าถึงหน่วยความจำจะเจือจางกำลังการคำนวณที่มีประสิทธิภาพ ส่วนการประมวลผลแบบแบตช์บน GPU จะจัดระเบียบประชากรและอินพุตการประเมินให้เป็นเทนเซอร์ การเรียกครั้งเดียวครอบคลุมชุดผู้สมัครทั้งหมด อัตราเร่งความเร็วถูกจำกัดด้วยขนาดแบตช์ ระดับที่ฟังก์ชันประเมินสามารถแปลงเป็นเวกเตอร์ได้ และภาระการคัดลอกระหว่างโฮสต์กับอุปกรณ์