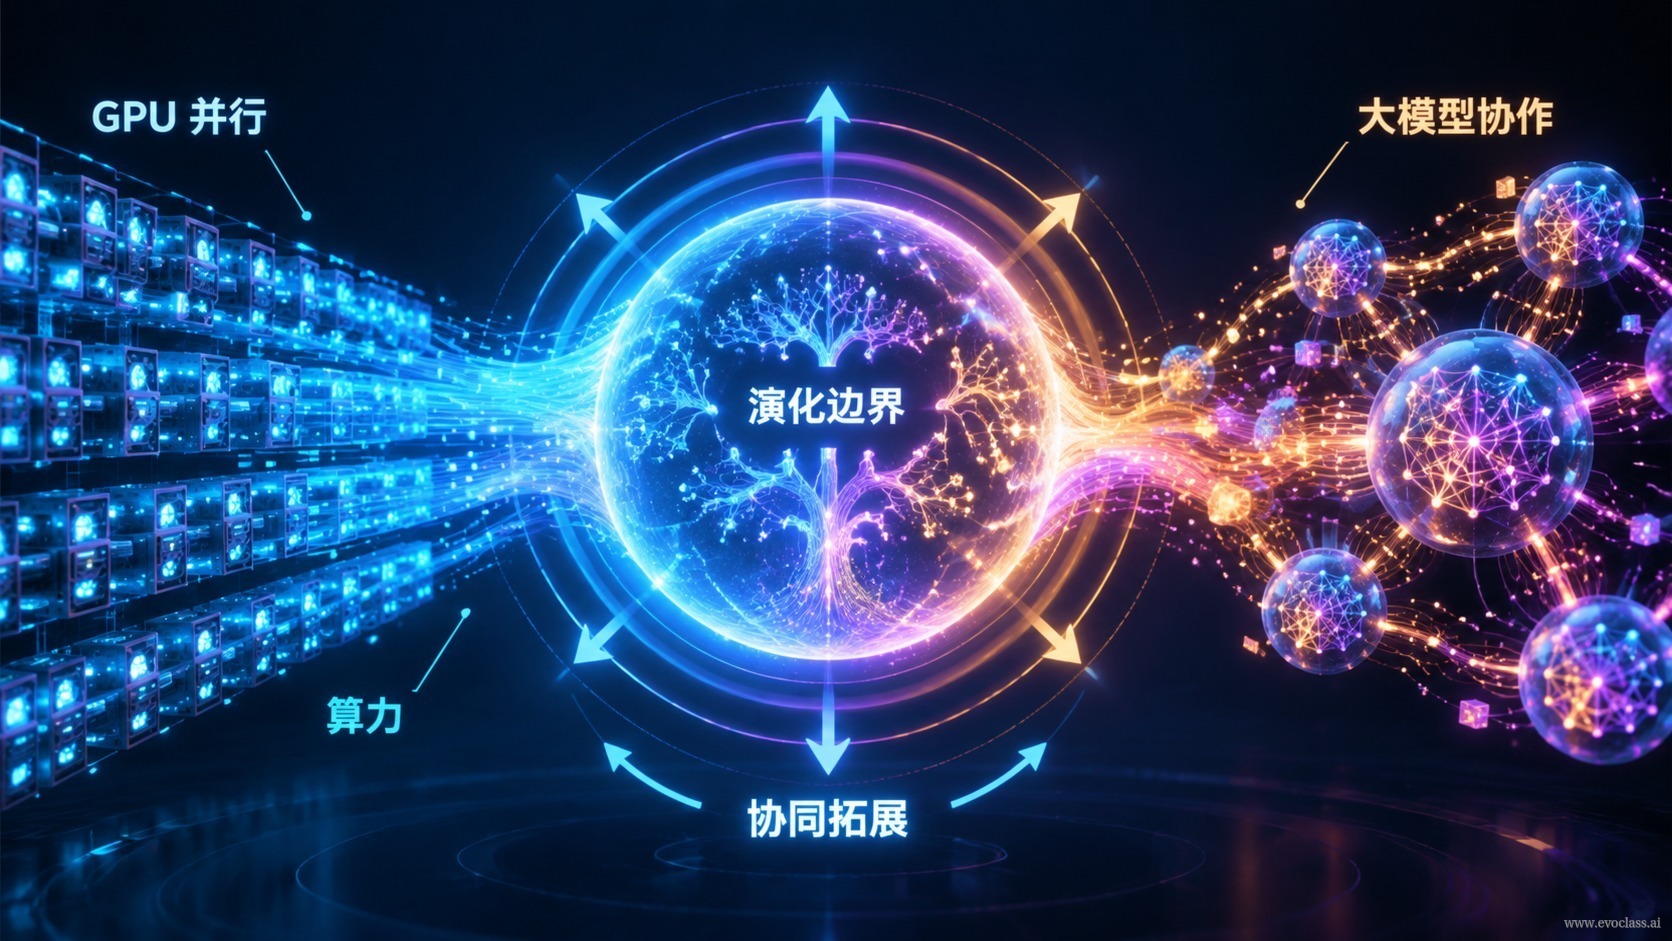
การคำนวณเชิงวิวัฒนาการถูกจำกัดด้วยปัญหาจริงมาโดยตลอด นั่นคือภายในเวลาที่จำกัดเราสามารถประเมินCandidateได้มากน้อยเพียงใด วันนี้ข้อจำกัดนี้ถูกคลายออกพร้อมกันด้วยพลังทางวิศวกรรมสองสาย —พลังประมวลผลแบบขนานของ GPUและการสร้างเชิงความหมายด้วยโมเดลขนาดใหญ่ทั้งสองร่วมกันเป็นฐานทางวิศวกรรมสองชั้นของการคำนวณเชิงวิวัฒนาการ:พลังประมวลผลกำหนดว่า "จะสำรวจCandidateได้กี่ตัวในแต่ละครั้ง" ส่วนโมเดลขนาดใหญ่กำหนดว่า "จะสำรวจCandidateในรูปแบบใดได้บ้าง"ทั้งสองร่วมกันขยายพรมแดนของวัตถุวิวัฒนาการจากพารามิเตอร์เชิงตัวเลขออกไปสู่โปรแกรม โครงสร้างโมเดล และกลไกของอัลกอริทึมเอง
ฐานพลังประมวลผล: ย้ายพื้นที่Candidateจากแบบอนุกรมสู่เทนเซอร์
ในการใช้งานแบบดั้งเดิม การประเมินประชากรเป็นลูปแบบอนุกรมบน CPU ซึ่งประมวลผลทีละตัวบุคคล และค่าใช้จ่ายในการจัดตารางจะสะสมตามขนาดประชากร ฐานโอเพนซอร์สอย่าง EvoX ได้จัดระเบียบCandidate ผลการประเมิน และสถานะของอัลกอริทึมให้เป็นเทนเซอร์ที่คำนวณได้ทั้งชุดในคราวเดียว: การกลายพันธุ์กระทำต่อทั้งประชากร การประเมินและการอัปเดตสถานะรวมกับการคัดเลือกเข้าสู่กราฟการคำนวณเพื่อรับการปรับแต่งจากการคอมไพล์ ผลลัพธ์โดยตรงทางวิศวกรรมคือ "การสำรวจCandidateระดับหลายหมื่นตัวพร้อมกัน" เปลี่ยนจากเทคนิคในห้องแล็บกลายเป็นวิธีปฏิบัติทั่วไป
ฐานแบบนี้แบ่งระบบออกเป็นอัลกอริทึม โมดูลปัญหา เวิร์กโฟลว์ และตัวจัดตาราง Runtime โดยนักวิจัยเพียงมุ่งเน้น "จะวิวัฒนาการอย่างไร" ส่วน Runtime รับผิดชอบจัดตารางการคำนวณแบบกลุ่มไปยัง GPU อุปกรณ์เร่งความเร็ว หรือคลัสเตอร์แบบกระจาย สิ่งที่ต้องมองให้ชัดคือ: พลังประมวลผลแก้ปัญหาเรื่องปริมาณงานไม่ใช่ "ความฉลาด" มันไม่ตัดสินว่าCandidateดีหรือไม่ แต่มีหน้าที่คำนวณค่าความเหมาะสมของทั้งประชากรในคราวเดียวเท่านั้น มันเป็นฐานรองรับของการขยายพื้นที่Candidate แต่ไม่ได้กำหนดว่าCandidateจะมีหน้าตาอย่างไร
ฐานเชิงความหมาย: ยกรูปแบบCandidateจากเวกเตอร์ตัวเลขสู่แผนเชิงโครงสร้าง
คุณูปการของโมเดลขนาดใหญ่ไม่ได้อยู่ที่คำนวณได้เร็วขึ้น แต่อยู่ที่มันเข้าใจโค้ด ความรู้เฉพาะทาง และบริบทของงาน จึงมีความสามารถในการสร้างระดับความหมายด้วยเหตุนี้จึงสามารถสร้างCandidateที่มีโครงสร้างซับซ้อนได้ — ไม่ว่าจะเป็นโค้ดสำหรับแก้ปัญหาที่เรียกใช้ได้ทันที หรือโครงสร้างของโมเดลตัวแทน — แทนที่จะส่งออกเพียงเวกเตอร์ตัวเลข พื้นที่ "รูปแบบ" ของCandidateจึงถูกเปิดออก
การขยายพรมแดนวัตถุวิวัฒนาการสามลำดับ
- พารามิเตอร์เชิงตัวเลข: การตั้งค่าแบบคลาสสิก สมาชิกของประชากรคือชุดค่าพารามิเตอร์ภายใต้โครงสร้างคงที่
- โปรแกรม / โครงสร้างโมเดล: สมาชิกของประชากรกลายเป็นโค้ดที่รันได้ หรือโครงสร้างเครือข่ายและโมเดลตัวแทน ความสามารถในการสร้างของโมเดลขนาดใหญ่คือประตูสู่ลำดับนี้
- กลไกของอัลกอริทึม: แม้แต่กระบวนการ "จะสร้างอย่างไร จะประเมินอย่างไร" เองก็กลายเป็นวัตถุที่ถูกวิวัฒนาการ นี่คือเงื่อนไขที่ทำให้แนวทาง "ใช้ววัฒนาการปรับปรุงวิวัฒนาการ" (เช่น MetaDE, AutoPSO) ในภายหลังเป็นไปได้
ยกตัวอย่างการปรับแต่งแอร์ฟอยล์: วิธีดั้งเดิมทำได้เพียงค้นหาในพารามิเตอร์เชิงตัวเลขที่กำหนดไว้ล่วงหน้าจำนวนหนึ่ง แต่เมื่อโมเดลขนาดใหญ่อ่านเขียนโค้ดสำหรับแก้ปัญหาและสร้างโครงสร้างโมเดลตัวแทนได้ และ GPU ก็ประเมินทั้งประชากรแบบขนานได้ วัตถุที่ค้นหาจึงยกระดับจาก "ชุดค่าพารามิเตอร์" ขึ้นเป็น "ชุดแผนการสร้างและประเมินผลเอง"
เสริมกัน ไม่ใช่แทนกัน
ทั้งสองมีความสัมพันธ์แบบเสริมกัน: พลังประมวลผลขยายความกว้างของการค้นหา ส่วนโมเดลขนาดใหญ่ยกระดับคุณภาพและความซับซ้อนทางรูปแบบของCandidateหากขาดฝ่ายใดฝ่ายหนึ่ง การขยายพรมแดนก็เป็นไปไม่ได้ ถ้ามีเพียงพลังประมวลผลแต่ไม่มีการสร้างเชิงความหมาย วัตถุที่ค้นหาก็ยังถูกจำกัดอยู่ในรหัสที่เขียนตายตัวไว้ล่วงหน้า ถ้ามีเพียงความสามารถในการสร้างแต่ไม่มีการประเมินแบบกลุ่ม Candidateจำนวนมหาศาลก็ไม่อาจคัดกรองเสร็จภายในเวลาที่ยอมรับได้
ราคาที่ต้องจ่ายของการขยายพรมแดน
การขยายพรมแดนนำมาซึ่งข้อจำกัดใหม่พร้อมกัน: หนึ่งคือต้นทุนการประเมินสูงขึ้นการประเมินครั้งเดียวอาจเปลี่ยนจากระดับมิลลิวินาทีเป็นระดับนาที สองคือการตรวจสอบความถูกต้องทำได้ยากขึ้นโค้ดที่สร้างขึ้นอาจคอมไพล์ไม่ได้ หรือไม่เป็นไปตามข้อจำกัดทางฟิสิกส์และวิศวกรรม สามคือเกณฑ์การตัดสิน "คำตอบที่ใช้งานได้" คลุมเครือยิ่งขึ้นจึงต้องเชื่อมโยงกับขั้นตอนอย่างการ权衡หลายวัตถุประสงค์และการตัดสินใจของผู้เชี่ยวชาญ
ผังกระบวนการขยายพรมแดนวิวัฒนาการด้วยความร่วมมือระหว่าง GPU แบบขนานและโมเดลขนาดใหญ่ภาพนี้แสดงว่าการขยายพรมแดนวิวัฒนาการต้องอาศัยฐานสองชั้น: GPU และ Runtime แบบเทนเซอร์ย้ายการประเมินประชากรจากลูปแบบอนุกรมสู่การขนานแบบกลุ่ม กำหนดว่าจะสำรวจCandidateได้กี่ตัวในแต่ละครั้ง ส่วนโมเดลขนาดใหญ่ให้การสร้างระดับความหมาย กำหนดว่าจะสร้างCandidateในรูปแบบใดได้บ้าง เมื่อทั้งสองเสริมกัน วัตถุวิวัฒนาการสามารถขยายจากพารามิเตอร์เชิงตัวเลขไปสู่โปรแกรม/โครงสร้างโมเดล และต่อไปยังกลไกของอัลกอริทึม แต่ก็ยังนำมาซึ่งข้อจำกัดใหม่ เช่น ต้นทุนการประเมิน การตรวจสอบความถูกต้อง และเกณฑ์การตัดสินคำตอบ