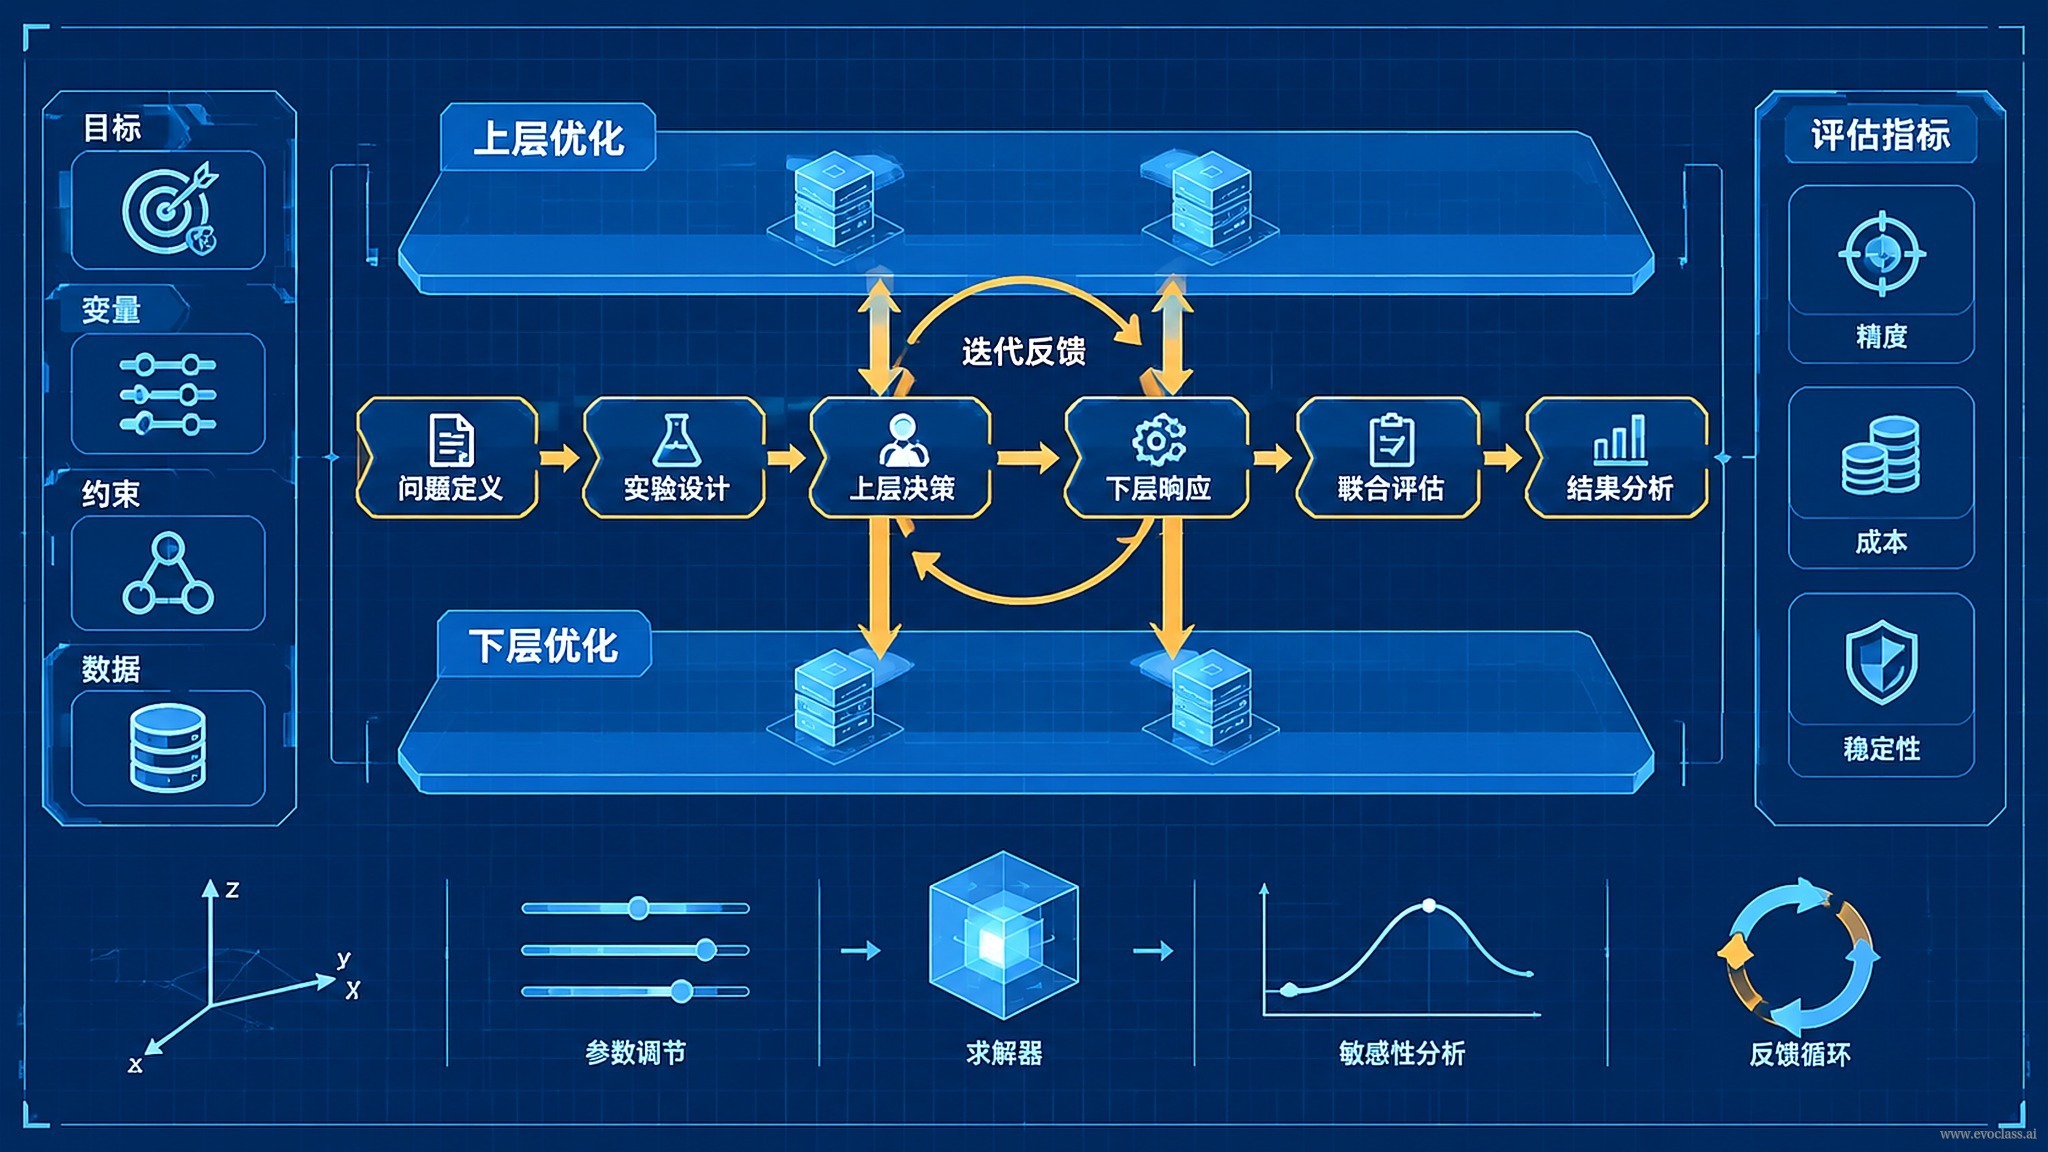
พิมพ์เขียวการทดลองการปรับให้เหมาะสมแบบสองชั้นต้องตอบคำถามหนึ่งข้ออย่างเจาะจง:ค่าปัจจัยการกลายพันธุ์ F ของขั้นตอนวิธีวิวัฒนาการเชิงอนุพันธ์ (DE) ควรตั้งไว้เท่าใดกันแน่แนวทางไม่ใช่การปรับด้วยมือต่อไป แต่เป็นการยกระดับ F จากค่าพารามิเตอร์ไฮเปอร์ที่คงที่เป็นวัตถุที่วิวัฒนาการได้ในชั้นนอกโดยถือ "การรันงานแก้ปัญหาด้วย DE หนึ่งครั้งด้วยค่า F ที่กำหนด" เป็นกระบวนการประเมินในชั้นในส่วนชั้นนอกจะอัปเดตคอนฟิกโดยอาศัยผลการทำงานของงานในชั้นใน พิมพ์เขียวนี้ทำงานได้จริงเพราะตั้งอยู่บนฐานการประมวลผลสมัยใหม่ของ EvoX: ประชากร ผลการประเมิน และสถานะของขั้นตอนวิธีถูกจัดเรียงเป็นเทนเซอร์ที่คำนวณได้ทั้งก้อน ทำให้คอนฟิกผู้สมัครถูกกลายพันธุ์เป็นชุด ประเมินเป็นชุด และเข้าสู่กราฟการคำนวณเพื่อรับการปรับให้เหมาะสมโดยตัวคอมไพล์ จากนั้นจึงใช้ ตัวจัดตารางเวลา Runtimeกระจายการคำนวณไปยัง GPU อุปกรณ์เร่งความเร็ว หรือคลัสเตอร์แบบกระจาย ทำให้วงรอบการทดลองแบบอนุกรมที่เคยยาวนานถูกย่นให้สั้นลงจนอยู่ในกรอบเวลาที่ยอมรับได้
ภารกิจชั้นใน: เปลี่ยนผลงานให้เป็นสัญญาณที่เปรียบเทียบได้
ชั้นในคือการทดลองที่ทำซ้ำได้เริ่มจากเลือกภารกิจการปรับให้เหมาะสมหรือชุดฟังก์ชัน基準หนึ่งชุด แล้วล็อกโครงสร้างหลักของ DE ขนาดมิติ งบประมาณการประเมิน และชุดซีดแบบสุ่มทั้งหมด — ปริมาณเดียวที่เปลี่ยนแปลงคือคอนฟิก F ที่ส่งมาจากชั้นนอก การรันแต่ละครั้งต้องบันทึก: ค่าที่ดีที่สุด ความเร็วการลู่เข้า (จำนวนรุ่นที่ใช้ถึงเกณฑ์) อัตราความสำเร็จ ปริมาณการละเมิดเงื่อนไข ตัวชี้วัดหลายวัตถุประสงค์ (เช่น ไฮเปอร์โวลุ่ม) และความหลากหลายของผู้สมัคร บันทึกเหล่านี้คือข้อมูลทั้งหมดที่ชั้นนอก "มองเห็น" และเป็นหลักฐานเดียวที่ชั้นนอกใช้ตัดสินว่าดีหรือไม่ การประเมินทำเป็นชุดแบบเทนเซอร์ ผู้สมัครกลุ่มเดียวกันใช้กราฟการคำนวณร่วมกัน ช่วยหลีกเลี่ยงค่าใช้จ่ายจากการประเมินทีละบุคคลแบบอนุกรม
วัตถุกลยุทธ์ชั้นนอก: F ไม่ใช่ค่าคงที่อีกต่อไป
สิ่งที่ชั้นนอกค้นหาไม่ใช่ค่าตัวเลขตัวเดียว แต่เป็น กลยุทธ์ Fการเข้ารหัสที่พบบ่อยมีสามแบบ: ค่า F คงที่; ค่าคงที่แบบแบ่งช่วง เช่น จีน [F1, F2, F3] สลับตามช่วงรุ่น; ฟังก์ชันจัดตารางที่ควบคุมด้วยจีนจำนวนเล็กน้อย เช่น กระตุ้นค่า F ต่างกันตามอัตราความสำเร็จปัจจุบัน ความแปรปรวนของประชากร หรือสัดส่วนของรุ่น การเข้ารหัสแบบกลยุทธ์นอกเหนือจากจีนเองแล้วยังต้องระบุลักษณะอินพุตและกฎเอาต์พุตให้ชัดเจน มิฉะนั้นจีนชุดเดียวกันจะให้ผลลัพธ์完全不同ในแต่ละการนำไปใช้
วิธีแมป: จีนไทป์ไปยังคอนฟิกขณะรัน
การแมปจากจีนไทป์ชั้นนอกไปยังคอนฟิกขณะรันของชั้นในต้องชัดแจ้งและทำซ้ำได้ตัวอย่าง จีน [Fเริ่ม, Fสิ้นสุด, การลดลง] แมปเป็นตารางที่ลดลงตามรุ่น: F(t) = Fเริ่ม + (Fสิ้นสุด − Fเริ่ม) × e^(−การลดลง × t / T) โดย t คือรุ่นปัจจุบัน T คือจำนวนรุ่นทั้งหมด; จีน [F1, F2, F3] แมปเป็นการสลับค่าคงที่สามช่วง จีนไทป์เดียวกันต้องแมปไปยังคอนฟิกขณะรันเดียวกันเสมอ มิฉะนั้น "จีนดี" ที่ชั้นนอกเรียนรู้มาจะอธิบายไม่ได้และถ่ายโอนไปยังภารกิจใหม่ก็ไม่ได้
กระบวนการวงปิดและบันทึกที่ต้องมี
วงจรสมบูรณ์คือ: ประชากรชั้นนอกสร้างชุดคอนฟิก F → ตัวจัดตารางเวลา Runtime กระจายภารกิจ DE ชั้นในแบบขนานเป็นชุดเทนเซอร์ → ประเมินเป็นชุดบน GPU → สรุปตัวชี้วัด → ชั้นนอกคัดเลือก กลายพันธุ์ ไขว้ และอัปเดต → เข้าสู่รอบถัดไป ที่นี่ใช้โครงสร้างแบบแบ่งชั้นของ EvoX: ชั้นอัลกอริทึมรับผิดชอบตรรกะวิวัฒนาการชั้นนอกและ DE ชั้นใน โมดูลปัญหาจัดหาภารกิจ基準 ตัวจัดตารางเวลา Runtime รับผิดชอบกระจายการคำนวณเป็นชุดไปยัง GPU หรือคลัสเตอร์แบบกระจาย โมดูลเฝ้าติดตามเก็บตัวชี้วัดกลับ บนวงปิดต้องมีบันทึกที่เล่นซ้ำได้: ซีดแบบสุ่ม งบประมาณการประเมิน ID ภารกิจ รุ่นฮาร์ดแวร์ และเงื่อนไขหยุด ข้อสรุปที่ว่า "ชั้นนอกชนะ" ทุกครั้งควรสามารถรันซ้ำได้ภายใต้เงื่อนไขเดียวกัน
เงื่อนไขขอบเขตและเส้นฐาน: การป้องกันสามชั้น
การป้องกันสัญญาณรบกวน:เมื่อการประเมินชั้นในผันผวนมาก ผลจากการรันครั้งเดียวเชื่อถือไม่ได้ ต้องรันอิสระหลายครั้งและรายงานช่วงความเชื่อมั่น ค่าความเหมาะสมอาจรวมด้วยค่าเฉลี่ย ค่ามัธยฐาน หรือควอนไทล์ที่แย่ที่สุด พร้อมแยกภารกิจฝึกออกจากภารกิจตรวจสอบ เพื่อป้องกันชั้นนอกเรียนรู้เกินพอดีกับซีดที่โชคดีเพียงไม่กี่ตัวการป้องกันต้นทุน:เมื่อภารกิจชั้นในมีต้นทุนสูง ให้คัดกรองหยาบด้วยแบบจำลองความแม่นต่ำหรือการประเมินตัวแทนก่อน แล้วจึงประเมินซ้ำอย่างแม่นยำสูงกับผู้สมัครจำนวนน้อยการป้องกันด้วยเส้นฐาน:ต้องเปรียบเทียบการตรึง F = 0.5 กับ DE แบบปรับตัวคลาสสิกบนเวทีเดียวกัน และใช้การทดลองตัดส่วนยืนยันว่าผลประโยชน์มาจากตัววิวัฒนาการชั้นนอกเอง ไม่ใช่จากจำนวนครั้งการประเมินที่มากขึ้น หากพื้นที่ค้นหาชั้นนอกเล็กเกินไป การปรับให้เหมาะสมแบบสองชั้นจะเสื่อมกลายเป็นการปรับพารามิเตอร์ด้วยมือ ในกรณีนั้นควรขยายพื้นที่การเข้ารหัส ไม่ใช่เพียงเพิ่มงบประมาณ
พิมพ์เขียวและกระบวนการทดลองการปรับให้เหมาะสมแบบสองชั้นภาพตัวอย่างใช้ค่าปัจจัยการกลายพันธุ์ F ของ DE เป็นกรณี: ชั้นในล็อกภารกิจ ขนาดมิติ งบประมาณการประเมิน และซีดแบบสุ่ม ให้เฉพาะกลยุทธ์ F ที่ส่งมาจากชั้นนอกเปลี่ยนแปลง พร้อมบันทึกค่าที่ดีที่สุด ความเร็วการลู่เข้า อัตราความสำเร็จ ปริมาณการละเมิดเงื่อนไข ไฮเปอร์โวลุ่ม และความหลากหลายของผู้สมัคร; ชั้นนอกเข้ารหัสได้ทั้ง F คงที่ F แบ่งช่วง หรือฟังก์ชันจัดตาราง จากนั้นแมปอย่างชัดแจ้ง ประเมินเป็นชุด และคัดเลือกเพื่ออัปเดต วงปิดยังต้องเก็บซีด งบประมาณ ID ภารกิจ ฮาร์ดแวร์ และเงื่อนไขหยุด เพื่อให้ข้อสรุปสามารถรันซ้ำได้