เมื่อขนาดประชากรขยายจากไม่กี่สิบเป็นหลายพันหลายหมื่น การคำนวณเชิงวิวัฒนาการคอขวดที่แท้จริงจะไม่ใช่ “หาแนวทางแก้ไขที่ดีได้หรือไม่” อีกต่อไป แต่เป็น “สามารถประเมินตัวเลือกที่มีศักยภาพได้มากพอภายในเวลาจำกัดหรือไม่” คำตอบเชิงวิศวกรรมที่ EvoX นำเสนอคือสองเส้นทางหลักที่เกื้อหนุนกัน ได้แก่ การคำนวณแบบเทนเซอร์ซึ่งเขียนลูปแบบอนุกรมทีละตัวใหม่ให้เป็นการดำเนินการเทนเซอร์แบบกลุ่ม สถาปัตยกรรมแบบรวมศูนย์จะแยกอัลกอริทึม ปัญหา เวิร์กโฟลว์ และการจัดตารางของ Runtime ออกจากกัน ทำให้กลไกแบบขนานนี้สามารถนำไปใช้ซ้ำกับอัลกอริทึมเชิงวิวัฒนาการและงานที่แตกต่างกันได้
ทำไมความหลากหลายจึงต้องการอัตราการประมวลผล
การค้นหาเชิงวิวัฒนาการพึ่งพาความหลากหลายของประชากร ยิ่งตัวเลือกกระจัดกระจายมากเท่าใด โอกาสที่จะหลุดออกจากจุดเหมาะสมที่สุดเฉพาะถิ่นก็ยิ่งสูงขึ้น แต่การ “รักษาความหลากหลาย” แท้จริงแล้วเป็นโจทย์เรื่องพลังการประมวลผล เพราะต้องสามารถประเมินและอัปเดตสถานะของตัวเลือกจำนวนมากได้ในทุก ๆ รุ่น หากวิธีการสร้างตัวเลือกยังถูกกำหนดไว้ล่วงหน้าโดยมนุษย์ และการประเมินยังคงทำทีละตัว ระบบก็จะวนซ้ำอยู่กับรูปแบบเดิม ๆ และผลประโยชน์จากความหลากหลายจะถูกหักลบด้วยคอขวดของอัตราการประมวลผล
วิวัฒนาการของวิธีการ: นำ “วิธีการสร้างตัวเลือก” เข้าสู่กระบวนการวิวัฒนาการด้วย
เมื่อขีดความสามารถด้านพลังการประมวลผลเปิดกว้างขึ้น EvoX ได้ยกระดับวัตถุที่ปรับให้เหมาะสมขึ้นไปอีกชั้น ไม่ได้เพียงแก้ปัญหาเท่านั้น แต่ยังนำวิธีการสร้างคำตอบที่เป็นตัวเลือกเข้ามาเป็นวัตถุของวิวัฒนาการด้วย นี่คือ วิวัฒนาการของวิธีการ ตัวอย่างเช่น MetaDE อัลกอริทึมชั้นในแก้ปัญหาจริงในขณะที่อัลกอริทึมชั้นนอกวิวัฒนาการการตั้งค่าและกลยุทธ์ของอัลกอริทึมชั้นใน (เช่น กลยุทธ์การกลายพันธุ์และไฮเปอร์พารามิเตอร์ของ Differential Evolution) พร้อมทั้งรันงานชั้นในจำนวนมากแบบขนานด้วย GPU เพื่อให้ประสิทธิภาพของงานย้อนกลับมาชี้แนะการเลือกการตั้งค่าของชั้นนอก AutoPSO และ EvoGO ยิ่งไปกว่านั้นยังใช้การประกอบส่วนประกอบของ Particle Swarm และใช้ผลตอบกลับจากประวัติเพื่อเรียนรู้วิธีการสร้างตัวเลือก ทำให้ก้าวข้ามจาก “ปรับพารามิเตอร์” ไปสู่ “ปรับโครงสร้างอัลกอริทึม” วิวัฒนาการสองชั้นทั้งภายในและภายนอกนี้ย่อมต้องการให้งานชั้นในจำนวนมากได้รับการประเมินและอัปเดตสถานะแบบกลุ่มในรุ่นเดียวกันหรือแม้แต่ในขณะเดียวกัน จึงตั้งข้อกำหนดที่สูงขึ้นต่ออัตราการประมวลผลและขีดความสามารถแบบขนาน
กราฟการคำนวณแบบเทนเซอร์: เปลี่ยนลูปให้เป็นการดำเนินการเทนเซอร์แบบกลุ่ม
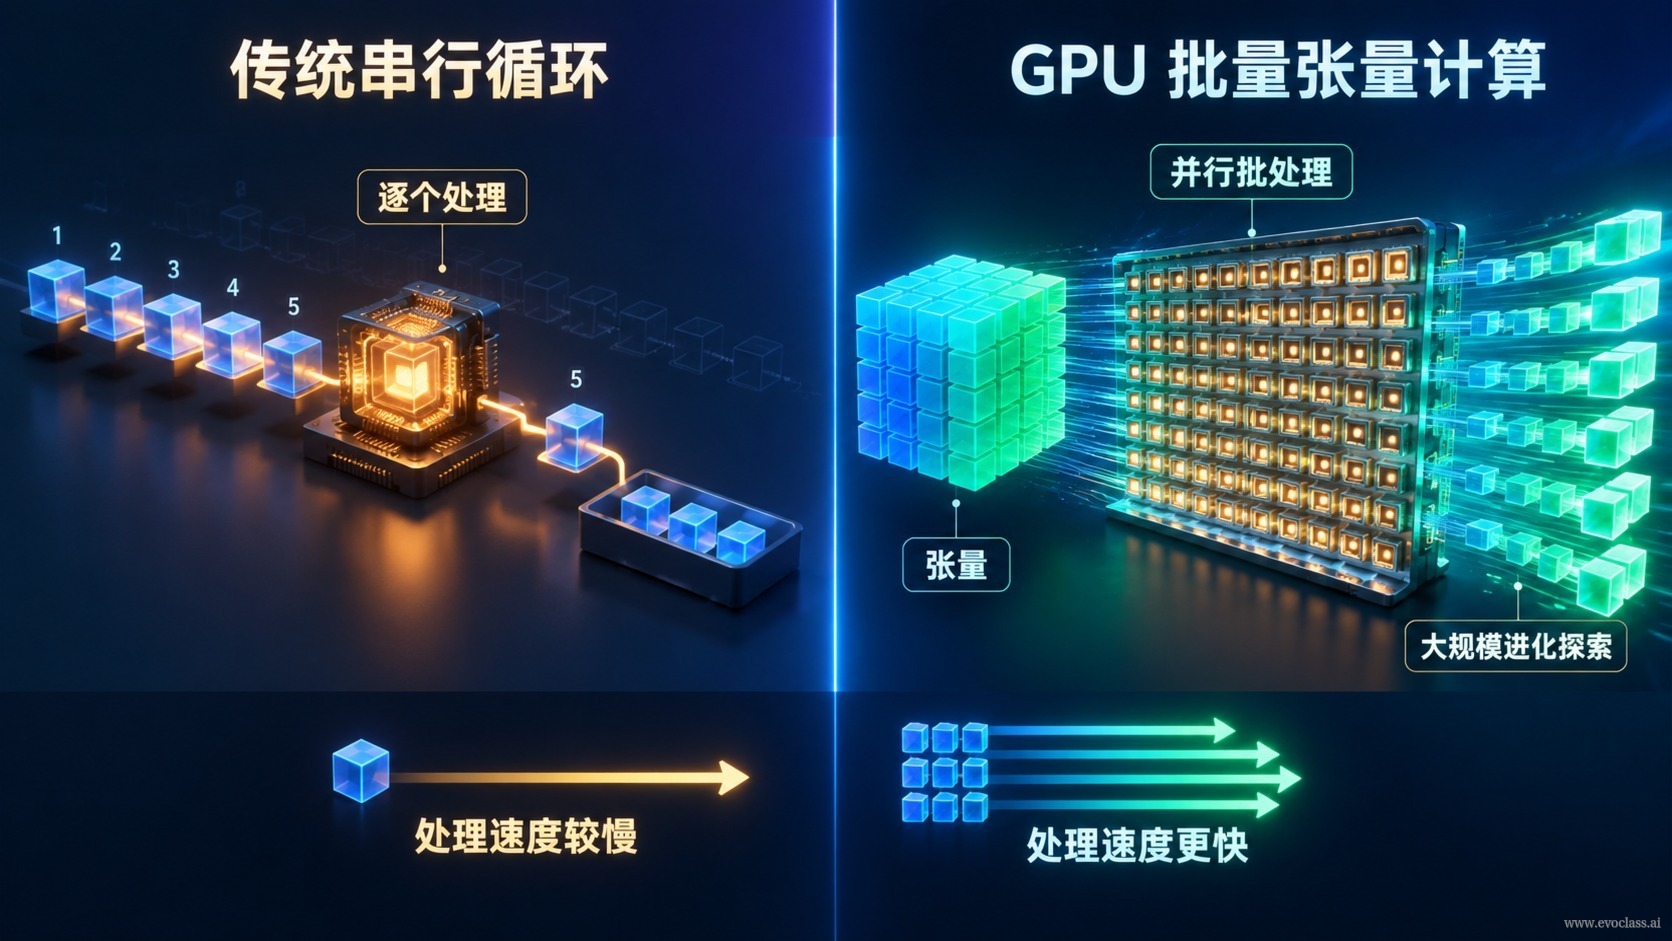
ลูป CPU แบบอนุกรมดั้งเดิมมักดำเนินการ “ประเมิน—บันทึก—อัปเดต” ทีละตัว โดยแต่ละครั้งจะเรียกใช้โอเปอเรเตอร์ขนาดเล็กเท่านั้น ซึ่งนำมาซึ่งต้นทุนสามประเภท ต้นทุนการจัดตารางสูง โอเปอเรเตอร์กระจัดกระจาย อัตราการใช้งาน GPU ต่ำ วิธีของกราฟการคำนวณแบบเทนเซอร์คือการนำ การดูแลรักษาประชากร การประเมินแบบกลุ่ม และการอัปเดตสถานะมาจัดระเบียบเป็นชุดของการดำเนินการเทนเซอร์แบบกลุ่ม ทำให้ตัวเลือกในรุ่นเดียวกันหรือแม้แต่หลายรุ่นถูกคำนวณแบบขนาน ตัวอย่างเช่น เมื่อรุ่น同一มีคำตอบที่เป็นตัวเลือก N ตัว การทำงานแบบอนุกรมจะวนซ้ำทีละตัว แต่การทำงานแบบเทนเซอร์จะจัดระเบียบประชากรให้เป็นเทนเซอร์เดียว และทำการประเมินแบบกลุ่มพร้อมการอัปเดตสถานะแบบขนานในครั้งเดียว จึงลดต้นทุนการจัดตารางและเพิ่มอัตราการใช้งาน GPU ได้อย่างมีนัยสำคัญ
สถาปัตยกรรมแบบรวมศูนย์: ทำให้กลไกแบบขนานนำกลับมาใช้ซ้ำได้
เพียงเขียนลูปใหม่ให้เป็นเทนเซอร์ยังไม่พอ หากอัลกอริทึม ปัญหา และตรรกะการจัดตารางผูกติดกัน การเปลี่ยนอัลกอริทึมเชิงวิวัฒนาการหรือเปลี่ยนประเภทของงานก็ต้องเขียนใหม่ทั้งหมด สถาปัตยกรรมแบบรวมศูนย์จึงแยก 算法、问题、工作流、Runtime 调度 โมดูลเหล่านี้ให้เป็นอิสระจากกัน ทำให้กลไกแบบขนานเชิงเทนเซอร์สามารถนำกลับมาใช้กับอัลกอริทึมเชิงวิวัฒนาการและงานที่แตกต่างกันได้ (เช่น สถานการณ์วิวัฒนาการของวิธีการอย่าง MetaDE, AutoPSO) พร้อมกับ การจัดตารางพลังการประมวลผลแบบต่างชนิด ซึ่งสามารถจัดการทรัพยากร เช่น CPU และ GPU ในระดับงานแบบกลุ่ม เพื่อรองรับการสำรวจแบบขนานที่ประกอบรวมได้และขยายได้
ทำไมนี่จึงเป็นขีดความสามารถระดับ “ฐานราก”
ฐานรากทางวิศวกรรมที่ GPU และโมเดลขนาดใหญ่นำมา ทำให้การคำนวณแบบกลุ่มเชิงเทนเซอร์ยกระดับจากการปรับให้เหมาะสมเฉพาะจุดขึ้นเป็นขีดความสามารถพื้นฐานที่รองรับการสำรวจเชิงวิวัฒนาการระดับระบบ กล่าวอีกนัยหนึ่ง การคำนวณแบบเทนเซอร์ตอบโจทย์ “ทำงานได้เร็ว” ส่วนสถาปัตยกรรมแบบรวมที่เปิดกว้างและแยกส่วนตอบโจทย์ “เปลี่ยนได้คล่อง” โดยอย่างแรกมอบอัตราการประมวลผล และอย่างหลังมอบขอบเขตการนำกลับมาใช้ซ้ำที่ประกอบรวมได้และขยายได้ เมื่อทั้งสองรวมกัน การสำรวจเชิงวิวัฒนาการแบบขนานที่มีความเข้มข้นสูงและหลากหลายสูงจึงกลายเป็นขีดความสามารถทางวิศวกรรมได้จริง
แผนภาพเปรียบเทียบสถาปัตยกรรมลูปแบบอนุกรมกับการคำนวณเทนเซอร์แบบกลุ่มด้วย GPUด้านซ้าย: CPU แบบอนุกรมดั้งเดิมดำเนินการ “ประเมิน—บันทึก—อัปเดต” ทีละตัว เรียกใช้โอเปอเรเตอร์ขนาดเล็กเท่านั้น ส่งผลให้ต้นทุนการจัดตารางสูง โอเปอเรเตอร์กระจัดกระจาย และอัตราการใช้งาน GPU ต่ำ ด้านขวา: จัดระเบียบการดูแลรักษาประชากร การประเมินแบบกลุ่ม และการอัปเดตสถานะเป็นชุดการดำเนินการเทนเซอร์ ทำการคำนวณตัวเลือกในรุ่นเดียวกันหรือหลายรุ่นในครั้งเดียว และแยกออกจากการจัดตารางของ Runtime ทำให้กลไกแบบขนานนำกลับมาใช้กับอัลกอริทึมและงานต่างๆ ได้