อัลกอริทึมวิวัฒนาการแบบดั้งเดิมทำงานภายใต้กลไกการสร้างที่ตายตัวกล่าวคือ กฎอย่างการคัดเลือก การผสมข้าม และการกลายพันธุ์ ซึ่งเป็น «วิธีสร้างคำตอบ» ถูกกำหนดไว้ล่วงหน้าโดยมนุษย์ การค้นหาจึงเคลื่อนที่อยู่แค่ในปริภูมิคำตอบ และสิ่งที่ถูกปรับให้เหมาะสมก็คือคำตอบที่เป็นตัวเลือกเสมอ เมื่อพลังการประมวลผลขยาย規模ขึ้น ข้อกำหนดล่วงหน้านี้กลับกลายเป็นเพดาน — หากวิธีการสร้างตัวเลือกไม่เปลี่ยนแปลง ระบบก็ได้แต่ย่ำอยู่กับสูตรเดิม
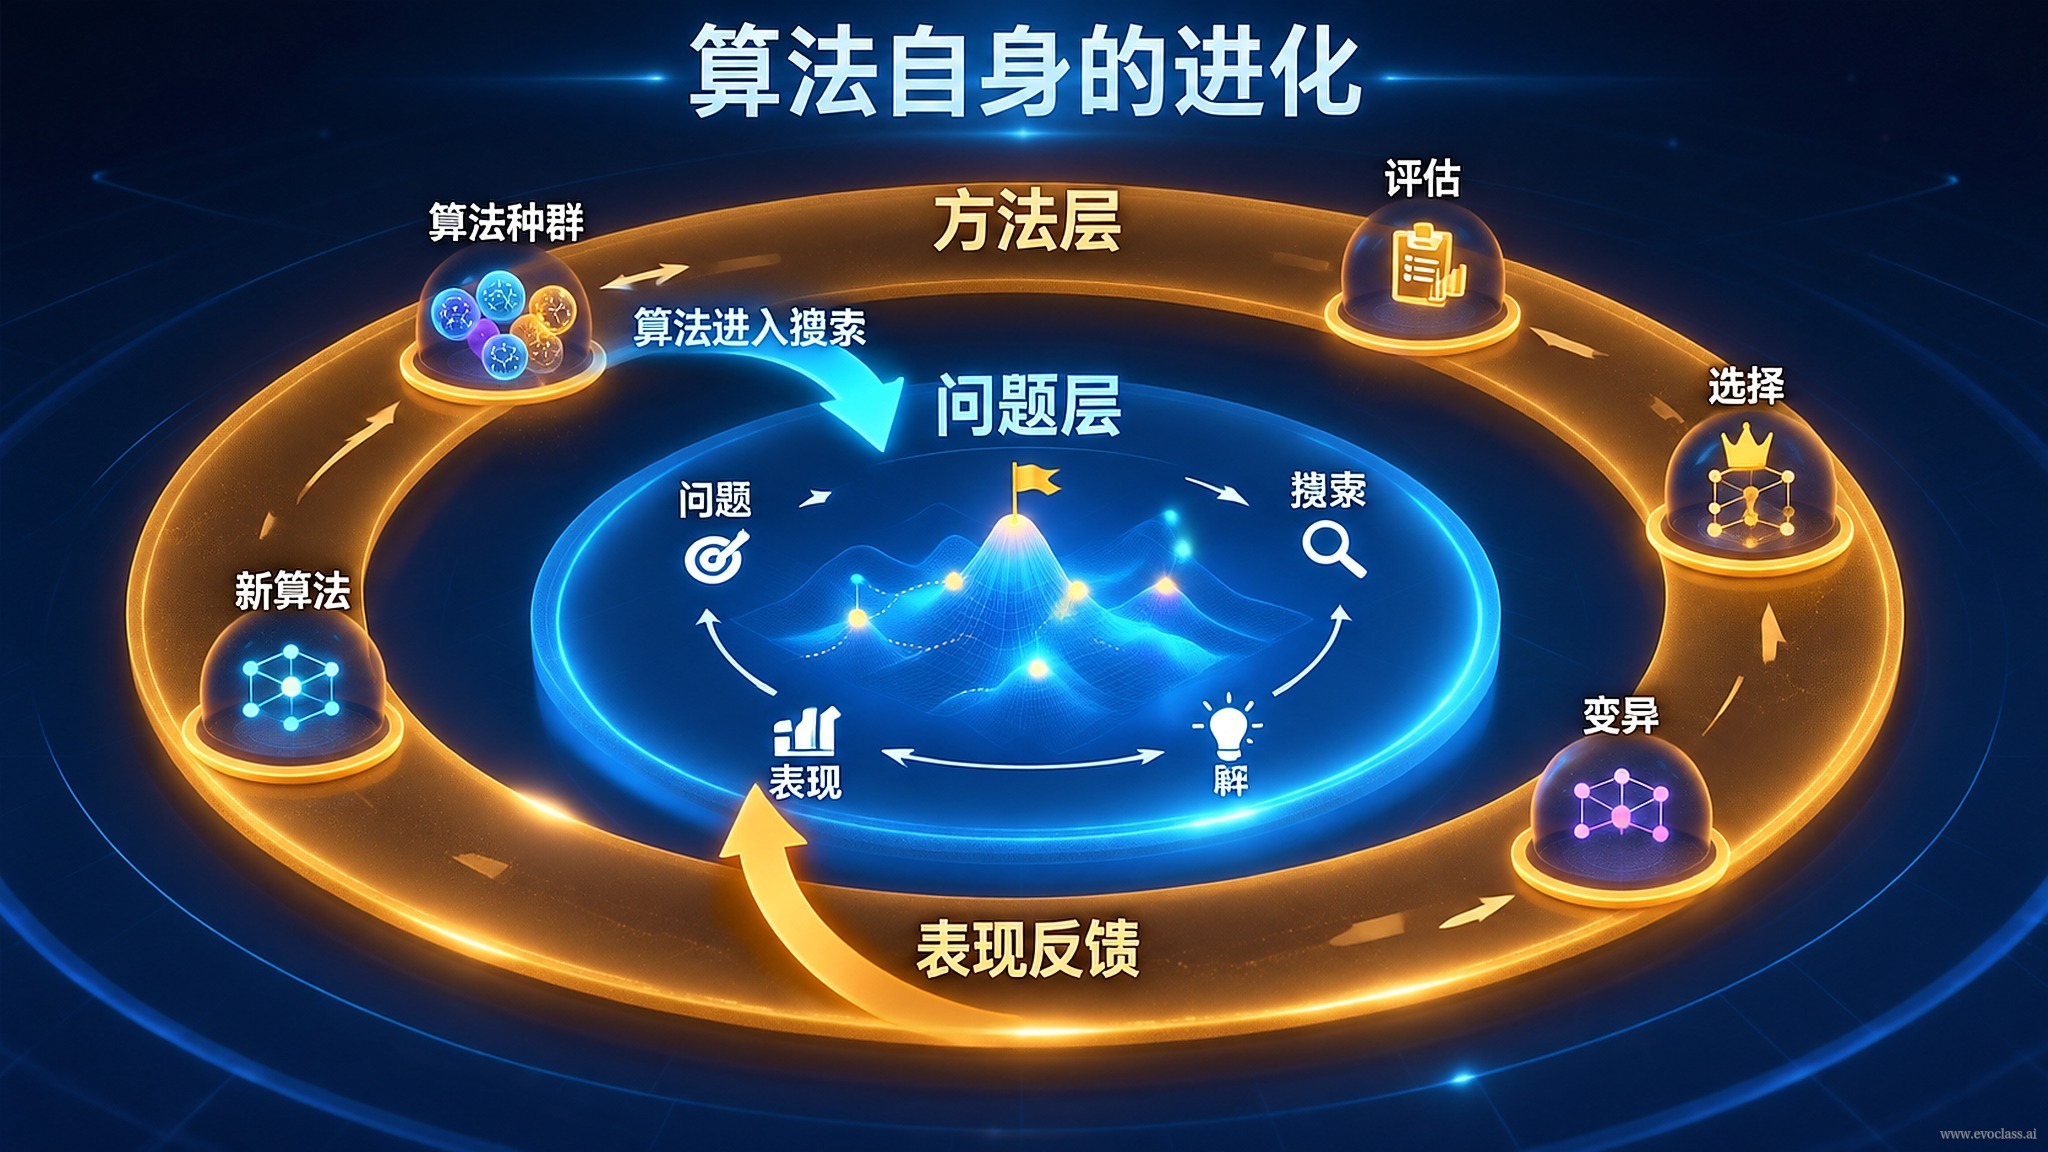
วิวัฒนาการของวิธีการ (Meta-Evolution)ยกระดับปัญหาให้สูงขึ้นหนึ่งชั้น: อัลกอริทึมไม่เพียงส่งออกคำตอบที่ดีขึ้น แต่ยังปรับปรุงสิ่งที่ใช้สร้างคำตอบอย่างต่อเนื่องผ่านการค้นหาในชั้นนอก ได้แก่กลยุทธ์ พารามิเตอร์ และองค์ประกอบเพื่อเสร็จสิ้นวิวัฒนาการจาก «การหาคำตอบ» สู่ «การปรับปรุงวิธีการ» EvoX คือผลงานที่เดินหน้าไปตามเส้นทางนี้ โดยนำตัววิธีการสร้างตัวเลือกเอง (เช่น กลยุทธ์การกลายพันธุ์และการตั้งค่าพารามิเตอร์ของ Differential Evolution) เข้ามาเป็นวัตถุของวิวัฒนาการ
ตรรกะสองชั้น: ชั้นในหาคำตอบ ชั้นนอกรีไฟน์วิธีการ
- ชั้นใน: ใช้วิธีการปัจจุบันแก้ปัญหาเฉพาะเจาะจง เพื่อสร้างคำตอบตัวเลือก
- ชั้นนอก: อาศัยสัญญาณป้อนกลับ เช่น คุณภาพคำตอบ สัญญาณความชอบ ความเสถียร หรือต้นทุน เพื่อปรับปรุงวิธีการที่จะใช้ในรอบถัดไป
- สิ่งที่ถูกยกขึ้นสู่ปริภูมิการค้นหาไม่ใช่คำตอบใดคำตอบหนึ่ง แต่คือตัวกลไกการสร้างตัวเลือกเองด้วยเหตุนี้เอง มันจึงกลายเป็นวัตถุที่สามารถประเมินได้ คัดเลือกได้ และอัปเดตได้
การปรับให้เหมาะสมตามความชอบควรอยู่ชั้นไหน
การปรับให้เหมาะสมตามความชอบสามารถเข้าร่วมสัญญาณป้อนกลับชั้นนอกได้ แต่ต้องแยกเป้าหมายสองประเภทออกจากกัน:การประเมินคำตอบปัจจุบันและการปรับปรุงวิธีการสร้างคำตอบการตีความ «คำตอบนี้ถูกใจกว่าตรง ๆ » เป็น «กลยุทธ์นี้ดีกว่า» เท่ากับเอาความชอบต่อคำตอบมาแอบอ้างเป็นคุณภาพของวิธีการ การค้นหาชั้นนอกจะถูกเสียงรบกวนจากผลลัพธ์ครั้งเดียวฉุดให้หลงทาง
ได้อะไรมา ต้องแลกด้วยอะไร
การเปลี่ยนแปลงนี้ผลักดันการออกแบบอัลกอทึมจากการปรับพารามิเตอร์ด้วยมือแบบครั้งเดียวไปสู่การปรับตัวได้อย่างยั่งยืน แต่ราคาที่ต้องจ่ายก็ชัดเจนเช่นกัน:ปริภูมิการค้นหาบวมตัว(ปริภูมิของวิธีการใหญ่กว่าปริภูมิของคำตอบมาก)ต้นทุนการประเมินสูงขึ้น(วิธีการตัวเลือกแต่ละชุดต้องรันงานชั้นใน มักต้องพึ่งการประเมินแบบขนานเป็นชุดด้วย GPU เพื่อเฉลี่ยต้นทุน)ความซับซ้อนในการตรวจสอบเพิ่มขึ้น(การปรับปรุงชั้นนอกรั่วไหลไปยังกรณีอื่นจริงหรือไม่ ต้องมีออกแบบการตรวจสอบที่เป็นอิสระ)
แผนภาพตรรกะวิวัฒนาการสองชั้นแผนภาพแบ่งวิวัฒนาการออกเป็นสองชั้น: ชั้นในใช้วิธีการปัจจุบันแก้ปัญหาเฉพาะเจาะจงและสร้างคำตอบตัวเลือก ส่วนชั้นนอกอาศัยสัญญาณป้อนกลับ เช่น คุณภาพคำตอบ ความชอบ ความเสถียร หรือต้นทุน เพื่อปรับปรุงกลยุทธ์ พารามิเตอร์ และองค์ประกอบที่ใช้สร้างตัวเลือกในรอบถัดไป วัตถุที่ถูกค้นหาจึงยกระดับจากคำตอบขึ้นมาเป็นกลไกการสร้างตัวเลือก