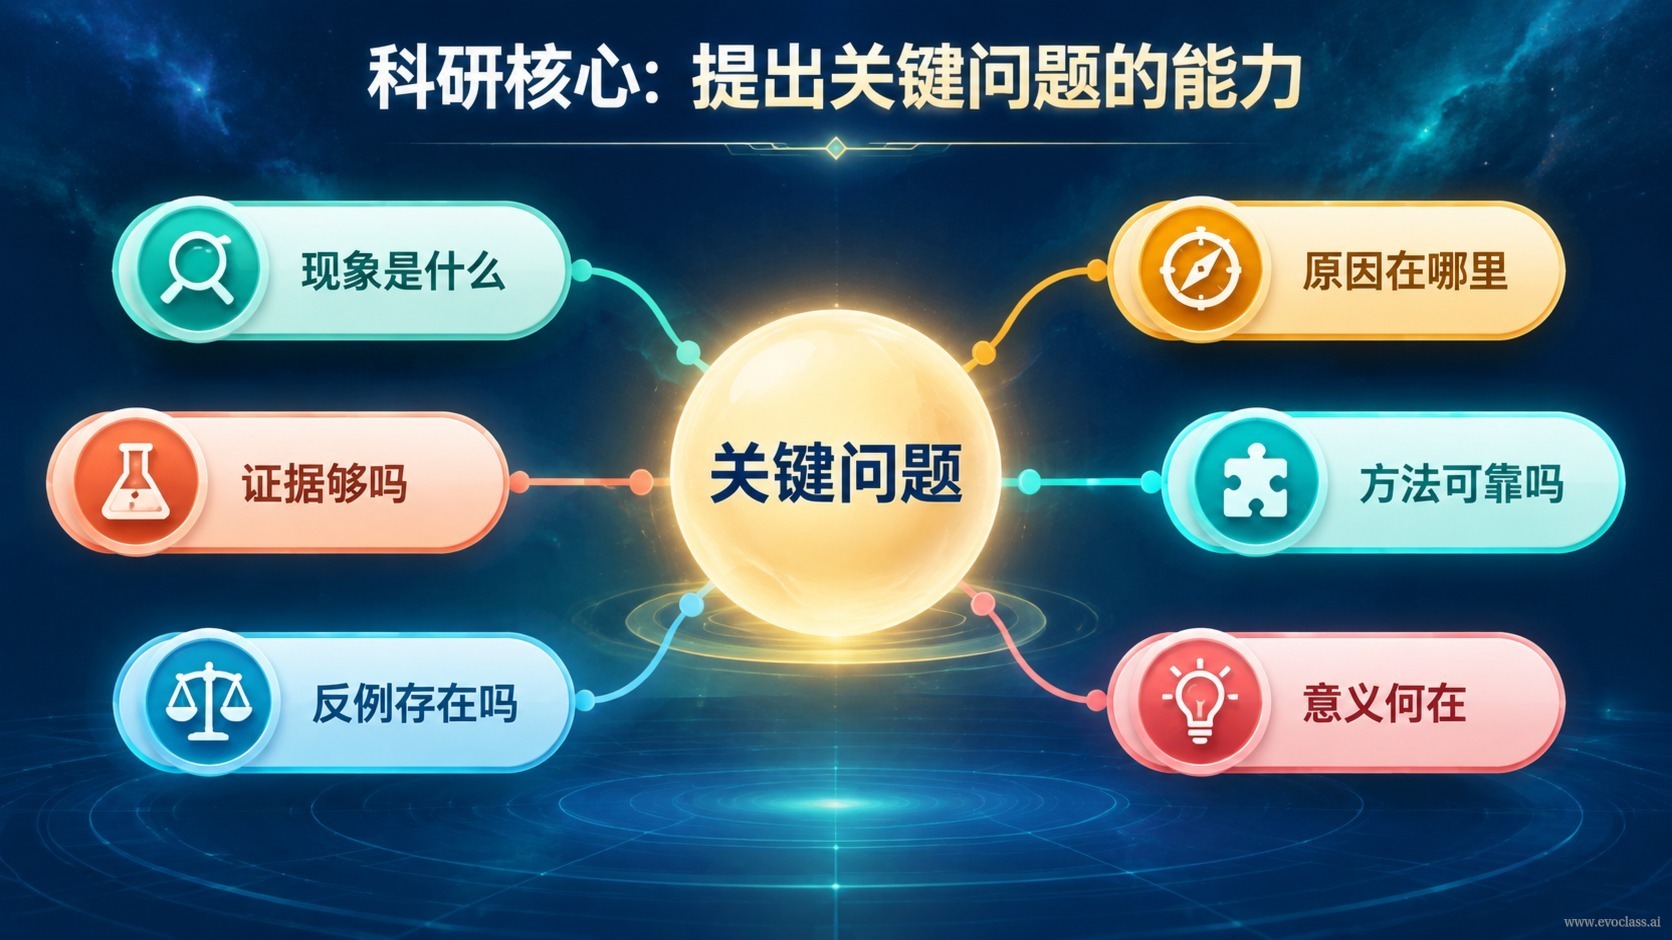
ในงานวิจัยแบบ AI Native การเขียนโปรแกรมอัตโนมัติและความสามารถของโมเดลขนาดใหญ่ได้ลดต้นทุนของ "การสร้างคำตอบ" ลงอย่างมาก ทั้งการสร้างโค้ด การค้นหาแนวทาง และการรันการทดลอง ล้วนมอบให้ AI ทำได้ทั้งหมด เมื่อคำตอบกลายเป็นสิ่งราคาถูก จุดเน้นของงานวิจัยจึงไม่ใช่ "ทำได้หรือไม่" อีกต่อไป แต่เป็นคุ้มค่าที่จะทำหรือไม่ และควรทำไปในทิศทางใด——นี่เองคือการตั้งคำถามสำคัญนั่นเอง
คำถามสำคัญหนึ่งข้อโดยปกติต้องระบุอะไรให้ชัดเจน
การตั้งคำถามสำคัญไม่ใช่การซักถามรายละเอียดการนำไปใช้ แต่เป็นการเปลี่ยนสัญชาตญาณที่คลุมเครือให้เป็นโครงสร้างการวิจัยที่ตรวจสอบได้ วิวัฒน์ได้ และแบ่งงานได้อย่างน้อยต้องนิยามสิ่งต่อไปนี้ให้ชัดเจน:
- เป้าหมายที่แท้จริงและความขัดแย้งระหว่างหลายเป้าหมาย: ปริมาณที่ต้องการปรับปรุงจริง ๆ คืออะไร? จะเลือกอย่างไรระหว่างเป้าหมายหลายข้อ และข้อใดมาก่อน?
- ข้อจำกัดที่ต่อรองไม่ได้: เงื่อนไขใดเป็นขอบเขตแข็งที่ไม่มีแนวทางใดฝ่าฝืนได้?
- ตัวชี้วัดการประเมินที่สังเกตได้: วัดด้วยปริมาณใดและภายใต้เงื่อนไขใด ข้อสรุปจึงจะหนักแน่น?
- ขอบเขตของพื้นที่ตัวเลือก: ขอบเขตที่เป็นไปได้ของการค้นหาและวิวัฒนาการกว้างเพียงใด และต้องการความหลากหลายและความทนทานแบบใด?
- โปรโตคอลการตรวจสอบและเกณฑ์ตัดสินความล้มเหลว: ใช้งบประมาณการประเมินเท่าใด ตรวจสอบตามกระบวนการใด และผลลัพธ์แบบใดควรถูกตัดสินว่าล้มเหลว?
คุณภาพของคำถามกำหนดคุณภาพของพื้นที่คำตอบ
พื้นที่คำตอบที่ AI สำรวจถูกกำหนดขอบเขตไว้ด้วยนิยามของปัญหา ยิ่งนิยามปัญหาชัดเจน การค้นหาและวิวัฒนาการก็ยิ่งมีแนวโน้มตกอยู่ในพื้นที่ที่มีความหมาย และผลลัพธ์ก็ยิ่งมีแนวโน้มอธิบายได้และนำกลับมาใช้ซ้ำได้; ยิ่งนิยามปัญหาคลุมเครือ โมเดลก็ยิ่งทำได้เพียงลองผิดลองถูกแบบสุ่มในพื้นที่ที่ใหญ่เกินไป ผลลัพธ์มักดูเหมือนเป็นไปได้แต่กลับไม่สามารถตกผลึกได้ ยกตัวอย่าง "ใช้ EvoX ทำการปรับให้เหมาะสม" คำถามสำคัญควรแปลงเป็น: "ความขัดแย้งที่แท้จริงคืออะไร? จะวัดเป้าหมายและข้อจำกัดเป็นปริมาณได้อย่างไร? งบประมาณการประเมินและมาตรฐานการตรวจสอบคืออะไร? ต้องการความหลากหลายและความทนทานแบบใด? ผลลัพธ์แบบใดควรถูกตัดสินว่าล้มเหลว?" เช่นนี้ AI จึงจะสร้างคำตอบได้อย่างมีประสิทธิภาพ ขณะที่มนุษย์กำกับทิศทาง
การแบ่งงานมนุษย์-เครื่องจักรและรสนิยมหลักของนักวิจัย
หัวใจของการแบ่งงานมนุษย์-เครื่องจักรคือ:AI ขยายพื้นที่คำตอบและเส้นทางการดำเนินการ ส่วนมนุษย์กำกับทิศทาง เกณฑ์การเลือก และความหมายเชิงวิทยาศาสตร์ ในแนวปฏิบัติวิวัฒนาการต่อเนื่องระดับระบบอย่าง Genesis จุดนี้ยิ่งชัดเจนเป็นพิเศษ——การแก้ไขที่เป็นตัวเลือกต้องผ่านการคอมไพล์ การทดสอบ และการรับรองจากชั้นบน จึงจะเข้าสู่เวอร์ชันโครงการที่ได้รับการยอมรับและกลายเป็นรากฐานทางประวัติศาสตร์ของงานต่อ ๆ ไป หากคำถามสำคัญไม่ได้นิยามโปรโตคอลการประเมินและเกณฑ์ตัดสินความล้มเหลวไว้อย่างชัดเจน ด่านการรับรองก็ไม่มีทางตัดสินได้ ผลงานของ AI ก็จะคงอยู่เพียงโค้ดที่ใช้ได้ครั้งเดียว ไม่สามารถสะสมต่อเนื่องข้ามบริบทและรอบงานได้
ดังนั้น รสนิยมหลักของนักวิจัยจึงแสดงออกเป็นการตัดสินสามประการ:อะไรที่คุ้มค่าจะถาม หลักฐานแบบใดที่ยอมรับได้ แนวทางใดที่แม้เป็นไปได้แต่ไม่คุ้มค่าจะทำ ในแนวปฏิบัติกับ EvoX คำถามสำคัญควรนำไปสู่เวิร์กโฟลว์ที่รันได้ ประเมินได้ และทำซ้ำได้ ไม่ใช่เพียงมุ่งหาผลลัพธ์การนำไปใช้แบบครั้งเดียว
เบาะแสเพิ่มเติม: การแบ่งงานมนุษย์-เครื่องจักรและรสนิยมหลักของนักวิจัย——AI ขยายพื้นที่คำตอบ มนุษย์รักษาทิศทาง เกณฑ์การเลือก และความหมายเชิงวิทยาศาสตร์
แผนภาพความคิดรายการคำถามสำคัญแผนภาพความคิดนี้แตกคำถามสำคัญออกเป็นเป้าหมายที่แท้จริงและความขัดแย้งระหว่างหลายเป้าหมาย ข้อจำกัดแข็งที่ต่อรองไม่ได้ ตัวชี้วัดการประเมินที่สังเกตได้ ขอบเขตของพื้นที่ตัวเลือก และโปรโตคอลการตรวจสอบกับเกณฑ์ตัดสินความล้มเหลว โดยอธิบายว่าคุณภาพของคำถามกำหนดว่า AI จะค้นหาและวิวัฒนาการไปในพื้นที่ใด: ยกตัวอย่างการปรับให้เหมาะสมด้วย EvoX มีเพียงการระบุความขัดแย้ง การวัดเป็นปริมาณ และมาตรฐานการรับรองให้ชัดเจน ผลลัพธ์จึงมีแนวโน้มจะอธิบายได้และนำกลับมาใช้ซ้ำได้